Le modèle instruit¶
Toutes les mesures de ce chapitre utilisent l'effort de raisonnement maximal
(reasoning_effort=100), temperature=1.0 et top_p=0.95.
Le tableau de comparaison¶
Les concurrents : Opus-5, GPT-5.6 Sol, Kimi-K3 (K3), GLM-5.3, et les deux prédécesseurs DeepSeek-V4-Pro et DeepSeek-V4-Flash. Le meilleur score de chaque ligne est en gras.
Raisonnement¶
| Benchmark | Opus-5 | GPT-5.6 Sol | K3 | GLM-5.3 | V4-Pro | V4-Flash | V4.1-Flash |
|---|---|---|---|---|---|---|---|
| GPQA Diamond (Pass@1) | 93,4 | 94,1 | 92,9 | 88,1 | 92,4 | 89,9 | 90,9 |
| HLE (Pass@1) | 56,3 | 44,5 | 43,5 | 42,0† | 42,7† | 37,8† | 36,8 (39,1†) |
| Codeforces (Elo) | — | — | — | — | 3 348 | 3 289 | 3 471 |
| MathArena Apex (Pass@1) | — | — | 65,6 | — | 65,3 | 58,6 | 65,6 |
† sous-ensemble textuel de HLE.
Agentique¶
| Benchmark | Opus-5 | GPT-5.6 Sol | K3 | GLM-5.3 | V4-Pro | V4-Flash | V4.1-Flash |
|---|---|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 89,1 | 88,8 | 88,3 | 88,2 | 87,9 | 82,7 | 90,6 |
| Terminal-Bench 3.0 | 43,3 | 34,4 | 17,7 | 28,3 | 11,8 | 7,6 | 30,0 |
| Terminal-Bench 4.0 | 51,8 | 39,9 | 12,6 | 37,9 | 12,4 | 7,0 | 31,2 |
| DeepSWE v1.1 (résolu) | 74,0 | 73,0 | 67,5 | 66,9 | 62,7 | 54,4 | 74,2 |
| ProgramBench (Almost@1) | 37,0 | 23,0 | 17,5 | 19,0 | 15,5 | — | 20,3 |
| NL2Repo-Bench | 75,3 | 56,8 | 58,0 | 58,0 | 61,5 | 54,2 | 65,4 |
| CyberGym (Pass@1) | — | 84,5 | 80,0 | 84,5 | 83,3 | 76,7 | 88,1 |
| SEC-Bench Pro (Pass@1) | — | 74,3 | — | — | 56,4 | 30,9 | 62,8 |
| ExploitGym (Pass@1) | 22,1 | 33,7 | — | 15,0 | 5,4 | 1,8 | 15,3 |
| HLE avec outils | 63,6 | — | 59,8 | 62,5 | 60,0 | 51,5 | 63,9 |
| AutomationBench | 50,3 | 45,8 | 46,7 | 48,8 | 43,2 | 37,7 | 54,8 |
| Agents' Last Exam | 28,6 | 26,7 | 27,6 | 28,5 | 25,7 | 25,2 | 31,8 |
| Chartography avec outils | 84,0 | 79,9 | 68,1 | — | — | — | 78,9 |
| BabyVision avec outils | 94,1 | 88,9 | 85,7 | — | — | — | 89,6 |
| ZeroBench-main (Pass@5) | 52,0 | 53,0 | 41,0 | — | — | — | 49,0 |
Une divergence entre les deux sources officielles
La carte de modèle publiée sur Hugging Face donne 64,0 pour NL2Repo-Bench, là où le rapport technique donne 65,4. Le tableau ci-dessus retient la valeur du rapport technique, source primaire.
L'écart est mineur mais il illustre que même les documents officiels d'un même modèle ne sont pas parfaitement cohérents entre eux.
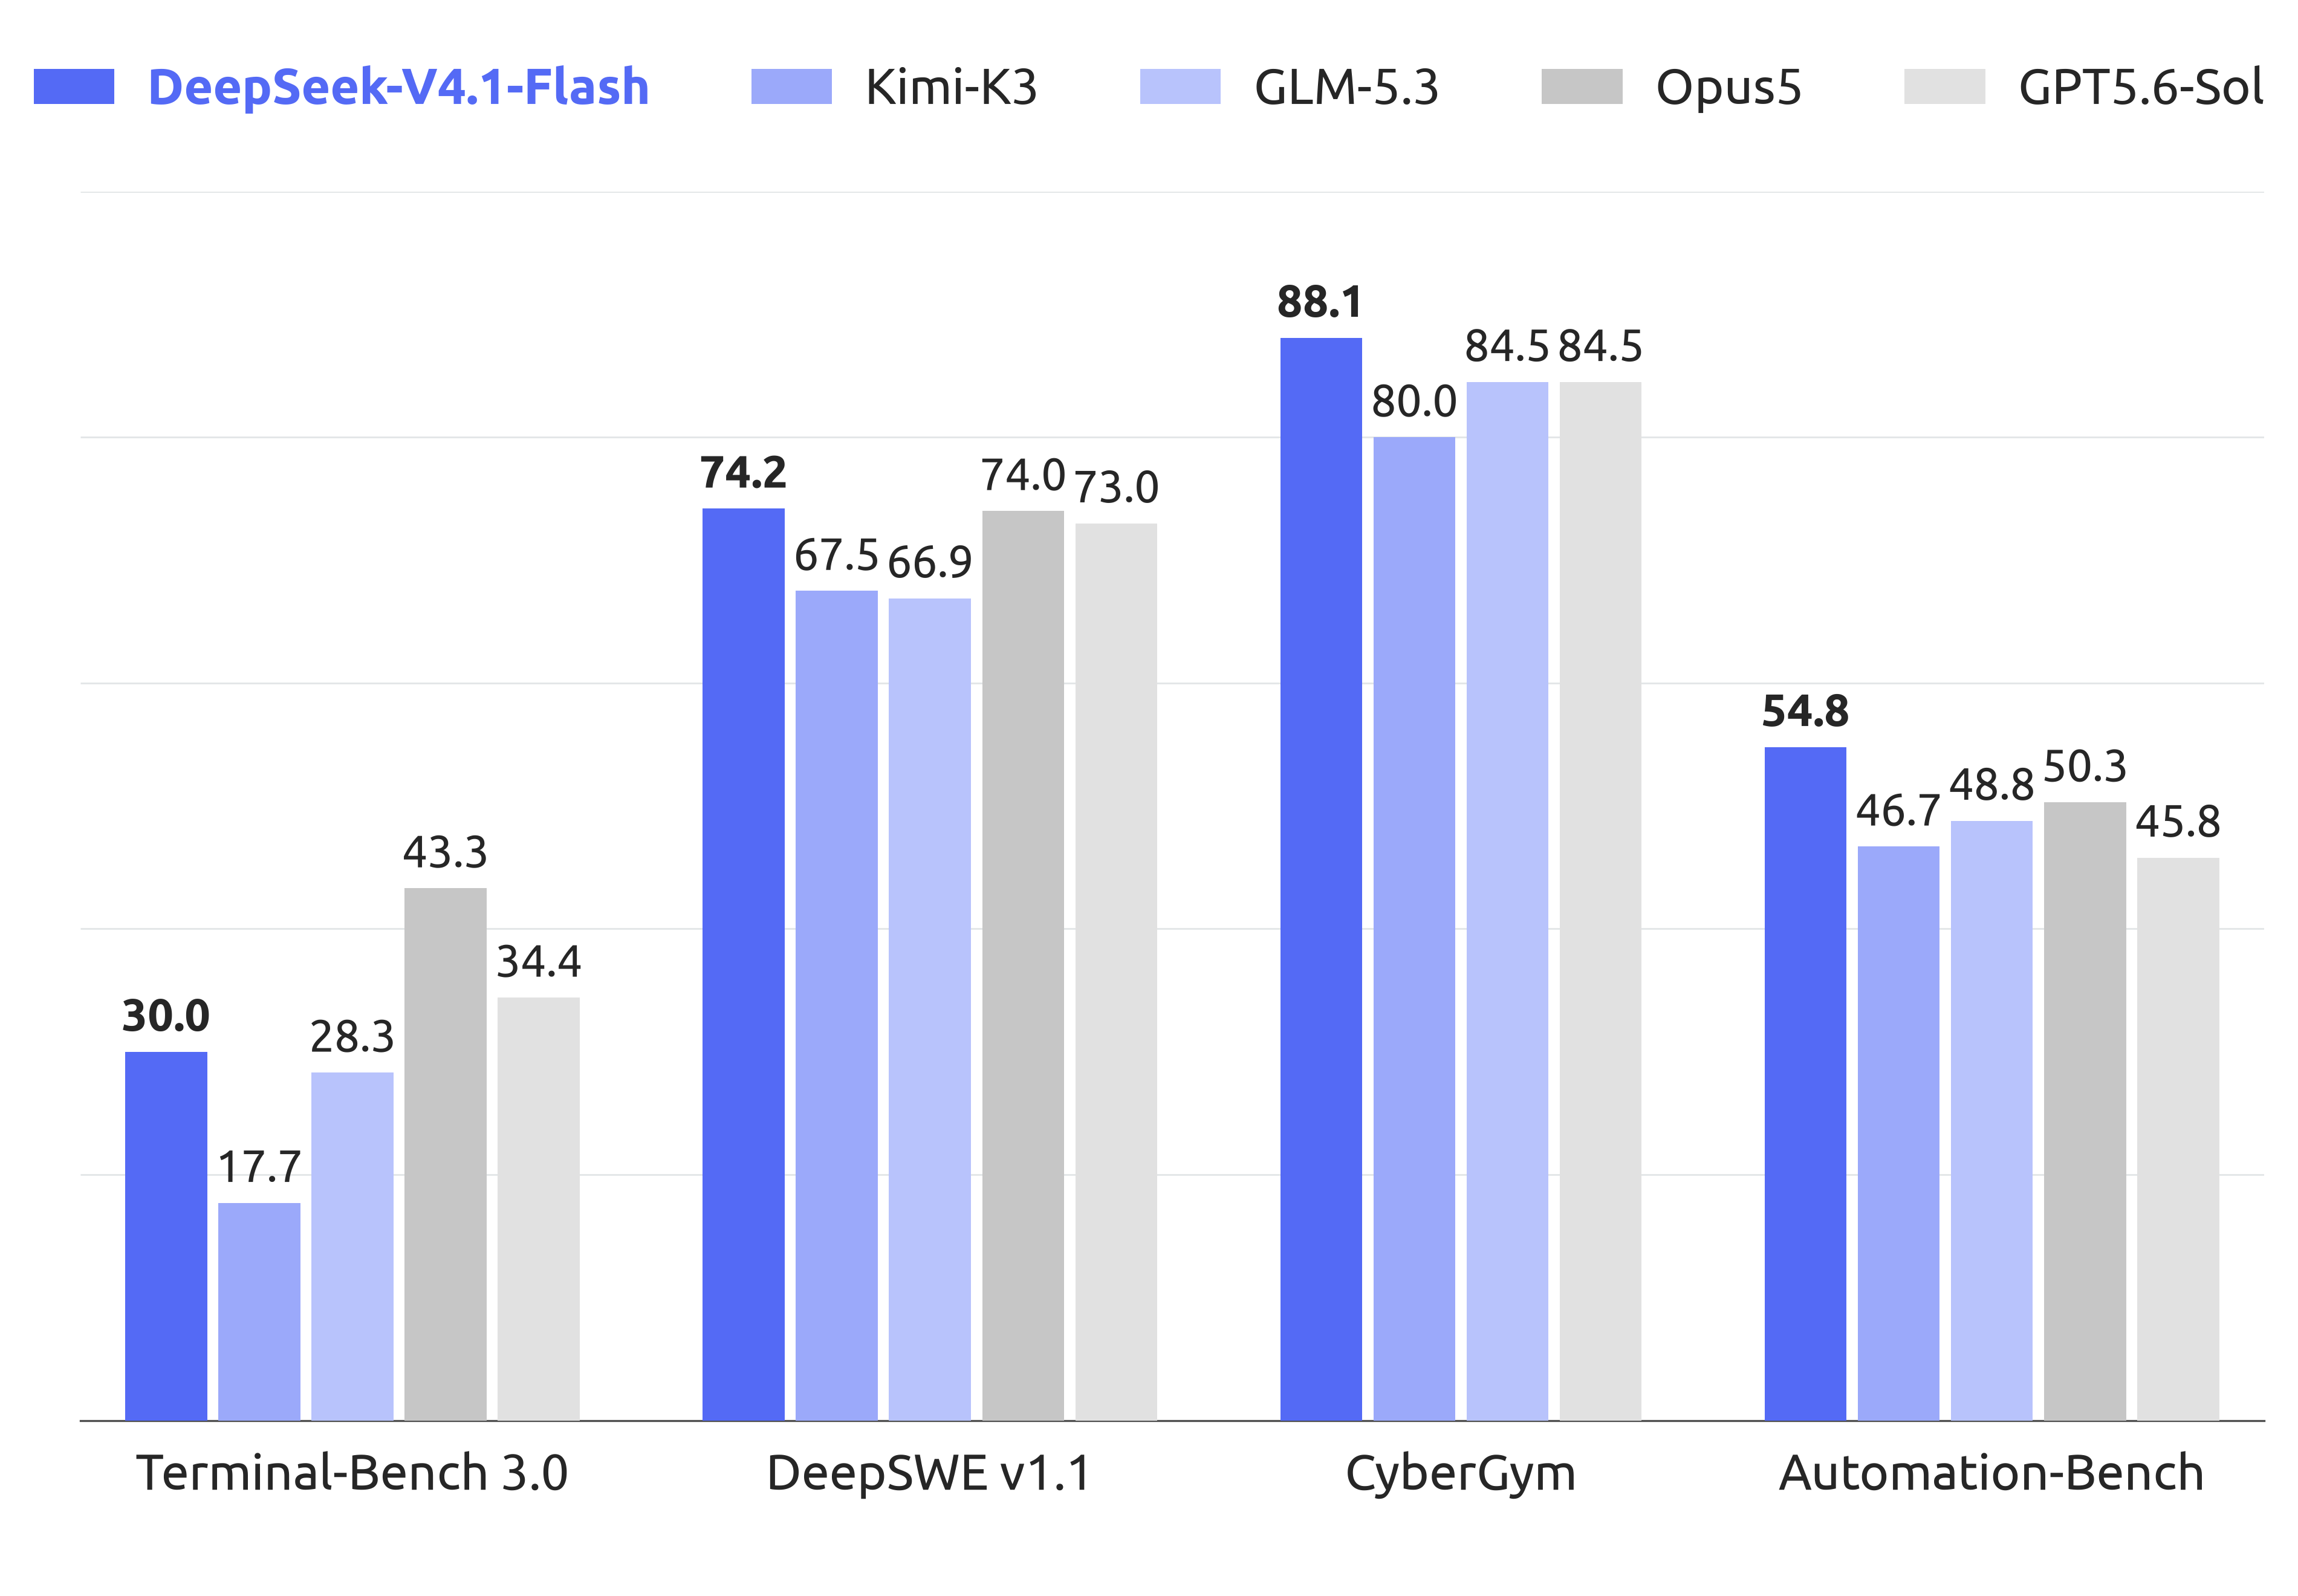
Figure 1(a) du rapport technique de DeepSeek. Quatre benchmarks agentiques, cinq modèles. Source : DeepSeek-AI, 2026 — donc mesures du constructeur.
Comment la lire : l'axe vertical n'est pas gradué, seules les valeurs inscrites au-dessus des barres sont exploitables. La barre Opus-5 est absente sur CyberGym, faute de donnée. À porter au crédit de la figure : elle inclut Terminal-Bench 3.0, où le modèle perd nettement (30,0 contre 43,3), plutôt que de ne retenir que les benchmarks favorables. Elle omet en revanche Terminal-Bench 4.0, où l'écart est encore plus large — le tableau ci-dessus, lui, l'inclut.
Lecture du profil¶
Ce qui est frappant¶
Le modèle bat les modèles fermés de pointe sur les tâches agentiques courantes. Terminal-Bench 2.1 à 90,6 contre 89,1 pour Opus-5. DeepSWE v1.1 à 74,2 contre 74,0. AutomationBench à 54,8 contre 50,3. Agents' Last Exam à 31,8 contre 28,6.
Pour un modèle à 16 G de paramètres activés, publié sous licence MIT avec ses poids, c'est le résultat central du rapport.
En sécurité offensive, il est en tête des modèles ouverts. CyberGym à 88,1, premier de tous les modèles comparés, DeepSeek compris. Le rapport ajoute une mise en garde explicite sur la nature à double usage de ces capacités et invite la communauté à les appliquer de façon responsable — recherche défensive, correction de vulnérabilités.
Le Codeforces à 3 471 dépasse les deux prédécesseurs, dont V4-Pro qui est trois fois plus gros. C'est un benchmark interne à DeepSeek, ce qui invite à la prudence, mais le classement relatif entre modèles DeepSeek reste informatif.
Où le modèle décroche¶
HLE : 36,8 contre 56,3 pour Opus-5. C'est l'écart le plus large du tableau, et le modèle est même en dessous de son propre prédécesseur V4-Flash (37,8) sur le sous-ensemble textuel — quoique la comparaison soit faussée, les deux chiffres ne portant pas sur le même sous-ensemble.
HLE mesure la connaissance experte de très haut niveau. C'est la même faiblesse que SimpleQA sur le modèle de base : la capacité de mémorisation ne peut pas être compensée par le post-entraînement.
L'écart se referme massivement dès qu'on donne des outils au modèle : HLE avec outils à 63,9, meilleur score du tableau, contre 63,6 pour Opus-5.
Ce que ce contraste dit du modèle
36,8 sans outils, 63,9 avec. L'écart de 27 points est le résumé le plus concis de ce qu'est DeepSeek-V4.1-Flash : un modèle qui sait chercher plutôt qu'un modèle qui sait.
C'est précisément le profil que son architecture impose — peu de paramètres activés, énormément de contexte — et le post-entraînement l'assume au lieu de le combattre.
Terminal-Bench 3.0 et 4.0. 30,0 et 31,2 contre 43,3 et 51,8 pour Opus-5. Ces benchmarks demandent des connaissances de domaine de niveau expert dans des tâches scientifiques. DeepSeek reconnaît explicitement l'écart :
Section 1
« Cependant, un écart avec les modèles géants subsiste sur les tâches agentiques orientées science, comme Terminal-Bench 4.0, qui exigent une connaissance de domaine de niveau expert. »
À noter tout de même : 30,0 et 31,2 contre 11,8 et 12,4 pour V4-Pro, et 12,6 pour Kimi-K3. Le modèle est très loin d'Opus-5 mais deux à trois fois meilleur que tous les autres modèles ouverts.
ExploitGym : 15,3 contre 33,7. L'écart avec GPT-5.6 Sol est important, alors même que le modèle domine CyberGym. Les deux benchmarks mesurent des choses différentes : trouver des vulnérabilités et les transformer en attaques réelles.
Le multimodal. Chartography, BabyVision et ZeroBench placent le modèle devant Kimi-K3 mais derrière Opus-5 et GPT-5.6 Sol de 4 à 5 points. DeepSeek le reconnaît sans détour.
L'affirmation la plus forte du rapport¶
Section 1
« Ces résultats indiquent que DeepSeek-V4.1-Flash peut déjà égaler les modèles fermés de pointe sur la grande majorité des benchmarks, et est capable d'accomplir plus de 95 % des tâches du monde réel. »
Ce « plus de 95 % » n'est étayé par aucune mesure dans le rapport. Aucune méthodologie n'est donnée pour définir ce qu'est une « tâche du monde réel », ni comment le pourcentage a été obtenu.
Il est à classer comme une affirmation commerciale, pas comme un résultat.
Chapitre suivant : Harnais et multi-agent