Le palmarès
Onze approches ont franchi la ligne d'arrivée et écrit leur ligne au classement. Quatre autres — gbdt, hardcore, ultimate et lastcard — n'y figurent pas, et leurs raisons sont aussi intéressantes que les onze qui y sont.
Ce chapitre lit le classement ligne par ligne, puis décompose les 0.0381 point de Brier gagnés entre la baseline et le leader : qui a apporté quoi, et dans quelles proportions. La conclusion sera peut-être décevante pour qui aime les algorithmes.
Le classement complet
Toutes les lignes sont mesurées sur le même holdout : les 1 146 matchs des 42 derniers jours, jamais vus à l'entraînement. Les métriques sont calculées par la même fonction pour toutes les approches.
| Rang | Approche | Brier | Log-loss | Exactitude | Nature du gain |
|---|---|---|---|---|---|
| 1 | segmodel | 0.2041 | 0.5916 | 67,9 % | mélange 75/25 modèle-de-segment / global |
| 2 | lastmile | 0.2044 | 0.5931 | 67,5 % | interactions « équipes bien connues » × horloges |
| 3 | assault | 0.2054 | 0.5954 | 66,8 % | horloges réchauffées + économie par manche |
| 4 | squeeze | 0.2154 | 0.6192 | 64,6 % | rang mondial daté au jour du match |
| 5 | push | 0.2172 | 0.6210 | 64,0 % | pi-ratings, TrueSkill par carte, momentum |
| 6 | final | 0.2180 | 0.6221 | 64,2 % | fusion des trois familles du concours |
| 7 | bayes | 0.2256 | 0.6410 | 63,8 % | TrueSkill par joueur |
| 8 | stats | 0.2289 | 0.6469 | 62,0 % | statistiques joueurs glissantes |
| 9 | maps | 0.2293 | 0.6474 | 59,8 % | manches, veto, CT/T, head-to-head |
| 10 | stack | 0.2306 | 0.6515 | 60,1 % | empilement de cinq bases |
| 11 | logreg | 0.2315 | 0.6538 | 60,4 % | logistique sur 22 features transformées |
Et les repères, sur les mêmes matchs sauf mention contraire :
| Repère | Brier | Exactitude |
|---|---|---|
| Champion v2 — départ du concours | 0.2330 | 60,4 % |
| Glicko de Valve — baseline | 0.2422 | 56,0 % |
| Pièce lancée | 0.250 | 50 % |
| Bookmakers — littérature, tier 1 | 0.198 | 68,7 % |
Erreur fréquente — lire le classement à l'exactitude
L'exactitude ne mesure que le côté de 50 % : ai-je désigné le bon vainqueur ? Le Brier mesure en plus à quel point j'y croyais. Deux modèles à 64 % d'exactitude peuvent avoir des Brier très différents, et c'est le Brier qui compte pour un simulateur : le Monte Carlo consomme des probabilités, pas des pronostics. On le voit ligne 5 contre ligne 6 : push a un meilleur Brier que final (0.2172 contre 0.2180) et une exactitude plus basse (64,0 % contre 64,2 %). Il se trompe un peu plus souvent de côté, mais il dose mieux sa confiance.
Lecture ligne par ligne
Rang 11 — logreg (0.2315) : le premier avertissement
Une régression logistique codée à la main sur les 10 features de départ étendues à 22 : saturations en tangente hyperbolique de l'écart d'Elo, logit de la probabilité Glicko, désaccord entre les deux horloges, six interactions ciblées.
Elle bat le champion XGBoost (0.2330) sans un seul arbre. C'est la première apparition d'un résultat qui reviendra quatre fois : sur ces features, la frontière est presque linéaire. Deux détails du rapport valent d'être retenus : l'ordonnée à l'origine de +0,28 confirme un biais d'ordre (l'équipe listée en premier gagne un peu plus souvent), et le désaccord entre horloges est un vrai signal (+0,07) — quand deux systèmes de rating ne sont pas d'accord, cette divergence porte de l'information.
L'approche a aussi testé et rejeté une idée séduisante : prédire la probabilité de manche puis recomposer la série par une loi binomiale. Elle perd en validation (0.2309 contre 0.2303) et le mélange optimal met un poids nul dessus. Raison : la binomiale suppose des manches indépendantes, or elles ne le sont pas — la corrélation intra-série coûte plus que le supplément d'échantillons ne rapporte.
Rang 10 — stack (0.2306) : l'ensemble sans diversité
Cinq modèles de base, prédictions hors-échantillon par blocs temporels, choix du méta-modèle et du calibrateur par validation interne. Gain : 0.2329 → 0.2306, soit 0,23 point de Brier — sous la fourchette attendue de 0,5 à 1 point.
Le rapport donne la cause sans détour : les cinq bases partagent les mêmes features, donc elles se trompent aux mêmes endroits. Un ensemble n'exploite que les désaccords ; sans désaccord, il ne reste que la moyenne.
Deuxième résultat, plus important : la calibration seule ne rapporte rien. La surconfiance visible sur le holdout dans la tranche 65–80 % (prédit 72,8 %, réel 64,5 %) n'existe pas dans les prédictions hors-échantillon du train. Un calibrateur appris proprement — sans toucher au holdout — ne peut donc pas la corriger ; forcé, il dégrade (0.2329 → 0.2338 ou 0.2346 selon la méthode). La sélection interne choisit l'identité. Ce résultat a été respecté par toute la suite de la campagne : plus aucune calibration forcée n'a été tentée.
Rang 9 — maps (0.2293) : la meilleure feature du concours
7 148 pages de match analysées hors ligne : veto complet, scores par carte avec mi-temps CT et T, head-to-head daté. Neuf features construites en balayage chronologique strict, dont un taux de victoire attendu sur les cartes probablement jouées après simulation des vetos.
Le résultat marquant n'est pas le Brier (0.2293, honnête) mais l'importance :
round_share_diff — l'écart de part de manches gagnées sur les 30 dernières
cartes — devient la feature n° 1 absolue, devant l'écart d'Elo à marge.
ct_share_diff et h2h_maps_diff entrent dans le top 5.
C'est un enseignement sur le jeu autant que sur la modélisation : la domination au niveau manche est un meilleur prédicteur que le palmarès au niveau série.
Rang 8 — stats (0.2289) : le gisement dormant
9 112 pages de match du cache contenaient des tables de statistiques par joueur que personne n'avait jamais analysées : K-D, ADR, KAST, rating 3.0. 8 376 pages exploitables, moyennes glissantes sur 10 matchs par joueur, agrégées en équipe (moyenne, meilleur joueur, écart-type, couverture), puis différenciées.
Sept features ajoutées, même modèle, même holdout : 0.2331 → 0.2289.
pkast_diff et prat_mean_diff arrivent en 2ᵉ et 3ᵉ position d'importance,
derrière l'écart d'Elo à marge.
Intuition — pourquoi KAST plutôt que le nombre de kills
Le KAST est le pourcentage de manches où un joueur a fait au moins une chose utile : un kill, une assistance, survivre, ou se faire échanger. Il mesure la régularité de contribution plutôt que l'éclat. Pour prédire une série, savoir qu'une équipe a cinq joueurs qui contribuent presque toutes les manches vaut mieux que savoir qu'elle a une star capable de vingt kills.
Notez la taille d'échantillon : cette approche a mesuré sur 1 119 matchs et non
1 146, faute de couverture complète des statistiques. Même remarque pour maps
(1 141). Les écarts sont faibles mais réels — c'est une des raisons pour
lesquelles la fusion final a reconstruit une timeline commune.
Rang 7 — bayes (0.2256) : rendre l'incertitude au rating
Le Glicko de Valve fige le RD à 75 : le modèle ne sait plus dire qu'il ne connaît pas une équipe. Deux horloges rejouées en balayage chronologique lui rendent la parole : un Glicko-2 complet (\(\sigma\) vivant, \(\phi\) gonflé par l'inactivité) et un TrueSkill par joueur, où les ratings suivent les individus à travers les transferts et où l'équipe du jour est la somme de son line-up.
En prédicteurs purs sur le holdout : Valve 0.2422, Glicko-2 0.2365, TrueSkill
0.2354. Injectées dans le modèle : Glicko-2 → 0.2310, TrueSkill → 0.2256.
ts_diff devient la feature n° 1 (importance 16,9, devant toutes les features de
départ) et ts_sigma_sum — la somme des incertitudes des deux équipes —
contribue aussi (4,9).
Résultat négatif intéressant : les deux horloges ensemble ne font pas mieux que TrueSkill seul (0.2258 contre 0.2256). Elles mesurent la même chose.
Rang 6 — final (0.2180) : la fusion qui change de famille de modèle
Un seul balayage chronologique commun, les trois familles rejouées telles quelles par import dynamique — zéro code recopié — pour 32 features.
Deux décisions structurantes, toutes deux prises en validation interne. D'abord : les sélections « top-k par importance » perdent contre les 32 features complètes, ce qui prouve que les familles se recouvrent peu. Ensuite, et c'est le vrai tournant de la campagne : la logistique L2 bat XGBoost et leur mélange (0.2285 contre 0.2331 et 0.2293 en validation). Le champion arboré est remplacé par un modèle linéaire, et il ne reviendra jamais.
Holdout : 0.2180 / 64,2 %, calibration propre sur les six tranches.
Rang 5 — push (0.2172) : la littérature passée au crible
Soixante configurations chiffrées, guidées par ce que la littérature du domaine suggérait. Ce qui a été retenu : les pi-ratings de Constantinou & Fenton, le TrueSkill mis à jour par carte (2,1 fois plus de mises à jour qu'au niveau série), le momentum sur 7 et 21 jours, deux interactions ciblées, une pondération par récence à demi-vie de 180 jours. Total : 40 features.
Ce qui a échoué est plus instructif :
| Idée testée | Brier en validation | Verdict |
|---|---|---|
| Recomposition de série depuis des modèles par carte | 0.2303 – 0.2379 | veto attendu trop bruité |
| GBDT→LR (feuilles d'arbres en entrée d'une logistique) | 0.2405 et + | du bruit sur une frontière linéaire |
| XGBoost à contraintes monotones | 0.2302 | ne rattrape pas la logistique |
| Label multinomial 2-0 / 2-1 | 0.2292 | perd contre le binaire |
| Format Bo en interaction | neutre | rien |
| Calibration forcée | dégrade | leçon de stack confirmée |
Le point commun de la première et de la troisième ligne : le signal à granularité carte est réel, mais il passe par les horloges, pas par la recomposition. Modéliser chaque carte puis recombiner en série suppose de savoir quelles cartes seront jouées ; le veto attendu est trop incertain pour supporter ce poids.
Transparence du rapport : le holdout a été évalué deux fois — un tableau exploratoire, puis le modèle final — avec le choix figé avant la seconde passe. C'est la seule entorse au budget d'une passe de toute la campagne, et elle est écrite dans le rapport.
Rang 4 — squeeze (0.2154) : une horloge qui perce la fenêtre
Quatre chantiers, un seul gagnant. Les trois perdants : head-to-head enrichi et pondéré par le recouvrement de roster (0.2264 — déjà couvert par les features existantes), boxes de forme (0.2261 — déjà couvertes par form5 et form10), archives hebdomadaires de classement (0.2258 seules, mais 0.2255 combinées au gagnant, donc redondantes).
Le gagnant : le rang mondial au jour du match, reconstitué depuis l'historique daté embarqué dans les pages d'équipe — 439 équipes, 42 302 points datés, 84 % des matchs couverts. Validation croisée avec les archives hebdomadaires : 99,8 % d'accord exact.
Pourquoi cette feature marche là où toutes les autres échouaient : c'est une horloge externe et longue durée. Toutes nos features vivent dans une fenêtre de six mois ; le rang mondial, lui, intègre des années d'historique. Il apporte une information que la fenêtre ne peut pas contenir.
Rang 3 — assault (0.2054) : la découverte de la campagne
Le saut le plus large du classement — 0.0100 point de Brier d'un coup — et sa décomposition, mesurée en une seule passe de holdout, est le résultat le plus important de toute la campagne.
| Étape | Brier | Gain |
|---|---|---|
| Reproduction de squeeze, états froids, train 6 mois | 0.2153 | — |
| États natifs réchauffés (fenêtre native 12 mois) | 0.2081 | −0.0072 |
| + entraînement étendu à 12 mois | 0.2078 | −0.0003 |
| + économie par manche seule | 0.2064 | −0.0017 |
| + préchauffage externe seul | 0.2063 | −0.0018 |
| Combiné, 46 features, choisi en validation | 0.2054 | — |
Les deux tiers du gain viennent de la première ligne, et cette ligne ne contient aucune modélisation. Jusque-là, chaque rating démarrait à zéro au début de la fenêtre de six mois : au moment du test, les horloges venaient à peine de se stabiliser. En étendant la fenêtre native à douze mois, elles arrivent chaudes.
À retenir — le démarrage à froid était la faiblesse n° 1
Pendant quatre chantiers, on a cherché de meilleures features. Le vrai problème était que les features existantes étaient mal initialisées. Chaque fois qu'un système entretient un état (rating, moyenne glissante, compteur), demandez-vous depuis combien de temps cet état tourne au moment où vous l'évaluez. La réponse vaut souvent plus qu'une nouvelle feature.
Rang 2 — lastmile (0.2044) : quatre chantiers, un survivant
Le chantier adopté : un indicateur binaire « les deux équipes sont bien connues » (somme des incertitudes TrueSkill sous la médiane du jeu d'entraînement), croisé avec les sept features les plus fortes. Gain en validation : +0.0006. Le principe : quand on connaît bien les deux équipes, les horloges méritent plus de poids ; quand on les connaît mal, moins.
Les trois morts, chiffrées :
- Empilement sur familles réellement disjointes — six bases sans aucune feature partagée, prédictions hors-échantillon par six blocs temporels, méta-logistique sur les logits et le désaccord. Résultat : 0.2201 seul, 0.2178 avec la base complète, 0.2170 en mélange, contre 0.2163 pour le modèle plat. Cette fois la diversité était là, et l'empilement a quand même perdu.
- Statistiques de carrière archivées — cinq features issues de 966 clichés datés récupérés dans des archives web. Couverture : 19 % du holdout. Résultat : 0.2166, c'est-à-dire rien.
- Transformations de features et régularisation par groupe — rien non plus. Un seul micro-gain a survécu : supprimer la décroissance temporelle (+0.0002).
Rang 1 — segmodel (0.2041) : le candidat repêché
Le leader final vient d'une phrase écrite dans le rapport de lastmile : un candidat avait fait 0.2149 en validation — le meilleur score jamais observé — mais la logique d'adoption automatique du script ne l'avait pas promu, et la passe de holdout était consommée.
Le chantier suivant l'a repris et exploré autour : deux définitions de segment, trois seuils, trois poids de mélange, deux jeux de features, soit 40 combinaisons en validation. La meilleure — mélange 75 % modèle-de-segment / 25 % modèle-global, segment défini par la médiane de l'incertitude TrueSkill, 54 features — donne 0.2147 en validation.
Une seule passe de holdout, avec contrôle : lastmile re-mesuré à 0.2044 exact, candidat à 0.2041 / 0.5916 / 67,9 %. Confirmé.
Hors classement — quatre approches qui n'ont pas battu le leader du moment
gbdt n'a pas rendu de README, mais son rapport JSON existe. Trois bibliothèques d'arbres, 50 essais de réglage chacune, mise en sac de huit modèles, calibrations testées. Meilleur candidat en validation : CatBoost réglé (0.22262). Sur le holdout : 0.2331, contre 0.2330 pour le champion XGBoost non réglé. Le réglage automatique le plus complet de la campagne n'a pas produit un millième de point.
hardcore a testé l'hypothèse « un modèle simple bat le riche sur le segment difficile ». Validation : oui (0.2135 contre 0.2147). Holdout : non (0.2042 contre 0.2041). Le gain ne s'est pas transféré. Comme le candidat est plus mauvais que le leader, aucune ligne n'a été ajoutée au classement — c'est la règle, et elle a été respectée alors qu'il aurait été facile de présenter le 0.2042 comme « équivalent ».
ultimate a rejoué les huit états d'économie du leader sur le gisement de manches unifié sur douze mois — 299 961 manches, 6 220 matchs, appariement de 89,6 % sur la période nouvellement collectée, treize vainqueurs discordants exclus. La couverture d'entraînement double (3 041 → 6 211 sur 9 479) mais celle du holdout ne bouge quasiment pas (964 → 969 sur 1 146) : les états étaient déjà chauds en 2026.
Résultat : l'économie unifiée dégrade en validation, 0.2157 contre 0.2147 pour la reproduction exacte du leader. Les extensions prévues (conversion de pistolets, conversion de premiers kills) n'ont donc jamais été déclenchées, et un re-réglage du poids de mélange et du seuil de segment ne fait pas mieux (0.2146, sous le seuil de bruit). Candidat retenu en validation : le leader lui-même. Holdout : 0.2041 / 67,9 %, contrôle exact.
lastcard a réchauffé le TrueSkill par carte sur les 77 890 cartes de l'historique externe remontant à 2024 — 39 929 matchs, 70 815 mises à jour au niveau carte, 5 039 replis au niveau match. La nouvelle horloge est corrélée à l'ancienne à 0,64 seulement, donc porteuse d'information différente.
| Variante testée | Brier en validation |
|---|---|
| Reproduction du leader | 0.2147 |
Ajout de wtsm aux 54 features, modèle global |
0.2149 |
Ajout de wtsm, blend de segment \(w = 0{,}5\) |
0.2137 |
Ajout de wtsm, blend de segment \(w = 0{,}75\) |
0.2135 |
Remplacement de tsm par wtsm, modèle global |
0.2150 |
| Remplacement, blend \(w = 0{,}75\) | 0.2137 |
Le seuil de déclenchement de la passe holdout était fixé d'avance à 0.0005 ; le gain de −0.0012 le franchit largement. Holdout, une passe avec contrôle : leader 0.2041, candidat 0.2044.
Verdict inscrit tel quel dans le rapport : « INFIRMÉ en holdout — la validation mentait. »
À retenir — trois échecs d'affilée, c'est un résultat
hardcore, ultimate et lastcard ferment la campagne. Deux d'entre eux disposaient d'un gain de validation net et identique (−0.0012), tous deux sélectionnés parmi une grille, tous deux démentis par le holdout. Le troisième est mort avant même d'y arriver.
Ce n'est pas une série de malchances : c'est le plancher de bruit. Voir le chapitre des leçons pour le critère d'arrêt qui en découle.
La décomposition des gains
Voici la question qui compte : sur les 0.0381 point de Brier gagnés entre la baseline Glicko et le leader, qui a apporté quoi ?
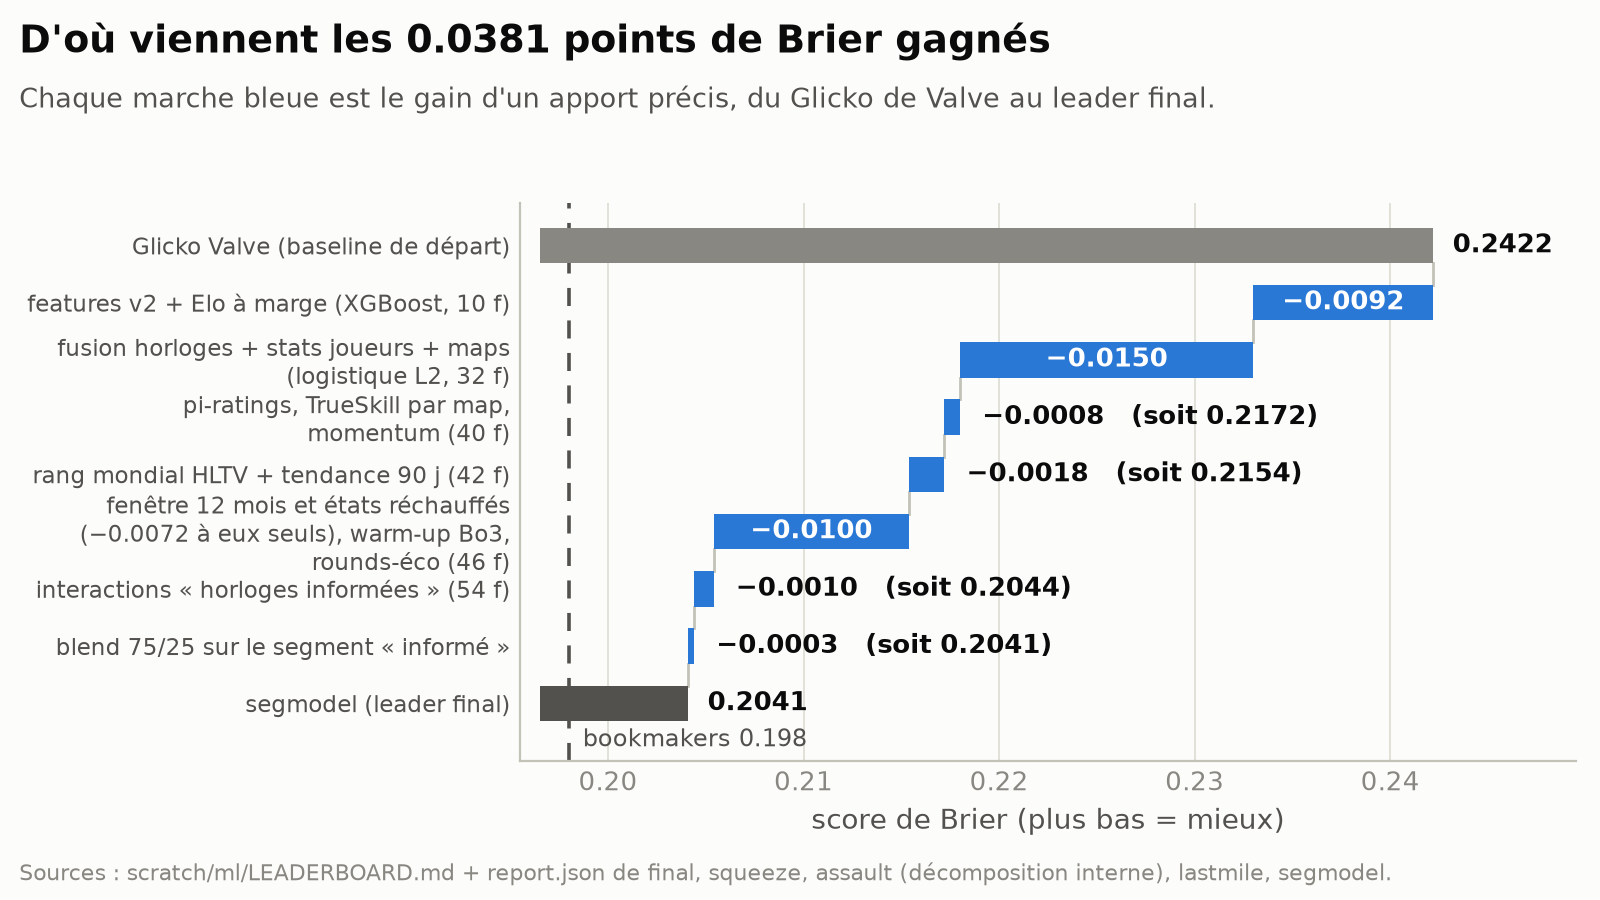
| Contribution | Gain de Brier | Part du total |
|---|---|---|
| Features d'équipe de base + Elo à marge | −0.0092 | 24 % |
| Les trois familles du concours + passage au linéaire | −0.0150 | 39 % |
| Horloges de la littérature (pi, TrueSkill par carte, momentum) | −0.0008 | 2 % |
| Rang mondial daté (horloge externe longue durée) | −0.0018 | 5 % |
| Réchauffage des horloges + économie par manche + préchauffage externe | −0.0100 | 26 % |
| Interactions « équipes bien connues » | −0.0010 | 3 % |
| Mélange par segment | −0.0003 | 1 % |
| Total | −0.0381 | 100 % |
Les deux plus gros postes — 39 % et 26 % — sont des apports d'information, pas des apports d'algorithme : de nouvelles données extraites du cache, de nouvelles horloges, un historique plus long. Le seul poste franchement algorithmique du tableau (les mélanges, interactions et sélections des trois dernières lignes) pèse 4 % à lui tout seul.
À retenir — la donnée bat le modèle, chiffres à l'appui
Dans cette campagne, 89 % du gain vient de « donner plus ou mieux à manger » au modèle, et 4 % de « mieux modéliser ». Le passage d'XGBoost réglé à une logistique simple, lui, a amélioré le résultat. Si votre projet ressemble à celui-ci, votre prochaine heure est mieux investie à chercher une source qu'à régler un hyperparamètre.
Le détail des vingt-deux premiers points de gain mérite une note : le passage
d'une famille de modèles à l'autre (arbres → linéaire) n'a rien coûté et a
rapporté. Il n'apparaît pas comme une ligne séparée dans le tableau parce qu'il
est indissociable de la fusion final — mais la validation interne de ce
chantier le mesure : 0.2285 pour la logistique contre 0.2331 pour XGBoost sur
les mêmes 32 features.
La progression dans le temps
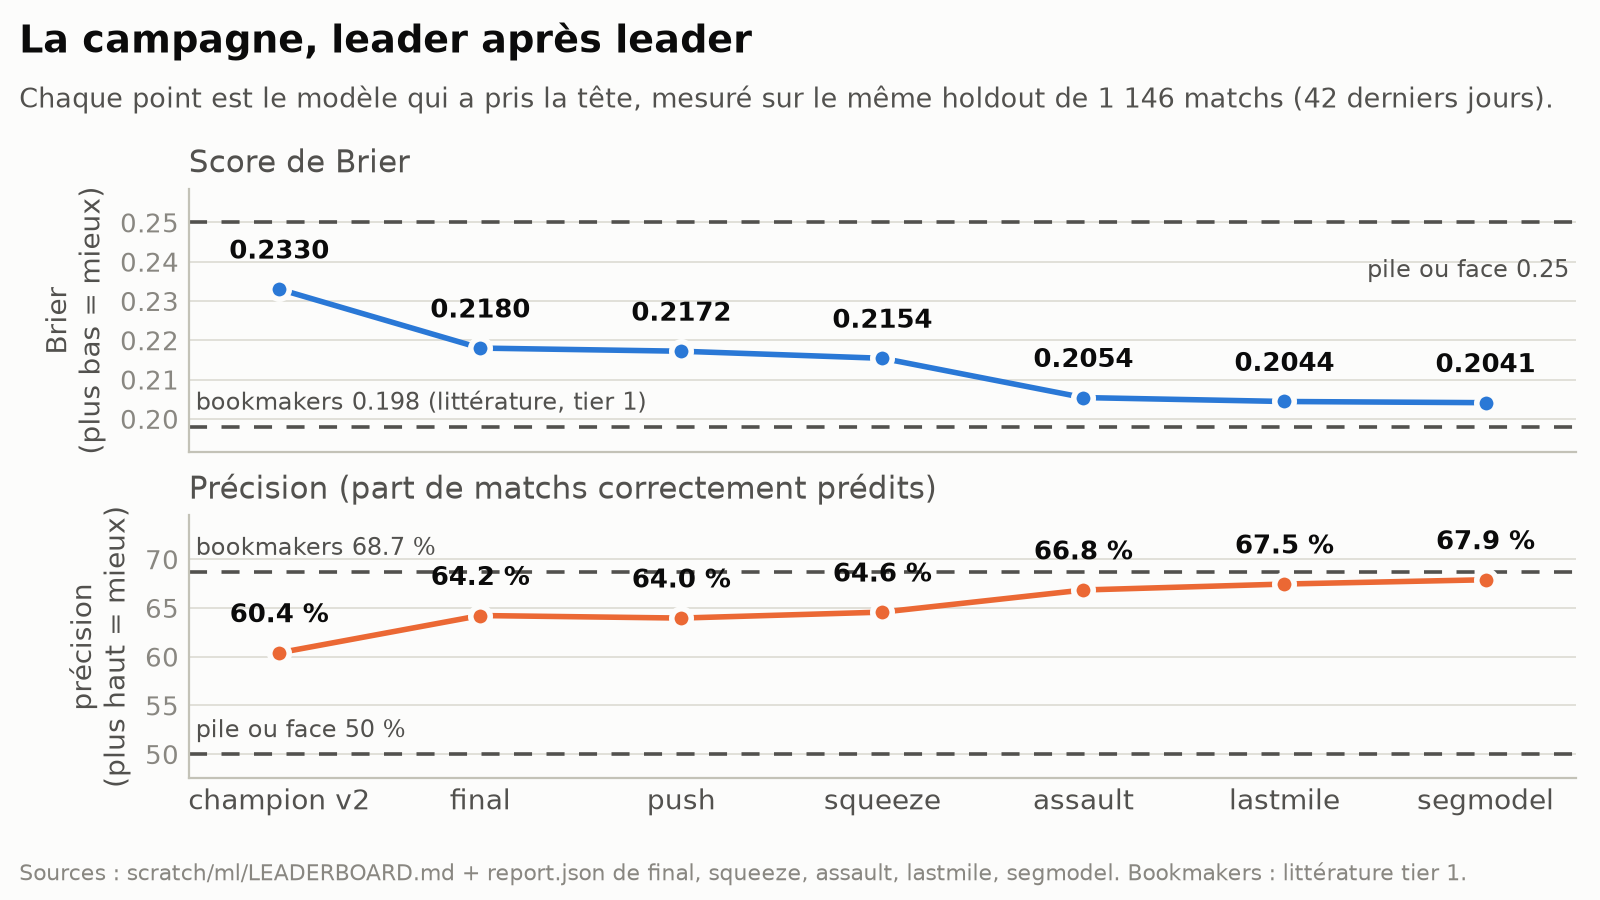
Deux phases se lisent sur la courbe.
Phase 1, jusqu'à squeeze : une descente régulière et lente, 0.2422 → 0.2154 en cinq étapes, chacune apportant entre 0.0008 et 0.0150. C'est la phase de collecte : chaque étape ajoute une famille d'information nouvelle.
Phase 2, à partir d'assault : une marche brutale (−0.0100 d'un coup) suivie d'un plateau. Les deux chantiers suivants ne grattent plus que 0.0010 et 0.0003.
Le plateau est le signal le plus honnête de la campagne : on a épuisé ce que les données disponibles contiennent. Cinq chantiers successifs — lastmile, segmodel, hardcore, ultimate, lastcard — ont exploré chacun plusieurs dizaines de configurations pour un gain cumulé de 0.0013, entièrement acquis par les deux premiers. Les trois derniers ont rendu des résultats nuls ou négatifs.
L'écart restant aux bookmakers : la lecture honnête
Le leader est à 0.2041 ; le repère bookmaker de la littérature est à 0.198. Il reste 0.0061 point de Brier, et 0,8 point d'exactitude (67,9 % contre 68,7 %).
Trois précautions avant d'interpréter ce chiffre.
Première précaution : ce n'est pas le même pool de matchs. Le 0.198 est mesuré sur du tier 1. Notre holdout mélange tier 1 à tier 3, où les écarts de force sont plus larges — donc les matchs mécaniquement plus faciles. Selon le sens de ce biais, l'écart réel est plus grand ou plus petit que 0.0061 ; on ne sait pas de combien. La comparaison rigoureuse serait de faire tourner un bookmaker sur nos 1 146 matchs, ce qui suppose d'avoir ses cotes.
Deuxième précaution : on n'a pas ces cotes, et on a cherché. Une mission entière a été consacrée à la recherche de sources. Verdict, testé et documenté : le mot « odds » n'apparaît dans notre cache que dans les commentaires de forum — le site injecte les cotes en JavaScript géolocalisé. Les fournisseurs professionnels réservent les cotes à leurs offres payantes. Aucune source de cotes gratuite n'a été trouvée. Le repère bookmaker reste donc à jamais un repère de littérature, jamais une mesure sur nos matchs.
Troisième précaution : l'écart n'est pas un écart de modélisation. C'est le point que trois chantiers successifs ont établi. Le rétrécissement des probabilités vers 50 % dégrade — donc le modèle n'est pas surconfiant. La régularisation est à plateau sur un ordre de grandeur — donc il n'est ni sur-ajusté ni sous-ajusté. La calibration apprise proprement choisit l'identité — donc les probabilités sont déjà honnêtes. Il ne reste qu'une explication : de l'information manquante.
L'information qu'on n'a pas
Trois blocs, par ordre décroissant d'importance présumée.
Les cotes elles-mêmes, et le marché derrière. Une cote n'est pas une prédiction : c'est l'agrégation des paris de milliers de personnes, dont certaines savent des choses. Le marché intègre en continu ce que personne n'écrit nulle part.
Les compositions du jour. Un joueur remplaçant, un joueur malade, un joueur qui vient d'annoncer son départ : l'information circule sur les réseaux quelques heures avant le match et déplace les cotes de plusieurs points. Nos features de roster décrivent l'équipe enregistrée, pas celle qui va entrer en jeu. Le projet a bien tenté de récupérer les transferts datés depuis des archives web — 19 % de couverture, aucun gain.
Le contexte non structuré. Enjeu réel du match pour chaque équipe (une équipe déjà qualifiée ne joue pas comme une équipe qui doit gagner), fatigue de voyage, changement d'entraîneur, conflit interne. Rien de tout cela n'est dans une base de résultats.
Limite importante — un plafond de données, pas un plafond de talent
L'écart de 0.0061 ne se comblera pas avec un meilleur modèle. Il se comblerait — peut-être — avec des cotes historiques, des compositions confirmées et un flux d'actualités daté. Tant que ces trois sources manquent, tout chantier de modélisation supplémentaire produira ce qu'a produit hardcore : un gain en validation, zéro en holdout.
Ce que le classement dit vraiment
Trois lectures, à emporter.
Le classement est serré en haut et large en bas. Entre les rangs 1 et 3, 0.0013 point sépare trois approches ; entre les rangs 1 et 11, 0.0274. Autrement dit : les premiers 90 % du chemin sont faits par les cinq premières idées, et les derniers 10 % coûtent trois chantiers complets.
Les échecs sont concentrés sur un type d'idée. Empilement, méta-modèles, recomposition, calibration forcée, contraintes monotones, feuilles d'arbres en features : toutes les tentatives de raffinement structurel ont échoué. Toutes les tentatives d'apport d'information ont réussi, sauf celles dont la couverture était trop faible.
Le leader n'est pas impressionnant, et c'est rassurant. Une régression logistique régularisée sur 54 features, mélangée à une seconde régression logistique entraînée sur un sous-ensemble. Aucun réseau de neurones, aucun arbre, aucun réglage exotique. Un modèle qu'on peut inspecter coefficient par coefficient — et dont on peut donc justifier chaque prédiction.
Chapitre précédent : Chronologie de la campagne · Chapitre suivant : La carte de prévisibilité · Tableau récapitulatif