La régression logistique — la gagnante du concours
Le modèle qui a fini premier de la campagne tient en une ligne de mathématiques et en quelques dizaines de nombres. Il n'a pas d'arbres, pas de couches cachées, pas de gradient boosting : c'est une somme pondérée de features, écrasée entre 0 et 1. Ce chapitre explique comment il fonctionne, comment il a été réglé, et pourquoi il a battu des méthodes réputées supérieures.
L'intuition avant les formules
Imaginez que vous notiez chaque match à la main. Vous partez de zéro, puis vous ajoutez et retranchez des points :
   Vitality vs Falcons
   ────────────────────────────────────────────
   écart de rating TrueSkill  +180  →  + 0.42
   écart de forme sur 10      +2    →  + 0.15
   match sur LAN                    →  + 0.02
   Falcons mieux reposés      −3 j  →  − 0.05
   écart de rang HLTV         +4    →  + 0.11
   ────────────────────────────────────────────
   total (le « score »)               + 0.65
Ce total, appelé score ou logit, est un nombre sur toute la droite réelle : il peut valoir −4, 0 ou +2.3. Or on veut une probabilité, entre 0 et 1. Il faut donc une fonction qui prenne n'importe quel réel et rende un nombre dans cet intervalle, en respectant l'ordre (plus le score est grand, plus la probabilité est grande). C'est exactement le rôle de la fonction sigmoïde.
Tout le travail d'apprentissage consiste à trouver les bons coefficients : combien vaut un point d'écart TrueSkill, combien vaut la LAN, combien vaut un jour de repos. Ces coefficients ne sont pas devinés, ils sont estimés sur des milliers de matchs déjà joués.
Le modèle
La régression logistique modélise la probabilité que l'équipe 1 gagne par
où :
- \(\mathbf{x} \in \mathbb{R}^d\) est le vecteur des features du match (\(d = 21\) pour le premier modèle du concours — le leaderboard le note « 22 features » en comptant l'intercept — et \(d = 54\) pour le leader final) ;
- \(\mathbf{w} \in \mathbb{R}^d\) est le vecteur des poids appris, un par feature ;
- \(b\) est l'intercept (ou biais), un poids constant qui ne dépend d'aucune feature ;
- \(\mathbf{w}^\top \mathbf{x} = \sum_{j=1}^{d} w_j x_j\) est le produit scalaire, c'est-à-dire la somme pondérée du tableau ci-dessus ;
- \(z = \mathbf{w}^\top \mathbf{x} + b\) est le score, ou logit ;
- \(\sigma\) est la sigmoïde, qui envoie \(\mathbb{R}\) dans \(]0, 1[\).
La sigmoïde vaut 0.5 en \(z = 0\), tend vers 1 quand \(z \to +\infty\) et vers 0 quand \(z \to -\infty\). Quelques valeurs à retenir : \(\sigma(0.5) \approx 0.62\), \(\sigma(1) \approx 0.73\), \(\sigma(2) \approx 0.88\).
Intuition — le logit est une échelle de cote
La réciproque de la sigmoïde est le logit : \(z = \ln\frac{p}{1-p}\). La quantité \(\frac{p}{1-p}\) est la cote (odds) : à \(p = 0.75\), la cote vaut 3, donc « 3 contre 1 ». Un modèle logistique dit donc : chaque feature ajoute ou retranche un montant fixe au logarithme de la cote. Une feature qui vaut \(+0.69\) de logit multiplie la cote par \(e^{0.69} \approx 2\) : elle double les chances relatives. C'est la bonne façon de lire les poids.
Un exemple numérique, avec les vrais poids
Le premier modèle logistique du concours (dossier logreg, 22 features) a produit,
entre autres, ces poids — exprimés sur des features standardisées, donc directement
comparables entre eux :
| Feature | Poids | Lecture |
|---|---|---|
| intercept | +0.2785 | biais d'ordre : l'équipe listée « team1 » gagne un peu plus souvent |
experience_diff |
+0.0911 | écart de log(1 + matchs joués) |
form10_diff |
+0.0761 | écart de victoires sur 10 matchs |
disagree |
+0.0695 | désaccord entre l'Elo à marge et le Glicko de Valve |
melo_diff |
+0.0523 | écart d'Elo à marge |
tanh_melo_400 |
+0.0518 | le même écart, saturé par une tangente hyperbolique |
tanh_melo_200 |
+0.0504 | idem, avec une saturation deux fois plus rapide |
logit_glicko |
+0.0424 | la probabilité Glicko, ramenée en logit |
rest_diff |
+0.0499 | écart de jours de repos |
glicko_diff |
+0.0424 | écart de rating Glicko |
lan |
+0.0241 | le match est en LAN |
rest_x_melo |
−0.0273 | interaction repos × niveau |
Prenons un match où l'équipe 1 est un écart-type au-dessus sur les trois canaux d'Elo à marge et les deux canaux de Glicko, et un demi écart-type au-dessus en forme sur 10 matchs, tout le reste étant neutre. Le score vaut
et la probabilité prédite est \(\sigma(0.556) = 0.636\). Une équipe nettement au-dessus sur toutes les horloges n'est donc annoncée qu'à 64 % — ce qui, on va le voir, est un effet direct de la régularisation.
À retenir
Un modèle logistique, c'est un barème. Chaque feature apporte un nombre fixe de points de logit par écart-type ; la sigmoïde convertit le total en probabilité. Rien de plus.
Comment on apprend les poids : la log-vraisemblance
Il faut un critère qui dise si un jeu de poids est bon. Le critère naturel est la vraisemblance : la probabilité que le modèle attribue à ce qui s'est réellement passé.
Pour un match \(i\), notons \(y_i = 1\) si l'équipe 1 a gagné, \(y_i = 0\) sinon, et \(p_i\) la probabilité prédite. La probabilité que le modèle assigne à l'issue observée est
Cette écriture compacte dit simplement : si \(y_i = 1\), la probabilité assignée est \(p_i\) ; si \(y_i = 0\), c'est \(1 - p_i\). En supposant les matchs indépendants, la vraisemblance de tout le jeu de données est le produit de ces termes. Comme un produit de milliers de nombres inférieurs à 1 s'écrase numériquement, on prend le logarithme, qui transforme le produit en somme :
Maximiser \(\ell\) revient à minimiser son opposé divisé par \(n\), qui n'est autre que la log-loss — la métrique déjà utilisée pour juger les modèles :
Le critère d'entraînement et le critère d'évaluation sont donc la même chose. C'est une propriété agréable et assez rare.
Pourquoi c'est facile à résoudre
Le gradient de cette perte a une forme remarquablement simple :
Chaque match pousse les poids proportionnellement à son erreur \(p_i - y_i\) et à ses features. Un match parfaitement prédit ne pousse rien.
Surtout, \(L\) est convexe en \((\mathbf{w}, b)\) : elle n'a qu'un seul minimum, sans vallées parasites. Il n'y a donc ni initialisation à soigner, ni graine aléatoire, ni risque de tomber sur un mauvais optimum — deux entraînements donnent exactement le même modèle. C'est l'opposé d'un réseau de neurones.
Dans le projet, deux implémentations ont coexisté, avec le même résultat :
scratch/ml/logreg/train.pycode la perte et son gradient à la main (NumPy) et les confie à L-BFGS-B de SciPy, un optimiseur quasi-Newton ;- tous les modèles suivants (
final,push,assault,lastmile,segmodel) utilisentLogisticRegressionde scikit-learn, qui fait la même chose avec les mêmes garanties.
La régularisation L2 : rétrécir pour mieux prédire
Si on minimise \(L\) seule, rien n'empêche les poids de grandir indéfiniment. Quand les features sont nombreuses et corrélées — nos 54 features le sont beaucoup — l'optimiseur trouve toujours des combinaisons alambiquées qui expliquent parfaitement le passé et n'ont aucune valeur pour l'avenir : c'est le sur-ajustement.
La régularisation L2 (ou ridge) ajoute une pénalité proportionnelle au carré des poids :
où \(\lambda \geq 0\) règle la force de la pénalité. Trois remarques importantes :
- l'intercept \(b\) n'est pas pénalisé (il ne porte aucune information de feature, le rétrécir ne ferait que biaiser le taux de base) ;
- \(\|\mathbf{w}\|^2\) est le carré de la norme euclidienne : pénaliser le carré pousse fort les gros poids et laisse tranquilles les petits ;
- scikit-learn paramètre la même chose à l'envers, par \(C\) : plus \(C\) est petit, plus la régularisation est forte. La correspondance est \(C \propto 1/\lambda\).
L'intuition du rétrécissement
Imaginez deux features presque identiques (chez nous : melo_diff et sa version saturée
tanh_melo_400, dont la corrélation est énorme). Sans pénalité, l'optimiseur est
indifférent entre \((w_1, w_2) = (+10, -9.5)\) et \((0.5, 0)\) : les deux donnent presque le
même score sur le train. Le premier jeu est catastrophique — une petite variation de
l'une des deux features fait exploser la prédiction. La pénalité L2 départage : entre
deux solutions équivalentes en ajustement, elle choisit celle dont les poids sont les
plus petits, donc la plus stable.
Autrement dit, la L2 ne supprime pas de features (contrairement à la L1, qui met des poids exactement à zéro) : elle répartit le crédit entre features corrélées et rétrécit tout le monde vers zéro.
Intuition — rétrécir, c'est douter
Rétrécir les poids vers zéro, c'est rapprocher les prédictions de 50 %. Un modèle fortement régularisé est un modèle prudent : il n'annoncera jamais 95 %. Comme le Brier punit très cher une prédiction confiante et fausse, la prudence n'est pas une faiblesse — elle est souvent optimale.
Le rétrécissement, visible à l'œil nu dans nos chiffres
Le premier modèle logistique a retenu \(\lambda = 1000\) après validation croisée
temporelle. En repartant de la formule de la perte codée dans train.py
(\(\lambda \, \|\mathbf{w}\|^2 / 2n\) avec \(n = 4\,916\)), cette valeur correspond à un
\(C = 1/\lambda = 0.001\) dans la convention scikit-learn : une régularisation
extrêmement forte.
L'effet se lit directement dans les poids : le plus gros de tous vaut 0.0911, et la somme des valeurs absolues des 21 poids vaut 0.827. Le logit ne peut donc pratiquement pas sortir de l'intervalle \([0.28 - 1.65,\; 0.28 + 1.65]\), soit des probabilités bornées en pratique autour de \([0.20,\; 0.87]\).
Et c'est exactement ce que montre la table de calibration mesurée sur le holdout : la tranche la plus basse contient un seul match (probabilité moyenne 0.193) et la plus haute 38 matchs à 0.833 de moyenne. Ce modèle n'a jamais annoncé ni 5 % ni 95 %.
Les modèles suivants, avec des features bien plus informatives, ont retenu une régularisation nettement plus douce, \(C = 0.3\), et leurs prédictions s'étalent davantage : la table de calibration du leader final couvre de 0.127 à 0.873 de moyenne par tranche, avec 60 matchs sous 0.2 et 112 au-dessus de 0.8.
| Modèle | Features | Régularisation | Étendue observée des prédictions |
|---|---|---|---|
| logreg | 22 | \(\lambda = 1000\) (\(C \approx 0.001\)) | 0.19 → 0.83, une seule tranche extrême peuplée |
| final / push / assault / lastmile / segmodel | 32 → 54 | \(C = 0.3\) | 0.13 → 0.87, tranches extrêmes bien remplies |
Le réglage de \(C\), mesuré
Le modèle final a balayé \(C\) sur la validation temporelle interne (les 42 jours
précédant le holdout, jamais le holdout lui-même) :
| \(C\) | 0.03 | 0.1 | 0.3 | 1.0 | 3.0 |
|---|---|---|---|---|---|
| Brier validation | 0.2290 | 0.2287 | 0.2285 | 0.2285 | 0.2285 |
Le plateau est franc : de 0.3 à 3.0, tout se vaut à 0.0000 près. Le choix de \(C = 0.3\) est celui du plus petit \(C\) (donc du modèle le plus contraint) parmi les ex æquo — la règle du rasoir appliquée aux hyperparamètres. Cette valeur a ensuite été conservée par toutes les approches suivantes, jusqu'au leader.
Erreur fréquente
Régler \(C\) sur le holdout. Le holdout n'a été touché qu'une fois par approche, pour le tableau final. Tout le réglage se fait sur une fenêtre de validation antérieure, elle-même hors du jeu d'ajustement. Sans cette discipline, un plateau comme celui ci-dessus devient un piège : on choisirait le meilleur des cinq chiffres, qui n'est meilleur que par le bruit.
La standardisation
La pénalité L2 traite tous les poids de la même façon : \(w_j^2\) pour tous. Or nos
features ont des échelles sans rapport — melo_diff se compte en centaines de points
d'Elo, lan vaut 0 ou 1, rest_diff en jours entre −14 et +14. Sans précaution, la
pénalité écraserait les features à petite échelle (qui ont besoin de gros poids) et
laisserait tranquilles celles à grande échelle.
On standardise donc chaque feature :
où \(\mu_j\) et \(s_j\) sont la moyenne et l'écart-type de la feature \(j\). Chaque feature standardisée a alors une moyenne de 0 et un écart-type de 1, et les poids deviennent comparables entre eux — c'est ce qui permet de lire le tableau de poids plus haut comme un classement d'importance.
Deux détails d'implémentation ont leur importance, tous deux visibles dans le code de
production (vrs/winprob.py) :
- \(\mu_j\) et \(s_j\) sont calculés sur le jeu d'entraînement seul, puis appliqués tels quels à la validation et au holdout. Les recalculer sur le holdout serait une fuite du futur, faible mais réelle ;
- un \(s_j\) nul (feature constante) ferait diverger la division : le code ajoute \(10^{-9}\) au dénominateur.
Pour aller plus loin — que deviennent les valeurs manquantes ?
Beaucoup de nos features n'existent pas pour tous les matchs : pas de données
d'économie pour une équipe rarement couverte, pas de rang HLTV daté, pas de page de
maps. Le code remplace ces NaN par zéro dans les unités brutes, avant
standardisation (np.nan_to_num est appliqué à la matrice brute). Comme presque
toutes nos features sont des écarts entre deux équipes, zéro y signifie « pas de
différence connue » : c'est la valeur neutre, ce qui rend le choix défendable. Il ne
le serait pas pour une feature de niveau absolu, où zéro n'a aucun sens neutre.
La pondération par récence
Le CS2 de janvier n'est pas celui d'août : les rosters changent, les patchs modifient le jeu, les équipes montent et descendent. Un match vieux d'un an contient donc moins d'information sur demain qu'un match de la semaine dernière — mais il en contient encore.
La réponse standard est de pondérer chaque match d'entraînement par une exponentielle décroissante de son âge :
où \(\Delta t_i\) est l'âge du match \(i\) en jours (mesuré depuis le match le plus récent du jeu d'entraînement) et \(H\) est la demi-vie : le nombre de jours au bout duquel un match ne pèse plus que la moitié d'un match d'aujourd'hui. Ces poids entrent dans la perte :
Quelques valeurs concrètes :
| Âge du match | \(H = 180\) j | \(H = 365\) j | \(H = \infty\) (pas de décroissance) |
|---|---|---|---|
| 90 jours | 0.71 | 0.84 | 1.00 |
| 365 jours | 0.25 | 0.50 | 1.00 |
| 730 jours | 0.06 | 0.25 | 1.00 |
Notre mesure : la demi-vie a fini par disparaître
C'est un des réglages qui a le plus bougé pendant la campagne, et la trajectoire est instructive.
push(40 features, entraînement sur ~4 900 matchs, fenêtre 6 mois) a retenu \(H = 180\) jours : Brier validation 0.2270 contre 0.2272 sans décroissance à \(C = 0.3\). Un gain minuscule, mais un gain.assaulta étendu la fenêtre de données à 12 mois (10 287 matchs d'entraînement) et retenu \(H = 365\) jours.lastmilea rebalayé la grille complète \(C \times H\) sur la même fenêtre. Résultat :
| \(C\) | \(H = 240\) | \(H = 365\) | \(H = 550\) | \(H = 730\) | \(H = \infty\) |
|---|---|---|---|---|---|
| 0.15 | 0.2172 | 0.2172 | 0.2171 | 0.2171 | 0.2170 |
| 0.3 | 0.2172 | 0.2171 | 0.2170 | 0.2170 | 0.2169 |
| 0.6 | 0.2171 | 0.2171 | 0.2170 | 0.2170 | 0.2169 |
La tendance est monotone et cohérente sur les trois lignes : plus la demi-vie est
longue, mieux c'est, et l'optimum est à l'infini — c'est-à-dire pas de pondération du
tout. C'est le réglage adopté par lastmile puis par le leader segmodel
(half_life = 0 dans le code, qui signifie « aucune décroissance »).
Intuition — pourquoi la récence a cessé de payer
La pondération temporelle résout un problème : donner plus de poids à ce qui ressemble à demain. Mais elle en crée un autre : elle réduit la taille effective de l'échantillon. Avec \(H = 180\) jours sur une fenêtre de 12 mois, la moitié la plus ancienne des matchs ne pèse presque plus rien — on perd des milliers de lignes.
Or entre push et lastmile, deux choses ont changé. D'abord la fenêtre est passée
de 6 à 12 mois, donc l'échantillon perdu est plus gros. Ensuite et surtout, les
features elles-mêmes se sont mises à porter la récence : TrueSkill, Glicko-2,
l'Elo à marge, la forme sur 5 et 10 matchs, le momentum sur 7 et 21 jours sont
déjà des résumés récents de l'état des équipes. Une fois que les features
oublient le passé, il devient inutile — et coûteux — que la perte l'oublie une
seconde fois.
C'est une hypothèse d'interprétation ; le fait mesuré, lui, est le tableau ci-dessus.
Pourquoi elle a battu les arbres, ici
C'est la question qui structure toute la partie, et la réponse tient en une phrase : parce que nos features avaient déjà fait le travail non linéaire.
Regardez ce que le modèle reçoit en entrée. Ce ne sont pas des données brutes : ce sont
des écarts entre deux équipes (ts_diff, melo_diff, hr_rank_diff,
round_share_diff), et parfois directement des probabilités transformées
(logit_glicko, ts_valve_disagree, qui est une différence de deux probabilités). Or
un écart de rating est, par construction, la quantité dont dépend linéairement le logit
dans tous les modèles de force : Elo, Glicko et TrueSkill
supposent tous que la probabilité de victoire est une fonction sigmoïde de la différence
de niveau.
Autrement dit, la sigmoïde du modèle logistique est exactement la forme fonctionnelle que les horloges attendent. Il n'y a plus grand-chose à courber.
   Frontière de décision dans le plan (écart TrueSkill, écart de rang HLTV)

   rang HLTV │                     ╱                 ╱ = frontière apprise
             │        ○  ○       ╱   ×               ○ = équipe 1 perd
             │     ○      ○    ╱  ×   ×              × = équipe 1 gagne
             │  ○   ○   ○    ╱  ×  ×
             │    ○  ○     ╱ ×   ×   ×
             │  ○      ○ ╱  ×  ×
             └───────────────────────────── écart TrueSkill

   Une droite sépare presque aussi bien qu'une frontière en escalier — et une
   droite ne peut pas, elle, apprendre le bruit des 6 000 lignes d'entraînement.
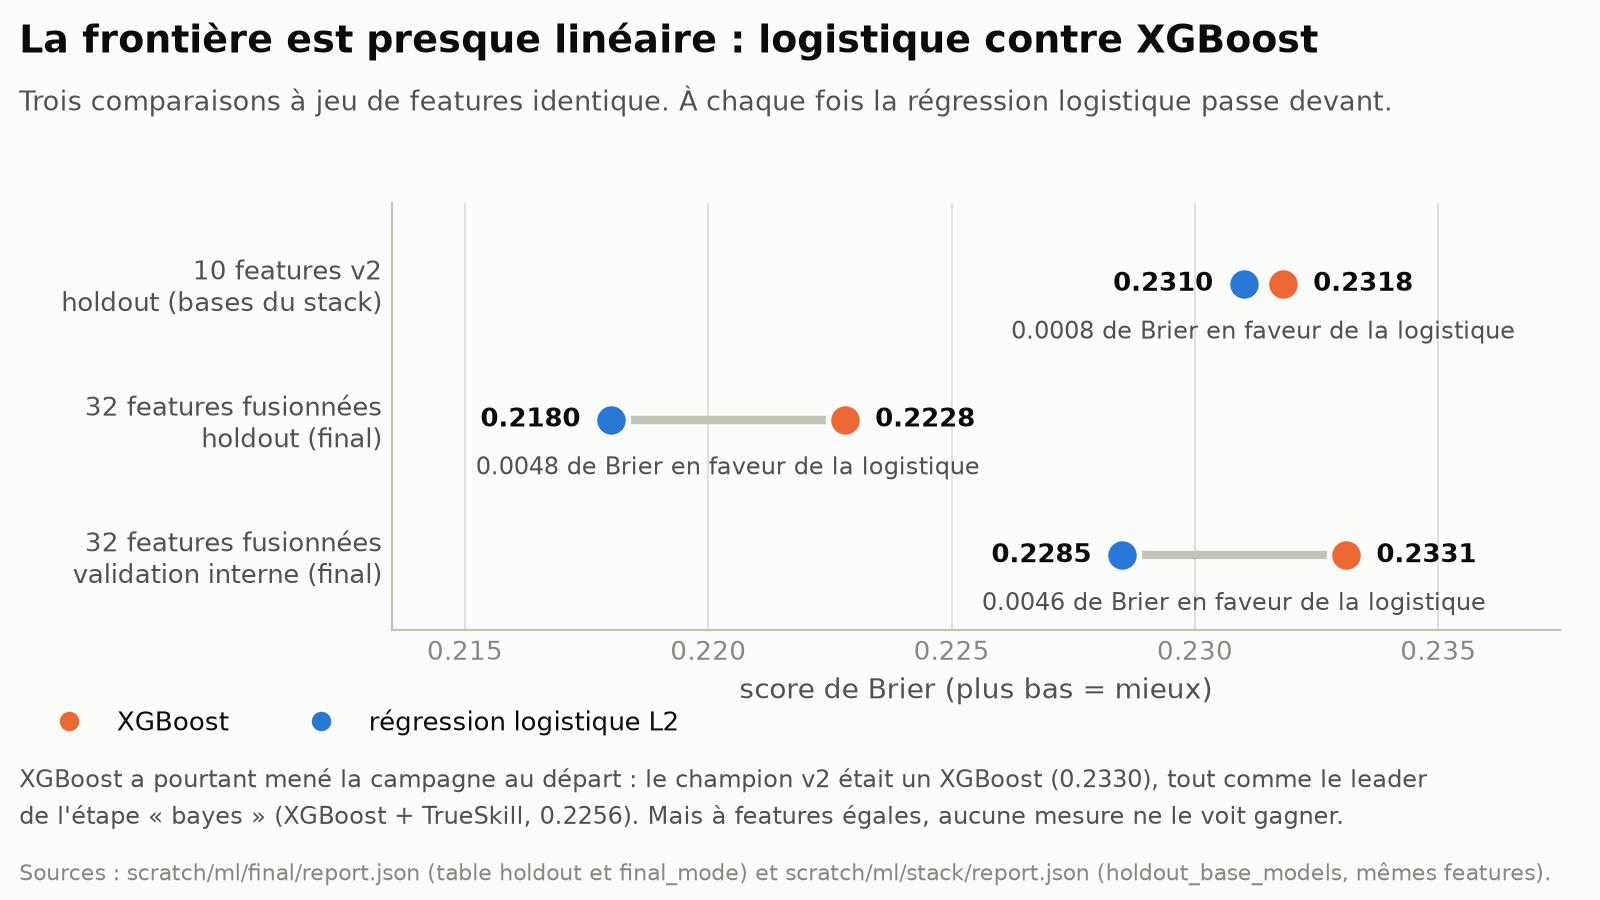
Voir aussi la figure frontiere-lineaire.png,
qui compare logistique et XGBoost à features égales.
Le fait mesuré, quatre fois
Ce n'est pas une intuition, c'est une comparaison répétée à features strictement égales.
| Comparaison | Logistique | XGBoost | Écart |
|---|---|---|---|
final, 32 features, validation |
0.2285 | 0.2331 | 0.0046 |
final, 32 features, holdout |
0.2180 | 0.2224 | 0.0044 |
push, 40 features, validation |
0.2263 | 0.2302 | 0.0039 |
stack, 10 features du champion, holdout |
0.2310 | 0.2318 | 0.0008 |
La dernière ligne est la plus intéressante : même sur les 10 features brutes du champion, terrain historique de XGBoost, la logistique était déjà très légèrement devant. L'avantage des arbres n'a donc jamais été grand ici ; il a simplement disparu pour de bon quand les features sont devenues riches.
Confirmé deux fois, indépendamment
Le mémoire de l'université de Lund sur la prédiction CS2 rapporte une régression logistique à log-loss 0.62 et 65 % d'accuracy (résultat de littérature, sur un autre pool de matchs que le nôtre). Nos leaders arrivent à log-loss 0.5916 et 67.9 % — sur des matchs plus faciles, puisque notre pool mêle tier 1 et tier 3.
Ce qui compte n'est pas la comparaison des niveaux, impossible à faire proprement, mais la convergence méthodologique : une équipe indépendante, avec ses propres données, a elle aussi trouvé qu'une régression logistique était le bon outil pour ce problème.
Limite importante — ce résultat n'est pas général
« La logistique bat les arbres » est faux en général sur données tabulaires ; la littérature dit plutôt le contraire, et notre propre champion de départ était un XGBoost. Ce qui est vrai, c'est : lorsque les features encodent déjà des différences de force et des probabilités, la frontière optimale est proche d'un hyperplan, et un modèle linéaire régularisé y est difficile à battre.
Le corollaire pratique est important : le mérite du résultat revient au travail sur les features, pas au choix de l'algorithme.
Le modèle final, en une fiche
Voici tout ce qu'il faut pour reconstruire le cœur du leader (le blend par segments est l'objet du chapitre 3) :
| Élément | Valeur |
|---|---|
| Forme | \(p = \sigma(\mathbf{w}^\top \tilde{\mathbf{x}} + b)\) |
| Features | 54 (46 sélectionnées + 8 d'interaction par segment) |
| Régularisation | L2, \(C = 0.3\), intercept non pénalisé |
| Pondération temporelle | aucune (demi-vie infinie) |
| Standardisation | moyenne/écart-type du jeu d'entraînement, NaN → 0 brut |
| Entraînement | 10 287 matchs (fenêtre 12 mois) |
| Optimiseur | L-BFGS via scikit-learn, max_iter = 2000 |
| Résultat holdout | Brier 0.2041, log-loss 0.5916, accuracy 67.9 %, 1 146 matchs |
À retenir
L'essentiel du chapitre
- Une régression logistique est un barème : somme pondérée de features, écrasée par une sigmoïde ; ses poids se lisent en logarithme de cote.
- Elle s'entraîne en maximisant la log-vraisemblance, ce qui revient à minimiser la log-loss — le critère d'entraînement est le critère d'évaluation.
- Le problème est convexe : pas de graine, pas de minimum local, deux entraînements identiques.
- La régularisation L2 rétrécit les poids vers zéro, donc les prédictions vers 50 %. Notre premier modèle, très régularisé, n'a jamais annoncé plus de 87 % ni moins de 19 %.
- La pondération par récence, utile au début (\(H = 180\) j), est devenue nuisible quand la fenêtre est passée à 12 mois et que les features ont pris en charge la récence : l'optimum final est \(H = \infty\).
- Elle a battu XGBoost ici parce que les features sont des écarts de force et des probabilités — pas parce que le simple gagne toujours.
Le chapitre suivant prend le problème par l'autre bout : le gradient boosting, comment il fonctionne, comment il a été réglé, et pourquoi il a perdu son titre.