Les familles de features
Le leader final, segmodel, mange 54 colonnes. Ce chapitre les prend une par une.
Elles ne sont pas arrivées ensemble. Chaque famille est le produit d'une approche du concours, et chaque approche a laissé un rapport chiffré : ce qu'elle a construit, ce que ça a rapporté, et ce qu'elle a jeté. Le catalogue ci-dessous suit cette généalogie.
Comment lire ce catalogue
Deux notions d'importance coexistent dans les rapports, et elles ne mesurent pas la même chose.
L'importance interne au modèle. Pour les approches à base d'arbres (stats, maps),
XGBoost fournit un gain par feature — la réduction de perte que les découpes sur cette
variable ont apportée, sommée sur tous les arbres. C'est un nombre relatif, comparable entre
les features d'un même modèle, et sans signification absolue. Dans le modèle maps à 19
features, les gains vont de 22,5 (round_share_diff) à 4,9 (form5_diff) et somment à
environ 171.
Le gain incrémental de Brier. Plus lent à obtenir, mais bien plus honnête : on entraîne
sans la famille, on entraîne avec, et on regarde l'écart de Brier sur les mêmes matchs.
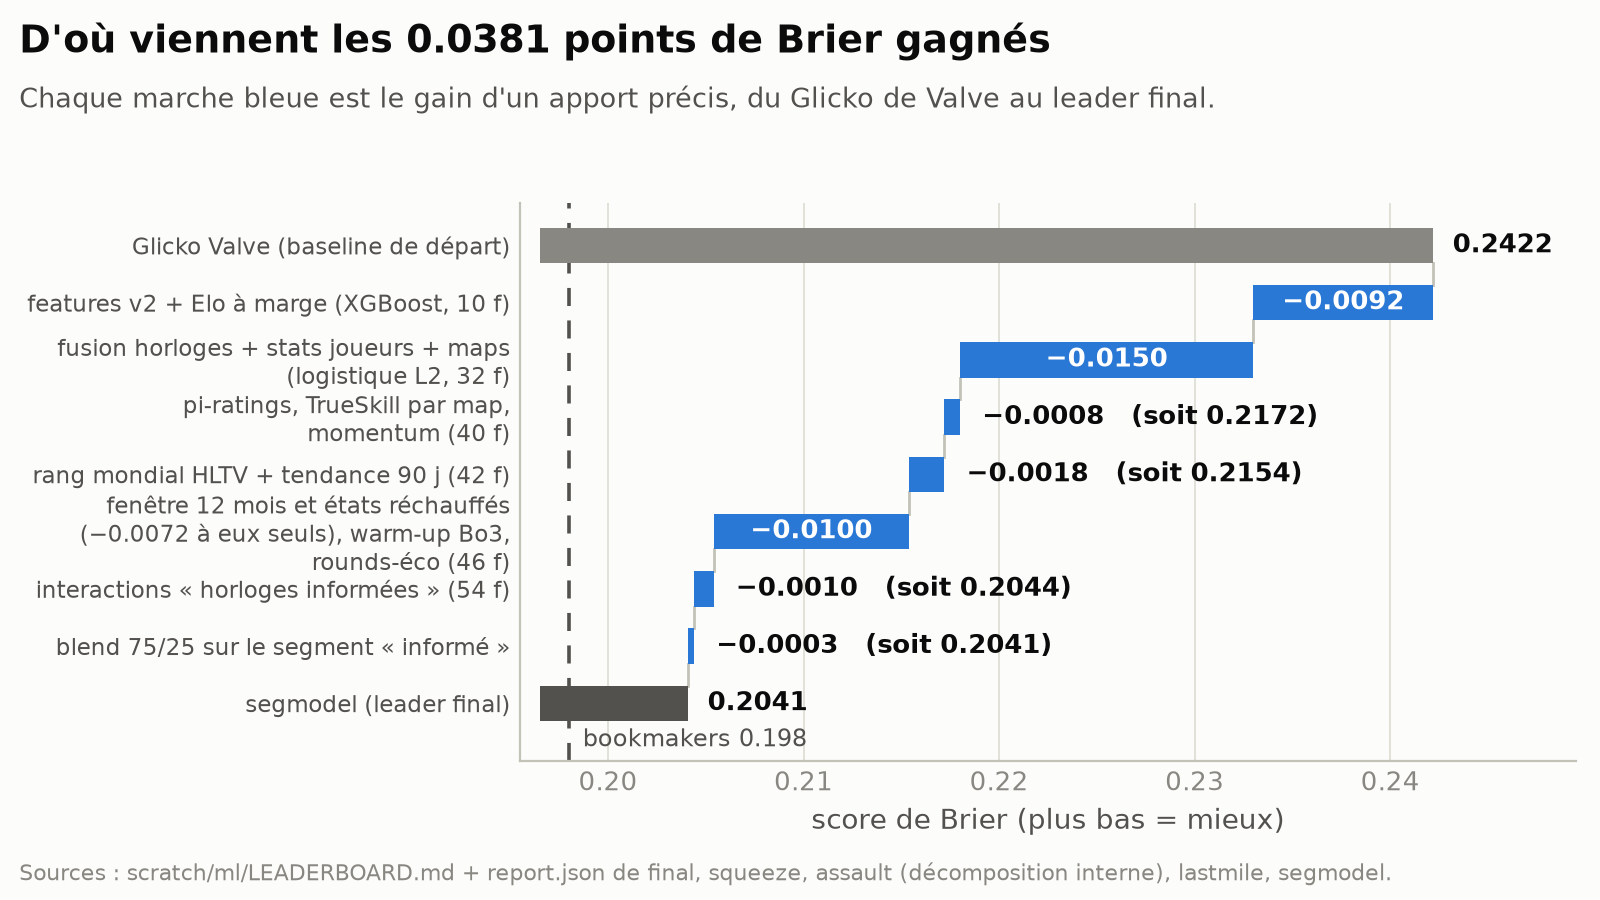
C'est ce que font les tables de validation de squeeze et d'assault. Un gain de 0,0010 de
Brier est déjà substantiel à ce niveau ; l'écart total entre le champion de départ et le
leader final est de 0,0289.
Erreur fréquente
Une importance XGBoost élevée ne prouve pas qu'une feature apporte de l'information nouvelle. Elle prouve que le modèle s'en sert. Deux features parfaitement redondantes se partagent l'importance et pèsent chacune la moitié de ce qu'elles vaudraient seules. C'est pour cette raison que le classement final des familles se lit sur les gains incrémentaux, pas sur les gains d'arbres.
Vue d'ensemble des 54 colonnes
| famille | nombre | provenance | gain incrémental mesuré |
|---|---|---|---|
| horloges | 12 | calculées, bo3.gg pour le réchauffage | −0,0072 (états chauds) et −0,0015 (warm bo3) |
| forme et momentum | 9 | listings de résultats | incluses dans le champion de départ |
| statistiques individuelles | 7 | tables totalstats des pages de match |
−0,0042 |
| maps et rounds | 9 | veto, scores par map, mi-temps CT/T | −0,0038 |
| économie bo3 | 3 | API bo3.gg, 209 482 rounds | −0,0014 |
| rang mondial daté | 2 | tooltips fusioncharts des pages équipe | −0,0018 |
| contexte de l'événement | 2 | pages d'événement | incluses dans le champion |
| interactions et segment | 10 | dérivées des précédentes | −0,0013 |
Les gains ne s'additionnent pas : ils ont été mesurés à des étapes différentes de la campagne, sur des baselines différentes, et les familles se recouvrent partiellement.
Famille 1 — les horloges (12 features)
Une « horloge » est un système de rating qui avance match après match : Elo, Glicko, TrueSkill, pi-ratings. Les mathématiques de chacune sont traitées dans la partie qui leur est consacrée ; ici, on ne décrit que la colonne qu'on en extrait.
Le principe est toujours le même : on prend l'écart entre les deux équipes, et pour les horloges bayésiennes on prend aussi la somme des incertitudes.
| feature | construction | source |
|---|---|---|
glicko_diff |
\(R_a - R_b\), Glicko de Valve | calculée par balayage |
melo_diff |
\(m_a - m_b\), Elo à marge \(K=30\) | calculée par balayage |
ts_diff |
\(\sum \mu_a - \sum \mu_b\), TrueSkill par joueur | calculée par balayage |
ts_sigma_sum |
\(\sqrt{\sum \sigma^2}\) sur les 10 joueurs | calculée par balayage |
tsm_diff |
idem, TrueSkill mis à jour par map | scores par map du cache |
tsm_sigma_sum |
incertitude de l'horloge par map | scores par map du cache |
g2_diff |
\(\mu_a - \mu_b\), Glicko-2 par joueur | calculée par balayage |
g2_phi_sum |
somme des déviations Glicko-2 | calculée par balayage |
pi_diff_a |
pi-rating d'attaque, \(\lambda = 0{,}06\) | scores par map du cache |
wmelo_diff |
Elo à marge réchauffé depuis 2024 | bo3.gg, 40 023 matchs |
ts_valve_disagree |
\(p_{\text{TS}} - p_{\text{Glicko Valve}}\) | dérivée |
ts_g2_disagree |
\(p_{\text{TS}} - p_{\text{Glicko-2}}\) | dérivée |
Les incertitudes ne sont pas décoratives
ts_sigma_sum mérite une mention à part : c'est la feature qui pilote tout le blend final.
Sa valeur est la racine de la somme des variances des dix joueurs :
Une somme faible signifie que TrueSkill connaît bien les vingt-cinq derniers mois de ces dix
joueurs. Une somme élevée signifie qu'au moins un joueur est neuf pour l'horloge. Le leader
segmodel coupe le jeu de données à la médiane de cette quantité et entraîne un modèle
séparé sur le segment « informé », qu'il mélange au modèle global dans un rapport 75/25 de
logits. Résultat : 0,2054 → 0,2041.
C'est la seule feature du catalogue qui sert à la fois de variable explicative et de variable de segmentation.
Les désaccords d'horloges
ts_valve_disagree et ts_g2_disagree sont des différences de probabilités, pas de
ratings. L'idée vient de l'approche logreg, dont le rapport note que « le désaccord des
horloges = signal » : quand deux systèmes de rating construits différemment donnent des
verdicts opposés, le match est plus incertain qu'aucune des deux horloges ne le croit.
Ces deux colonnes ont survécu jusqu'au modèle final. Une tentative plus ambitieuse de capturer la même idée a en revanche échoué — voir la section sur les échecs, plus bas.
Le réchauffage : la plus grosse feature de la campagne
wmelo_diff est un Elo à marge identique à melo_diff, à une différence près : il a tourné
sur 40 023 matchs bo3.gg depuis janvier 2024 avant d'arriver à la fenêtre d'entraînement, au
lieu de démarrer tout le monde à 1500.
L'appariement se fait par nom normalisé — accents retirés, tout en minuscules, tout ce qui n'est pas alphanumérique supprimé :
def _norm_name(s):
    s = unicodedata.normalize("NFKD", s).encode("ascii", "ignore").decode()
    return re.sub(r"[^a-z0-9]", "", s.lower())
La feature est NaN tant que les deux équipes ne sont pas connues du réchauffage. Gain
mesuré seul, sur le holdout : 0,2078 → 0,2063, soit −0,0015.
Mais le vrai enseignement du réchauffage n'est pas cette colonne. C'est le passage des
horloges natives de l'état froid à l'état chaud : 0,2153 → 0,2081, soit −0,0072, le
plus gros gain unitaire de toute la campagne. Le rapport d'assault le formule sans
ambiguïté : « le gros du gain : la faiblesse n°1 était bien le démarrage à froid ». Le
mécanisme est disséqué dans le chapitre
Démarrage à froid.
À retenir
Six mois d'historique supplémentaire donné aux mêmes horloges, avec les mêmes hyperparamètres et le même modèle, ont rapporté cinq fois plus que la meilleure famille de features nouvelles de la campagne.
Famille 2 — forme et momentum (9 features)
Toutes calculées depuis les listings de résultats, sans page supplémentaire. Six viennent du
champion de départ, trois ont été ajoutées par l'approche push.
| feature | construction | portée |
|---|---|---|
form5_diff |
victoires sur 5, écart | \([-5, +5]\) |
form10_diff |
victoires sur 10, écart | \([-10, +10]\) |
h2h_balance |
bilan signé des confrontations directes | souvent 0 |
experience_diff |
\(\log(1+n_a) - \log(1+n_b)\) | fenêtre courante |
rest_diff |
jours depuis le dernier match, bornés à 14 | \([-14, +14]\) |
stability_diff |
recouvrement de line-up, écart | \([-1, +1]\) |
n7_diff |
matchs joués sur 7 jours, écart | densité récente |
n21_diff |
matchs joués sur 21 jours, écart | densité moyenne |
streak_diff |
longueur de la série de victoires en cours, écart | \(\geq 0\) chacune |
Le calcul des trois dernières tient en quelques lignes : on parcourt l'historique de chaque équipe, on compte les matchs dans les fenêtres de 7 et 21 jours, et on remonte à rebours tant que l'équipe gagne pour la série en cours.
Exemple numérique. Une équipe qui vient d'enchaîner un tournoi a n7 = 5 et
n21 = 12 ; son adversaire, qui sort d'une pause, a n7 = 0 et n21 = 2.
n7_diff = 5, n21_diff = 10, et rest_diff est fortement négatif. Trois colonnes qui
décrivent la même situation sous trois angles — c'est assumé : la régularisation \(L_2\) à
\(C = 0{,}3\) est là pour répartir le poids entre elles.
Dans le champion à 10 features, form10_diff pèse 16,5 en importance XGBoost — deuxième
position derrière melo_diff. form5_diff pèse 3,8, dernière position. La fenêtre courte
est du bruit, la fenêtre longue est du signal.
Famille 3 — statistiques individuelles (7 features)
C'est la première famille vraiment neuve de la campagne, et elle vient d'un gisement qui
dormait : les 9 112 pages /matches/ du cache contiennent des tables table.totalstats par
joueur, jamais parsées jusque-là. K-D, eK-eD, Swing, ADR, eADR, KAST, eKAST et un rating
3.0 uniforme sur tout le cache. 8 376 pages ont effectivement des statistiques ; le reste
sont des forfaits ou des matchs non joués.
La construction en deux temps
Temps 1 — par joueur. On maintient, pour chaque joueur, la liste de ses \(W = 10\) derniers matchs sous forme de triplets \((\text{rating}, \text{ADR}, \text{KAST})\). La moyenne glissante de ce joueur est la moyenne de ces dix triplets.
Temps 2 — agrégation en équipe. À partir des cinq moyennes glissantes des cinq joueurs alignés, on calcule sept quantités :
\(\bar{r}\) est le niveau moyen de l'équipe, \(r^{\star}\) son meilleur joueur (le « star player »), \(s_r\) son hétérogénéité interne. On ajoute l'ADR moyen, le KAST moyen, la couverture — la part des cinq joueurs pour lesquels on a un historique — et la part de rounds gagnés par l'équipe sur ses dix derniers matchs. Chaque quantité est ensuite différenciée entre les deux équipes.
| feature | ce qu'elle capte |
|---|---|
prat_mean_diff |
écart de niveau moyen (rating 3.0) |
prat_star_diff |
écart entre les meilleurs joueurs |
prat_std_diff |
écart d'hétérogénéité : équipe équilibrée vs portée par un joueur |
padr_diff |
écart de dégâts moyens par round |
pkast_diff |
écart de KAST |
pcov_diff |
écart de couverture — combien on connaît chaque équipe |
rshare_diff |
écart de part de rounds gagnés (glissant) |
Exemple numérique. Une équipe dont les cinq joueurs tournent à 1,15 / 1,10 / 1,05 / 1,00 / 0,95 a \(\bar{r} = 1{,}05\), \(r^{\star} = 1{,}15\) et \(s_r \approx 0{,}071\). Une équipe dont un joueur tourne à 1,40 et les quatre autres à 0,95 a le même \(\bar{r} = 1{,}04\), mais \(r^{\star} = 1{,}40\) et \(s_r \approx 0{,}18\). Les trois colonnes ensemble distinguent ces deux profils ; \(\bar{r}\) seul ne le ferait pas.
Ce que ça a rapporté
Sur le holdout de 1 119 matchs : champion 0,2331 → 0,2289, exactitude 60,0 % → 62,0 %. Gain de 0,0042 de Brier.
Et une surprise dans le classement d'importance XGBoost :
| feature | gain | rang |
|---|---|---|
melo_diff |
19,6 | 1 |
pkast_diff |
16,8 | 2 |
prat_mean_diff |
13,8 | 3 |
form10_diff |
13,8 | 4 |
pcov_diff |
11,9 | 5 |
Le KAST — la part des rounds où un joueur tue, meurt, assiste ou est tradé — arrive deuxième, devant le rating lui-même. C'est cohérent avec ce que le KAST mesure : la régularité de la contribution, pas les pics.
Et pcov_diff, cinquième, est une feature purement méta : elle ne dit rien du jeu, elle dit
à quel point nos données couvrent chaque équipe. Le modèle apprend à se méfier de
lui-même quand une équipe est mal couverte.
Intuition
La fenêtre \(W = 10\) n'a jamais été réglée. Le rapport le précise : « Fenêtre W=10 non réglée (pas de pêche au holdout) ». C'est une valeur choisie a priori et laissée telle quelle, pour ne pas transformer le holdout en jeu de validation déguisé. Un réglage de \(W\) apporterait peut-être quelques millièmes — au prix de la crédibilité de la mesure.
Famille 4 — maps et rounds (9 features)
Même gisement — les pages de match du cache — mais une autre partie de la page : le veto complet (qui bannit et pick quelle map), les scores par manche avec les mi-temps CT et T, et le bloc « Head to head » daté ligne par ligne. Sur 7 148 pages minées, 6 631 ont un veto et 6 523 ont les scores par map avec mi-temps.
round_share_diff : la feature n°1 du concours
La somme porte sur les 30 dernières manches de l'équipe, pas les 30 derniers matchs — une équipe qui joue des Bo3 accumule deux à trois manches par match. La feature est l'écart entre les deux équipes.
Dans le modèle maps, cette colonne obtient un gain XGBoost de 22,5, devant melo_diff
à 19,0. C'est la seule fois de la campagne où une feature autre qu'une horloge prend la
première place.
Intuition
Un match se gagne 2-0 ou 2-1 : deux issues possibles, très peu d'information. Une manche
se gagne 13-4 ou 13-11 : la part de rounds distingue une domination d'une victoire
arrachée. Le résultat binaire jette cette nuance ; round_share_diff la récupère.
C'est exactement le même raisonnement que l'Elo à marge, appliqué un cran plus bas.
Les côtés CT et T
CS2 est asymétrique : les deux camps n'ont ni le même équipement, ni le même objectif. Une équipe peut être excellente en défense et médiocre en attaque. Deux colonnes séparent ces deux compétences :
calculées sur les dix dernières apparitions par map, toutes maps confondues. ct_share_diff
obtient un gain de 11,3 — quatrième position. t_share_diff obtient 6,1. L'asymétrie de
l'asymétrie : le côté CT porte plus d'information que le côté T.
Le veto simulé
Les trois features de pool de maps reposent sur une simulation du veto. Chaque équipe bannit ses deux maps les plus souvent bannies dans le passé — ou, à défaut d'historique de bans, ses deux pires maps. Ce qui reste est le pool probable de la rencontre.
| feature | construction |
|---|---|
exp_mapwr_diff |
moyenne des écarts de winrate sur les maps probablement jouées |
best_map_edge |
\(\max_m (w_a(m) - w_b(m)) + \min_m (w_a(m) - w_b(m))\) |
pool_depth_diff |
nombre de maps du pool à winrate \(> 0{,}52\), écart |
Le winrate par map \(w(m)\) n'est pas une fréquence brute : il est rétréci vers le winrate global de l'équipe, avec un a priori de 5 victoires sur 10 matchs. Sur une map jouée deux fois, la fréquence brute vaut 0 ou 0,5 ou 1 ; le rétrécissement la ramène près de la moyenne de l'équipe.
best_map_edge mérite un mot : la somme du meilleur et du pire écart mesure si l'avantage
d'une équipe est concentré sur une map (grand max, petit min, somme moyenne) ou
réparti (max et min tous deux positifs, somme élevée). Une équipe qui domine partout
n'est pas dans la même situation qu'une équipe qui domine sur une seule map que l'adversaire
peut bannir.
Le head-to-head par maps et le compteur de fiabilité
h2h_maps_diff reprend le bloc « Head to head » de la page de match : le nombre de manches
gagnées par chacun dans leurs confrontations passées, y compris au-delà de la fenêtre de six
mois. h2h_maps_n est le \(\log(1+n)\) du nombre de manches connues : il permet au modèle de
pondérer le bilan par sa fiabilité.
veto_n joue le même rôle pour les features de pool : c'est le minimum du nombre de bans
connus des deux équipes. Une valeur faible signale que la simulation de veto repose sur
presque rien.
À retenir
Trois des neuf colonnes de cette famille — pcov_diff chez les stats, h2h_maps_n et
veto_n ici — ne parlent pas du jeu. Elles disent au modèle combien il peut faire
confiance aux autres colonnes. C'est un motif de conception qui revient à chaque
famille et qui, à chaque fois, obtient une importance non négligeable.
Ce que ça a rapporté
Sur le holdout de 1 141 matchs : champion 0,2331 → 0,2293, log-loss 0,6568 → 0,6474. Gain de 0,0038. L'exactitude, elle, ne bouge presque pas (59,4 % → 59,8 %) : la famille améliore surtout la calibration des probabilités, pas le côté du pari.
Famille 5 — économie bo3 (3 features)
La famille est traitée en détail au chapitre 4. Résumé ici.
| feature | construction | fenêtre |
|---|---|---|
eco_clutch_diff |
taux de réussite des tentatives de clutch | 60 derniers |
eco_adv_diff |
taux de victoire en situation d'avantage d'équipement | 120 derniers |
eco_eff_diff |
rounds gagnés par tranche de 10 000 $ dépensés | 200 derniers |
Ce sont trois survivantes d'une famille de huit, sélectionnées par une recherche gloutonne sur le jeu de validation. Les cinq écartées portaient sur les rounds pistolets, les situations de désavantage, les premiers kills et leur conversion.
Gain mesuré seul sur le holdout : 0,2078 → 0,2064, soit −0,0014.
Famille 6 — rang mondial HLTV daté (2 features)
Le classement mondial de HLTV est une opinion externe : un panel, une méthodologie différente de la nôtre, et surtout une profondeur temporelle que notre fenêtre de six mois n'a pas.
La source est inattendue. Les pages /team/<id> déjà présentes dans le cache embarquent un
graphique fusioncharts dont les tooltips contiennent l'historique complet du rang mondial de
l'équipe, daté point par point, de 2016 à 2026. Extraction : zéro requête réseau.
66 860 points au total sur 656 équipes, dont 494 avec un historique de ranking exploitable.
Le logarithme et l'inversion sont tous deux délibérés. L'inversion parce qu'un rang bas est bon : la feature doit être positive quand \(a\) est meilleure. Le logarithme parce que l'écart entre le 1ᵉʳ et le 5ᵉ mondial est immense, tandis que celui entre le 120ᵉ et le 124ᵉ ne veut rien dire.
La tendance sur 90 jours, différenciée. Positive pour une équipe qui monte.
Exemple numérique. L'équipe \(a\) est 12ᵉ, l'équipe \(b\) est 47ᵉ. \(\text{hr\_rank\_diff} = \ln(47) - \ln(12) = 3{,}850 - 2{,}485 = 1{,}365\). Si \(a\) était 3ᵉ et \(b\) 12ᵉ — un écart de neuf places seulement, contre trente-cinq — on aurait \(\ln(12) - \ln(3) = 1{,}386\), une valeur quasi identique. C'est exactement ce qu'on veut : le logarithme rend comparables des écarts de rang situés à des altitudes différentes.
Une astuce de repli complète le dispositif : quand l'historique ne couvre pas la date du match, le code se rabat sur le rang mondial affiché sur la page du match elle-même, qui est daté par le lien vers l'archive du classement de la semaine. Cela ajoute 37 lignes de couverture — marginal, mais gratuit.
Ce que ça a rapporté, et la validation croisée qui rassure
Sur le holdout de 1 146 matchs : 0,2172 → 0,2154, exactitude 64,0 % → 64,6 %. Gain de 0,0018, obtenu par la seule ajout de deux colonnes.
Mieux : cette source a été validée indépendamment. Les archives hebdomadaires
/ranking/teams de 2026 (30 semaines de classement) donnent le même rang que l'historique
des tooltips dans 99,8 % des cas d'accord exact. Une source exotique confirmée par une
source officielle : rare, et rassurant.
Famille 7 — le contexte de l'événement (2 features)
lan vaut 1 si le match se joue en LAN, 0 sinon. C'est la feature la plus simple du
catalogue et l'une des plus utiles : le segment LAN du holdout affiche un Brier de 0,1722 et
74,7 % d'exactitude, contre 0,2041 et 67,9 % en global. Les matchs LAN sont structurellement
plus prévisibles — moins de surprises, des équipes qualifiées donc établies, pas de problème
de latence.
stakes est le poids de l'événement calculé par le moteur VRS. Ce n'est pas la dotation
brute : c'est la dotation augmentée de celle de l'événement auquel il qualifie, divisée
par deux à chaque palier et plafonnée à un million de dollars. Cette subtilité a coûté une
correction entière au moteur — sans elle, le poids d'un tour préliminaire de Major était faux
d'un facteur deux (0,477 calculé contre 0,809 publié).
Ces deux colonnes ont une particularité en simulation : elles ne viennent pas de l'état mais du calendrier, et sont donc injectées au moment de la prédiction plutôt que mémoïsées avec le reste.
Famille 8 — interactions et segment (10 features)
Les dix dernières colonnes sont dérivées des précédentes. Deux interactions viennent de
push :
ts_diff * ts_sigma_sum— l'écart TrueSkill pondéré par l'incertitude : un écart de 10 points entre deux équipes bien connues ne vaut pas un écart de 10 points entre deux inconnues.melo_diff * form5_diff— l'écart Elo pondéré par la forme récente.
Puis le bloc du leader : une indicatrice inf valant 1 quand ts_sigma_sum est sous la
médiane du jeu d'entraînement, et ses sept produits avec les features les plus fortes —
melo_diff, ts_diff, glicko_diff, hr_rank_diff, round_share_diff, wmelo_diff,
pi_diff_a.
L'idée, venue de lastmile, est qu'une horloge ne se lit pas de la même façon selon qu'elle
est informée ou non. Multiplier inf par une feature revient à donner au modèle deux
coefficients pour cette feature : un pour le régime informé, un pour le régime incertain.
Gain de ce bloc : 0,2054 → 0,2044. Puis le blend par segment de segmodel :
0,2044 → 0,2041. Ensemble, 0,0013 de Brier — la contribution totale de la modélisation
pure sur les deux dernières étapes de la campagne.
Ce qui n'a RIEN apporté
Cette section est la plus importante du chapitre. Quatre chantiers entiers, chacun représentant des heures de collecte et de code, pour zéro gain mesurable.
Le H2H pondéré par le recouvrement de roster
L'idée. Le head-to-head brut compare deux organisations. Mais si trois des cinq joueurs
ont changé depuis la dernière confrontation, ce bilan ne parle plus des mêmes équipes.
L'approche squeeze a donc reconstruit un H2H enrichi depuis les pages de match — rounds,
prolongations, line-ups passées lues dans les attributs title du HTML — et pondéré chaque
confrontation passée par le recouvrement de roster avec le line-up actuel.
13 385 lignes de H2H extraites, toutes avec leur line-up.
Le résultat. Baseline de validation 0,2263. Avec la famille : 0,2264. Sur le holdout : 0,2172 avec, 0,2172 sans. Rigoureusement rien.
Le diagnostic. Le rapport l'explique : « le H2H pondéré roster est déjà couvert par h2h_balance + les horloges joueur ». TrueSkill et Glicko-2 tournent par joueur, pas par équipe : quand trois joueurs changent, ces horloges suivent déjà les joueurs. L'information que la pondération de roster voulait apporter était déjà dans le modèle, sous une autre forme et mieux exprimée.
Les boîtes « Past matches » des pages d'équipe
L'idée. Chaque page d'équipe HLTV affiche un encadré de ses matchs récents. C'est de la forme, gratuite, déjà en cache.
Le résultat. Validation 0,2261 contre 0,2263 de baseline — un gain de deux dix-millièmes, soit du bruit. Sur le holdout, la famille dégrade : 0,2176 contre 0,2172.
Le diagnostic. Même mécanisme : form5_diff et form10_diff disent déjà tout ce que
cette boîte contient, et le disent depuis une source mieux datée. Au passage, huit lignes ont
dû être supprimées parce que la boîte contenait le match qu'on cherchait à prédire.
Les carrières Wayback
L'idée. Les statistiques de carrière HLTV — rating, DPR, KAST, Impact, ADR — sont
inaccessibles en direct (Cloudflare bloque /stats), mais la Wayback Machine en a archivé
des dizaines de milliers de snapshots. 966 ont été collectés en 54,8 minutes.
Le résultat. Jamais testées. Le rapport d'assault est explicite : la reprise bornée du
run a coupé ces croisements, « non testés, comme les carrières Wayback ».
Le diagnostic — et l'obstacle réel. Sur 6 056 matchs, seuls 1 145 ont leurs deux
équipes couvertes par un snapshot antérieur au match, et la couverture retenue pour le test
tombait à 1 057. Une famille de features définie sur 17 % des lignes ne peut pas déplacer un
Brier global : le modèle apprend sur les 83 % restants avec des NaN imputés à la moyenne.
Limite importante
Ce dernier point n'est pas un échec de la donnée, c'est un échec de la couverture. Il est parfaitement possible que les carrières Wayback contiennent du signal fort ; la campagne ne le saura jamais, faute d'assez de lignes pour le mesurer. C'est une différence de nature avec les deux échecs précédents, où l'absence de gain a été mesurée.
Le dissensus des horloges
L'idée. Étendre le principe de ts_valve_disagree à toutes les horloges à la fois. On
convertit chaque horloge en probabilité — Glicko de Valve, Elo à marge, TrueSkill, Glicko-2,
et quand ils existent le pi-rating et le rang HLTV — puis on résume leur désaccord :
plus le nombre d'horloges disponibles, le produit de l'écart-type par la confiance \(|\bar{p} - 0{,}5|\), et la probabilité moyenne. Cinq colonnes.
Le résultat. En validation : 0,2217 avec, 0,2219 sans. Le rapport tranche : « Le dissensus n'apporte rien de net en val ». La famille n'a pas été retenue dans les 54 features.
Le diagnostic. Les désaccords par paire (ts_valve_disagree, ts_g2_disagree) sont
déjà dans le modèle, et une régression logistique sur des écarts de ratings reconstruit une
partie du dissensus toute seule. Le résumé statistique de cinq probabilités corrélées
n'ajoute pas grand-chose à deux différences bien choisies.
Deux notes de bas de page
Le bloc « VRS result ». Certaines pages de match affichent le résultat VRS officiel de la rencontre. Il n'existe que sur 204 pages sur 7 253, soit environ 3 %. Extrait, puis déclaré inexploitable comme feature.
Les points hebdomadaires du classement. La famille D de squeeze — rang et points issus
des 30 archives hebdomadaires de 2026 — aide seule (0,2258 contre 0,2263) mais n'ajoute rien
par-dessus l'historique daté : 0,2255 pour C+D contre 0,2250 pour C seul. Redondance pure.
Elle a néanmoins servi à valider C à 99,8 %, ce qui était son meilleur usage possible.
Le catalogue en une page
  54 features de segmodel
  │
  ├─ HORLOGES (12) ─────────────── glicko_diff  melo_diff  ts_diff  ts_sigma_sum
  │                                tsm_diff  tsm_sigma_sum  g2_diff  g2_phi_sum
  │                                pi_diff_a  wmelo_diff
  │                                ts_valve_disagree  ts_g2_disagree
  │
  ├─ FORME & MOMENTUM (9) ──────── form5_diff  form10_diff  h2h_balance
  │                                experience_diff  rest_diff  stability_diff
  │                                n7_diff  n21_diff  streak_diff
  │
  ├─ STATS JOUEURS (7) ─────────── prat_mean_diff  prat_star_diff  prat_std_diff
  │                                padr_diff  pkast_diff  pcov_diff  rshare_diff
  │
  ├─ MAPS & ROUNDS (9) ─────────── exp_mapwr_diff  best_map_edge  pool_depth_diff
  │                                round_share_diff  ct_share_diff  t_share_diff
  │                                h2h_maps_diff  h2h_maps_n  veto_n
  │
  ├─ ÉCONOMIE BO3 (3) ──────────── eco_clutch_diff  eco_adv_diff  eco_eff_diff
  │
  ├─ RANG HLTV DATÉ (2) ────────── hr_rank_diff  hr_trend_diff
  │
  ├─ CONTEXTE (2) ──────────────── lan  stakes
  │
  └─ INTERACTIONS (10) ─────────── ts_diff*ts_sigma_sum  melo_diff*form5_diff
                                   inf  +  inf × {melo_diff, ts_diff, glicko_diff,
                                   hr_rank_diff, round_share_diff, wmelo_diff,
                                   pi_diff_a}

  ABANDONNÉES : H2H pondéré roster (13 385 lignes) · boîtes Past matches ·
                carrières Wayback (966 snapshots, couverture 17 %) ·
                dissensus (5 colonnes) · points hebdo (redondants) ·
                bloc VRS result (3 % des pages)
Pour aller plus loin
Deux questions reviennent invariablement quand on présente ce catalogue.
Pourquoi une régression logistique et pas XGBoost, avec 54 features ?
Parce qu'elle gagne. Le concours a testé les deux à features égales et la logistique régularisée l'emporte à partir du moment où les features sont nombreuses et corrélées. L'histoire complète — et la figure qui la raconte — est dans la partie consacrée aux modèles. Ce qu'il faut retenir ici : le catalogue de features n'a pas été conçu pour un modèle particulier, et les familles gagnantes sont les mêmes dans les deux cas.
La seconde question porte sur les familles mortes : puisqu'elles sont déjà extraites, quel mal y aurait-il à les laisser dans le tableau ?
Pourquoi ne pas simplement tout garder, y compris les familles inutiles ?
Avec une régularisation \(L_2\), ajouter des colonnes inutiles n'est pas gratuit : elles
consomment de la pénalité, diluent les coefficients des colonnes utiles et augmentent le
risque de sur-ajustement sur le jeu de validation. Les tables de squeeze le montrent :
« toutes familles » donne 0,2256 en validation, contre 0,2250 pour la seule famille qui
marche. Ajouter du bruit coûte six dix-millièmes.
Le prochain chapitre descend d'un étage encore : d'où viennent physiquement ces données, quelles pages ont été téléchargées, à quelle cadence, et ce qui a cassé en route.