La carte de prévisibilité
Le résultat le plus intéressant de la campagne n'est pas le leader. C'est ce qu'on a vu en découpant ses 1 146 prédictions en tranches.
Un Brier global de 0.2041 est une moyenne. Sous cette moyenne, le même modèle, le même jour, avec les mêmes features, passe de 0.1591 à 0.2205 selon le type de match. L'écart entre ses deux extrêmes — 0.0614 — est seize fois plus large que tout ce que les trois derniers chantiers de modélisation ont réussi à gagner.
Ce chapitre lit cette carte, explique comment elle a été produite sans tricher, et propose ce qu'elle dit du jeu lui-même.
Comment la carte a été produite
Un point de méthode, parce qu'il conditionne la validité de tout le reste.
Les chiffres par segment sont un découpage a posteriori de la passe unique de holdout. On n'a pas entraîné de modèle par segment pour produire ce tableau, ni relancé quoi que ce soit : on a pris les 1 146 probabilités déjà produites, on les a réparties en groupes selon des critères connus avant le match (lieu, format, incertitude des horloges), et on a recalculé le Brier dans chaque groupe.
   1 146 prédictions du leader (une seule passe holdout)
              │
              ├── par lieu     ──►  LAN (380)          │  en ligne (766)
              ├── par format   ──►  Bo1 (60)           │  Bo3+ (1 086)
              └── par horloge  ──►  froides (244)      │  informées (902)

   Aucun réentraînement. Aucune sélection. Juste un regroupement
   de prédictions déjà écrites, sur des critères pré-match.
Erreur fréquente — confondre découpage et sélection
Découper des prédictions déjà faites est licite. Choisir le découpage
parce qu'il donne un joli résultat, puis le présenter comme une
découverte, ne l'est pas. Les trois axes utilisés ici étaient définis dans
le protocole avant la mesure : ce sont exactement les trois variables
binaires que le modèle utilise déjà comme features (lan, format Bo,
indicateur « informé »).
La preuve que ce n'est pas de la pêche : le résultat obtenu contredit l'hypothèse de départ, comme on va le voir.
La carte
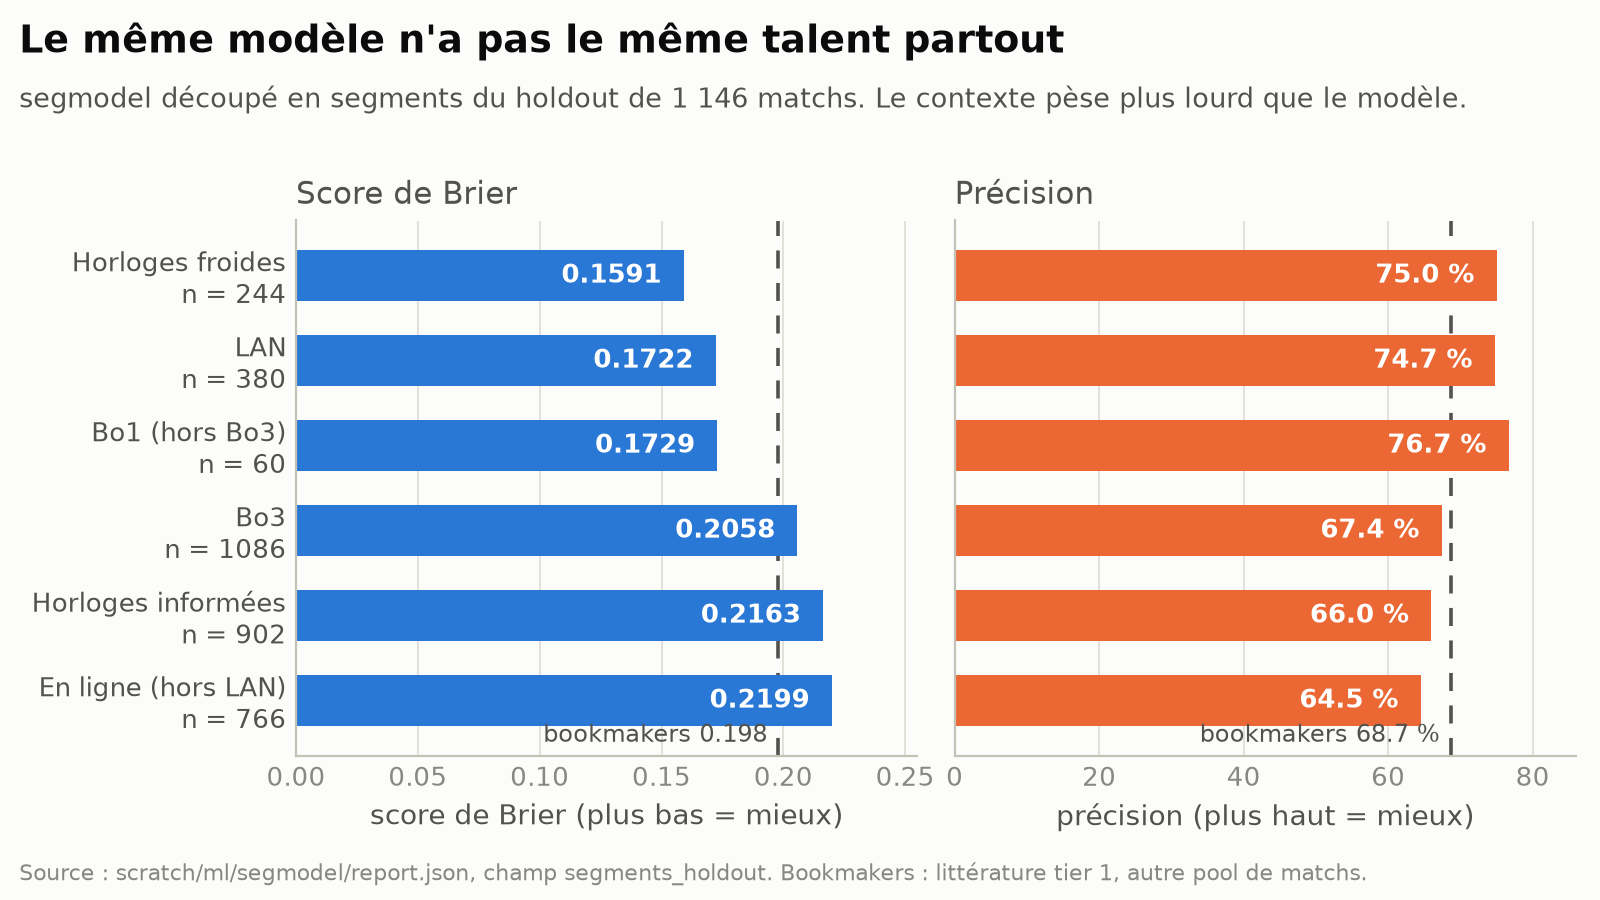
| Segment | n | Brier | Exactitude |
|---|---|---|---|
| Horloges froides (au moins une équipe mal connue) | 244 | 0.1591 | 75,0 % |
| LAN | 380 | 0.1722 | 74,7 % |
| Bo1 | 60 | 0.1729 | 76,7 % |
| Ensemble du holdout | 1 146 | 0.2041 | 67,9 % |
| Bo3 et plus | 1 086 | 0.2058 | 67,4 % |
| Horloges informées (les deux équipes bien connues) | 902 | 0.2163 | 66,0 % |
| En ligne | 766 | 0.2199 | 64,5 % |
| Noyau dur : en ligne ET Bo3+ | 758 | 0.2205 | 64,3 % |
Deux mondes, séparés par une frontière nette. D'un côté, trois segments autour de 0.16–0.17 et 75 % d'exactitude, c'est-à-dire au-dessus du repère bookmaker de 0.198 (avec toutes les réserves de comparaison). De l'autre, un noyau dur à 0.2205 et 64,3 %, où le modèle est nettement moins bon que sa moyenne.
Le complémentaire du noyau dur — les 388 matchs qui sont soit en LAN, soit en Bo1 — donne 0.1720 et 75,0 % d'exactitude. Autrement dit : le holdout se scinde proprement en un tiers de matchs « faciles » et deux tiers de matchs « difficiles », et l'écart entre les deux blocs est de 0.0485 point de Brier.
L'hypothèse de départ était fausse
Avant de mesurer, l'intuition disait : les matchs entre équipes bien connues devraient être les plus prévisibles. C'est logique — plus on a d'historique sur deux équipes, mieux on estime leur force, mieux on prédit.
Le modèle avait même été construit sur cette idée. Le gain de lastmile — le chantier qui a fait passer de 0.2054 à 0.2044 — consiste précisément à donner plus de poids aux horloges quand les deux équipes sont bien connues.
Mesure : les matchs entre équipes bien connues sont à 0.2163, ceux impliquant au moins une équipe mal connue à 0.1591. L'ordre est inversé, et l'écart n'est pas marginal : 0.0572 point de Brier.
Intuition — pourquoi l'incertitude est elle-même une information
Quand le TrueSkill d'une équipe a une grosse incertitude, ça ne veut pas dire « je ne sais pas si elle est forte ». Ça veut dire, la plupart du temps, « cette équipe n'a presque pas joué contre du niveau connu » — et dans un écosystème où les qualifications ouvertes font monter des équipes amateurs contre des professionnelles, ça signifie presque toujours qu'elle est beaucoup plus faible.
L'incertitude ne masque pas le pronostic : elle le renforce. Un match contre une inconnue est un match déséquilibré, et un match déséquilibré est facile à prédire.
Ce genre de retournement est la raison d'être d'un découpage a posteriori. Une hypothèse plausible, tenue pour acquise pendant quatre chantiers, est réfutée en un tableau — sans avoir rien coûté à produire.
Le piège du Bo1
Le segment Bo1 affiche 0.1729 et 76,7 % d'exactitude : le meilleur taux de bonne réponse de toute la carte. La lecture naïve serait : « les Bo1 sont plus faciles à prédire que les Bo3 ».
Elle est fausse, et l'arithmétique le montre.
Le holdout contient 60 matchs en Bo1. Le décompte croisé des segments donne : 766 matchs en ligne au total, dont 758 en Bo3 ou plus. Il y a donc 8 Bo1 en ligne, et par soustraction 52 Bo1 en LAN.
Le segment « Bo1 » est composé à 87 % de matchs de LAN. Il ne mesure donc pas un effet de format : il remesure l'effet LAN, sur un échantillon quatre fois plus petit.
Limite importante — les segments ne sont pas des groupes randomisés
C'est le piège classique du découpage observationnel. Deux segments ne diffèrent jamais par une seule variable : ils diffèrent par tout ce qui est corrélé à cette variable. Ici, « format Bo1 » est corrélé à « joué en LAN », qui est corrélé à « phase de groupes d'un grand tournoi », qui est corrélé à « écart de niveau important ».
Pour isoler l'effet du format, il faudrait comparer Bo1 et Bo3 à lieu et à niveau d'adversité comparables. Avec 8 Bo1 en ligne dans le holdout, c'est impossible. Le segment Bo1 est donc à lire comme une curiosité, pas comme un résultat.
Sur le fond, la théorie prédit d'ailleurs l'inverse : un Bo3 tire trois fois plus de manches qu'un Bo1, donc la variance du résultat est plus faible, donc le favori sort plus souvent vainqueur. C'est ce qu'on observe une fois le lieu tenu constant — le noyau dur (en ligne, Bo3+) et l'ensemble « en ligne » sont quasiment identiques, 0.2205 contre 0.2199, parce que les 8 Bo1 en ligne ne pèsent rien.
L'effet LAN : réel, mais pas pour la raison qu'on croit
Le segment LAN est le seul dont l'effet se retrouve aussi en validation, sur une fenêtre de temps différente : 0.2012 contre 0.2240 pour le hors-LAN sur les 808 matchs de validation, et 0.1722 contre 0.2199 sur le holdout. Le sens est constant, l'amplitude varie.
L'explication séduisante serait : « en LAN, pas de problème de connexion, pas de tricherie, conditions contrôlées, le meilleur gagne ». Elle est probablement partiellement vraie, mais elle n'est pas testable avec nos données, et il existe une explication plus prosaïque.
Un tournoi en LAN est un tournoi sur invitation, avec des phases de groupes. On y trouve donc massivement des affiches entre une équipe du top mondial et une équipe qualifiée régionalement — c'est-à-dire des déséquilibres de niveau. Les matchs en ligne, eux, sont majoritairement des ligues et des qualifications où les équipes s'affrontent entre pairs.
Intuition — la prévisibilité mesure l'écart de niveau, pas la qualité du modèle
Un match entre le n° 3 mondial et le n° 60 est facile à prédire pour n'importe quel modèle raisonnable. Un match entre le n° 8 et le n° 11 est difficile pour tout le monde, bookmakers compris. La carte de prévisibilité est donc, avant tout, une carte de la distribution des écarts de niveau dans chaque type de compétition.
C'est aussi pourquoi il ne faut jamais comparer un Brier d'un pool à un Brier d'un autre pool sans précaution : la difficulté intrinsèque du pool domine la qualité du modèle.
Ce raisonnement est une hypothèse d'interprétation, pas une mesure. La mesure, elle, tient en une phrase : sur nos matchs, le modèle est nettement meilleur en LAN, et il l'est sur deux fenêtres de temps indépendantes.
Le noyau dur : 758 matchs où le modèle plafonne
Le vrai sujet est là. 758 matchs — deux tiers du holdout — joués en ligne, au format Bo3 ou plus. Le leader y fait 0.2205 de Brier, 64,3 % d'exactitude, 0.6306 de log-loss, contre 0.1720 / 75,0 % / 0.5154 sur le reste.
Trois questions se posent, et les trois ont reçu une réponse chiffrée.
Le modèle est-il surconfiant sur ce segment ?
C'est l'explication la plus naturelle : le modèle donnerait 70 % là où la réalité est à 62 %, et il suffirait de tasser ses probabilités vers 50 % pour améliorer le Brier.
L'expérience a été faite. On applique une transformation de rétrécissement aux probabilités du segment dur :
où \(p\) est la probabilité du modèle, \(s \in \{0{,}7\ ;\ 0{,}85\ ;\ 1{,}0\}\) le facteur de rétrécissement, et \(p'\) la probabilité corrigée. Avec \(s = 1\) rien ne change ; avec \(s = 0{,}7\), une prédiction à 80 % devient \(0{,}5 + 0{,}7 \times 0{,}30 = 71\ \%\).
Cette transformation préserve l'ordre des probabilités et le côté de 50 % : l'exactitude est inchangée par construction, seul le Brier juge.
Résultat en validation : \(s = 0{,}85\) est neutre (0.2146 contre 0.2147 de référence), \(s = 0{,}7\) dégrade (0.2154). Sur le segment dur lui-même : 0.2236 et 0.2249 contre 0.2238.
Réponse : non, le modèle n'est pas surconfiant sur le segment dur. Ses probabilités y sont déjà honnêtes ; les tasser ne fait que perdre de l'information.
Le modèle est-il mal réglé sur ce segment ?
Deuxième hypothèse : le modèle riche sur-ajusterait un segment où le signal est faible, et un modèle plus simple, plus fortement régularisé, ferait mieux.
Cent dix combinaisons ont été testées : branches à 3, 5 ou 8 features fortes (plus un contrôle à 54 features), régularisation forte sur un ordre de grandeur, mélange avec le leader à trois poids, rétrécissement à trois valeurs.
En validation, l'hypothèse tenait : la branche à trois features — TrueSkill, Elo à marge, rang mondial — faisait 0.2221 sur le segment dur contre 0.2238 pour la référence, et le contrôle riche faisait moins bien qu'elle. Le simple battait le riche.
En holdout : segment dur, leader 0.2205, candidat 0.2207. Rien.
Réponse : non. Le gain de validation était du sur-ajustement à la fenêtre de validation (531 matchs durs), pas un effet biais-variance. Second constat au passage : la régularisation est à plateau, ±0.0001 sur un ordre de grandeur du paramètre. Un modèle qui ne réagit plus à sa régularisation n'est ni sur-ajusté ni sous-ajusté : il est limité par autre chose.
Le modèle est-il calibré sur ce segment ?
Un modèle peut être mauvais de deux façons : mal discriminer (il ne sait pas qui va gagner) ou mal calibrer (il sait, mais il annonce mal ses probabilités). Le Brier mélange les deux ; la table de calibration les sépare.
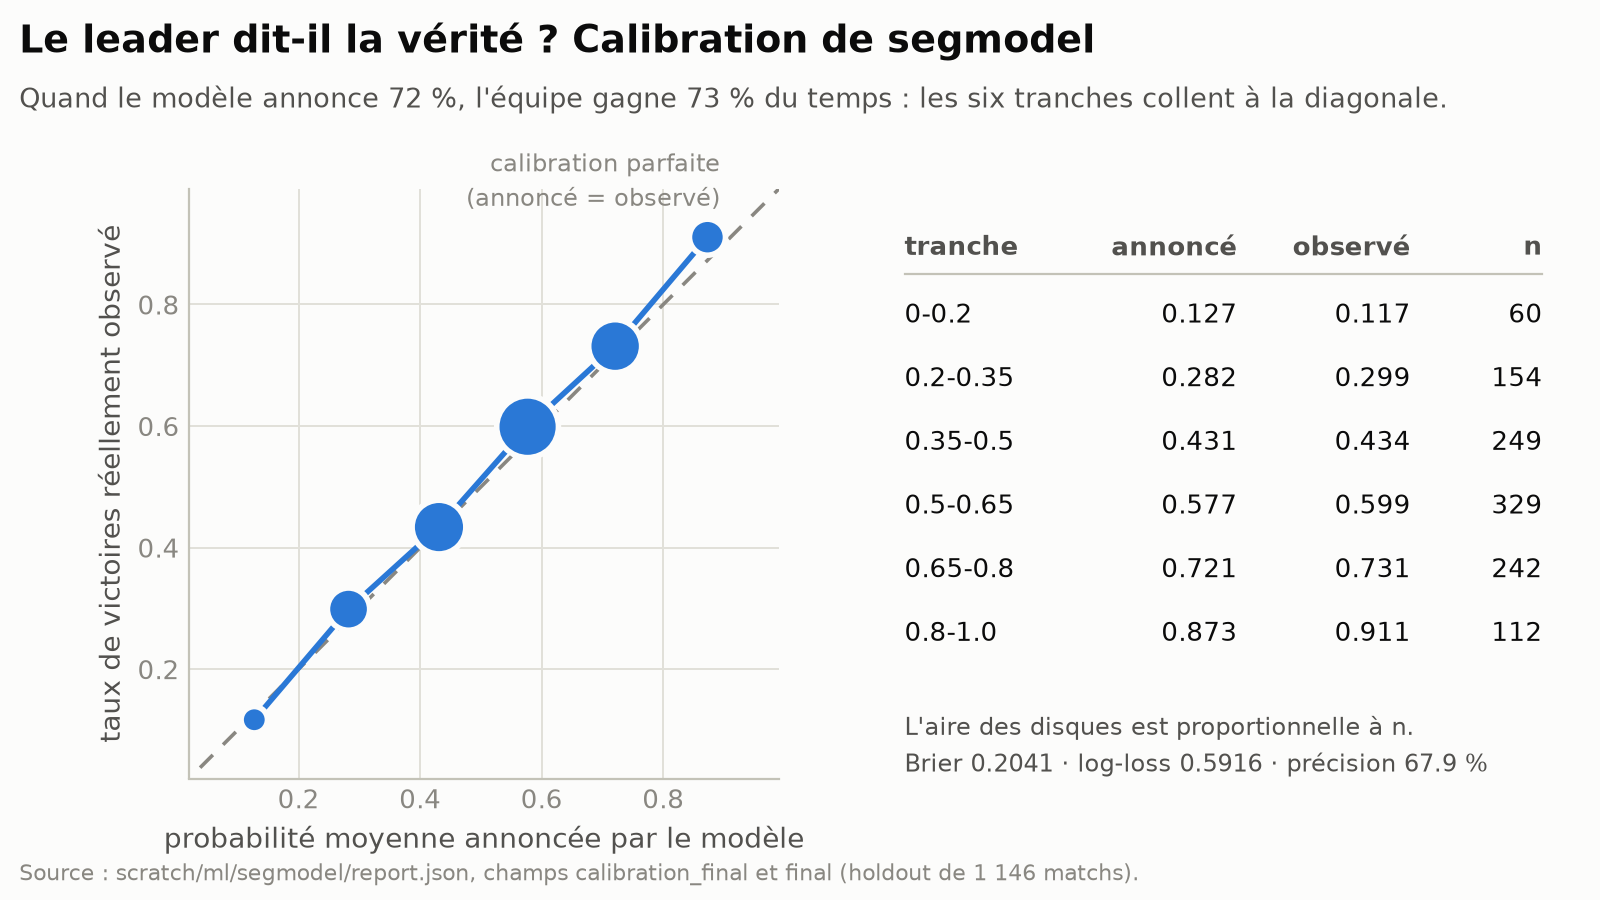
Voici la table du leader sur l'ensemble du holdout :
| Tranche annoncée | n | Probabilité moyenne annoncée | Taux de victoire observé | Écart |
|---|---|---|---|---|
| 0 – 20 % | 60 | 12,7 % | 11,7 % | −1,0 pt |
| 20 – 35 % | 154 | 28,2 % | 29,9 % | +1,7 pt |
| 35 – 50 % | 249 | 43,1 % | 43,4 % | +0,3 pt |
| 50 – 65 % | 329 | 57,7 % | 59,9 % | +2,2 pt |
| 65 – 80 % | 242 | 72,1 % | 73,1 % | +1,1 pt |
| 80 – 100 % | 112 | 87,3 % | 91,1 % | +3,8 pt |
Cinq tranches sur six sont à moins de 2,2 points. La sixième (80–100 %) montre un modèle légèrement sous-confiant : quand il annonce 87 %, la réalité est à 91 %. Sur 112 matchs, un écart de 3,8 points reste dans le bruit d'échantillonnage.
À retenir — le modèle dit la vérité, il en sait juste moins
Sur le noyau dur, le modèle annonce environ 62 % pour le favori et le favori gagne environ 64 % du temps. Ce n'est pas un modèle cassé : c'est un modèle honnête sur son ignorance.
C'est exactement ce qu'on veut d'un modèle destiné à alimenter un Monte Carlo. Un modèle surconfiant produirait des probabilités d'invitation au Major trop tranchées ; celui-ci propage correctement l'incertitude qu'il a.
Le verdict : un plateau d'information
Les trois réponses convergent. Le modèle n'est ni surconfiant, ni mal réglé, ni mal calibré sur le segment dur. La seule explication qui reste est qu'il manque de l'information sur ces matchs-là.
C'est cohérent avec le reste de la campagne. Sur ce segment, les deux équipes sont bien connues, leurs historiques sont longs, leurs ratings sont stables et proches. Tout ce que les résultats passés peuvent dire a déjà été extrait. Ce qui départage deux équipes de niveau comparable un soir donné — la forme du jour, la préparation spécifique, l'état d'esprit, le choix des cartes en salle — n'est dans aucune de nos sources.
Limite importante — la porte est fermée avec des chiffres
Il serait facile de croire que le segment dur mérite « un modèle spécialisé ». Cette idée a été testée sur 110 configurations, elle a produit un gain net de +0.0002 en holdout — c'est-à-dire une dégradation.
Chiffrer un échec le rend définitif. Sans ces 110 mesures, l'idée reviendrait tous les trois mois.
Ce que la carte dit du jeu lui-même
Trois lectures, en montant en généralité. Les deux dernières sont des interprétations, signalées comme telles.
Fait mesuré : la prévisibilité de CS2 n'est pas uniforme, et le facteur dominant est l'écart de niveau. Les trois segments faciles ont un point commun — ils concentrent les affiches déséquilibrées : LAN (phases de groupes de tournois sur invitation), horloges froides (une équipe qui vient d'émerger contre une équipe établie). Les deux segments difficiles concentrent les affiches entre pairs.
Interprétation : il existe un plancher d'aléa dans le jeu. À niveau comparable, sur un Bo3 en ligne, le meilleur modèle qu'on ait su construire plafonne à 64,3 % d'exactitude et 0.2205 de Brier — avec des probabilités calibrées, donc sans marge de correction. Cela suggère qu'environ un tiers de ces matchs se décident sur des facteurs qu'aucun historique de résultats ne contient. La comparaison avec le repère bookmaker donne une idée de la part récupérable : même les acteurs qui disposent des compositions confirmées, des cotes du marché et des rumeurs de vestiaire tournent autour de 68,7 % sur du tier 1.
Interprétation : le format long protège le favori, mais l'appariement décide de tout. L'effet du format, isolé autant que nos données le permettent, est faible devant l'effet de composition du plateau. Un tournoi qui apparie des équipes de niveaux très différents produit des résultats prévisibles quel que soit le format ; un tournoi qui apparie des pairs produit du chaos même en Bo5. Pour qui voudrait construire un modèle sur un autre pool, c'est la première question à poser : à quoi ressemble la distribution des écarts de niveau dans les matchs que je vais prédire ?
Ce que la carte change en pratique
Deux conséquences opérationnelles, pour le projet et au-delà.
Pour le simulateur de Major. Les matchs qui décident des invitations sont massivement des matchs de tier 1 en ligne entre équipes établies — le noyau dur. Le Brier qui compte pour ce cas d'usage n'est donc pas 0.2041 mais 0.2205. Publier le chiffre global comme mesure de la qualité du simulateur serait flatteur et trompeur.
Pour toute campagne de modélisation. Découper les prédictions du holdout coûte quelques lignes de code et se fait après coup, sans consommer de budget de mesure. Le rapport bénéfice/coût est le meilleur de toute la campagne : deux hypothèses réfutées, un plafond identifié, une explication du gain restant — pour zéro calcul supplémentaire.
À retenir — mesurez toujours par segment, même sans hypothèse
Une métrique globale cache systématiquement une structure. Le découpage a posteriori d'une passe déjà consommée est gratuit, ne consomme aucun budget statistique tant qu'on ne s'en sert pas pour choisir un modèle, et donne presque toujours quelque chose. Ici, il a renversé l'hypothèse centrale du chantier précédent.
Chapitre précédent : Le palmarès · Chapitre suivant : Leçons généralisables · Glossaire