Features et données
Cette partie raconte la moitié du projet dont personne ne parle jamais dans les articles de machine learning : d'où viennent les colonnes.
Pas les algorithmes — ils ont leur partie à eux. Ici, on regarde ce qu'on a mis dans le tableau, comment chaque case a été fabriquée, à partir de quelle page HTML, avec quelle garantie qu'elle ne contient pas d'information du futur, et combien de Brier elle a rapporté ou coûté.
Le fil rouge : les gains sont venus de la donnée, jamais du modèle
C'est le constat qui structure toute la campagne, et il a été vérifié deux fois, sur deux chantiers indépendants.
Premier chantier : la reproduction du classement VRS de Valve. Le point de départ était
catastrophique — 0 slot Major sur 32 correctement attribué, 11,76 points d'écart moyen sur
le facteur de valeur régionale. Le point d'arrivée : 32/32 slots chaque jour du mois,
0,39 point d'écart moyen. Entre les deux, dix corrections. Et le rapport de campagne le
formule sans détour : « aucune de ces corrections n'a touché aux formules du moteur. Le
port de model/*.js était juste ; tout était dans ce qu'on lui donnait à manger —
anachronismes, caches périmés, information manquante. »
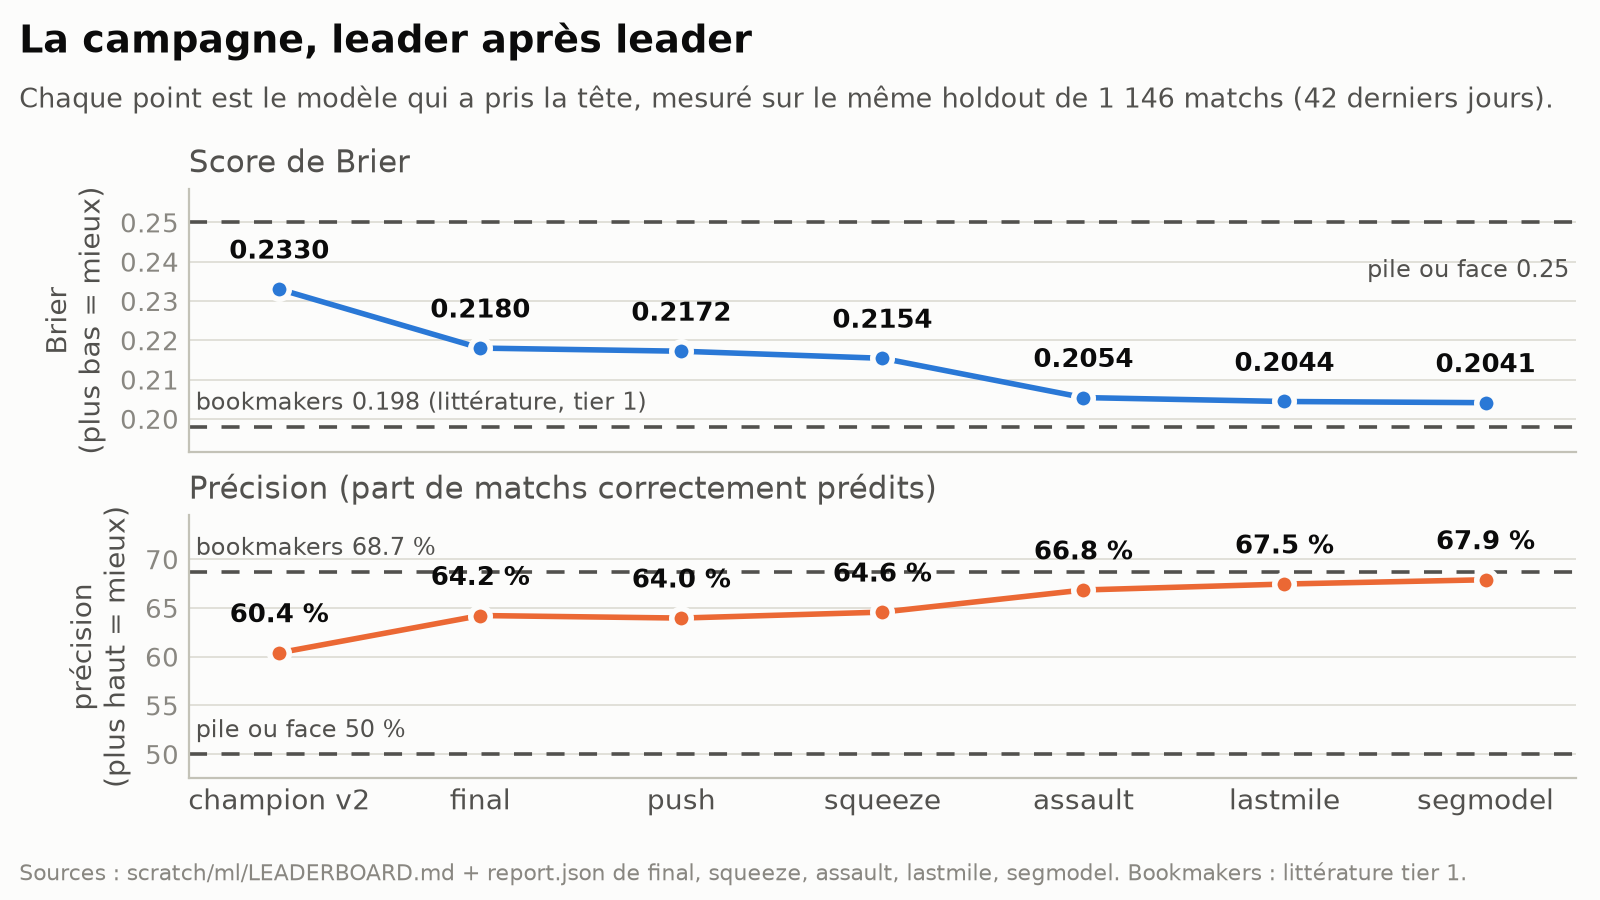
Second chantier : le concours de prédiction. Onze approches, du champion de départ
(XGBoost sur 10 features, Brier 0,2330) au leader final (segmodel, Brier 0,2041). Le
tableau ci-dessous découpe le trajet.
| étape | ce qui change | Brier |
|---|---|---|
| champion v2 (départ) | XGBoost, 10 features | 0,2330 |
logreg |
même données, régression logistique 22 features | 0,2315 |
stack |
même données, moyenne des logits XGB + logreg | 0,2306 |
stats |
+ stats joueurs minées du cache (KAST, rating 3.0, ADR) | 0,2289 |
maps |
+ veto, mi-temps CT/T, H2H minés du cache | 0,2293 |
final |
fusion des trois familles de données | 0,2180 |
push |
+ pi-ratings, TrueSkill par map, momentum | 0,2172 |
squeeze |
+ rang mondial HLTV daté (source neuve) | 0,2154 |
assault |
+ fenêtre 12 mois, warm-up bo3.gg, économie par round | 0,2054 |
lastmile |
interactions « horloges informées » | 0,2044 |
segmodel |
blend 75/25 segment informé / global | 0,2041 |
Les lignes en gras sont des lignes de données. Les autres sont des lignes de modélisation.
Regardez les écarts. Passer d'XGBoost à une logistique, puis empiler les deux : −0,0024 de Brier au total, et l'empilement a fini 9ᵉ du classement. Ajouter les familles minées du cache : −0,0150. Ajouter la fenêtre de 12 mois et les sources externes : −0,0100 en une seule étape. Les deux dernières lignes, purement modélisation, valent ensemble −0,0013.
Faisons le compte sur la lignée qui mène au leader. Les trois étapes purement
modélisation — le passage d'XGBoost à la régression logistique, les interactions de
lastmile, le blend de segmodel — valent ensemble environ 0,0028 de Brier. L'écart total
entre le champion de départ et le leader final est de 0,0289.
À retenir
Sur cette campagne, environ un dixième du gain total vient du modèle, et neuf dixièmes viennent de la donnée : nouvelles colonnes, fenêtre plus longue, états réchauffés. Ce n'est pas une loi universelle — c'est ce qui a été mesuré ici, sur ce pool de matchs, avec ce protocole.
Et le gain unitaire le plus fort de toute la campagne n'est même pas une nouvelle colonne. C'est le passage d'états « froids » (les horloges démarrent à 1500 au début de la fenêtre d'entraînement) à des états « réchauffés » (elles ont vu six mois de matchs avant le début de la fenêtre) : −0,0072 de Brier à lui seul, 0,2153 → 0,2081. Aucun paramètre du modèle n'a bougé. On lui a simplement donné des ratings qui avaient eu le temps de converger.
Ce que vous allez apprendre
Quatre chapitres, dans un ordre qui va du principe à l'application.
1. L'intégrité temporelle
Le principe cardinal, celui sans lequel tous les chiffres de ce cours seraient des mensonges : une feature d'un match n'utilise que ce qui était connu avant ce match.
On y démonte le balayage chronologique — l'objet _State du code de production, pas à pas,
horloge par horloge — et on y range les pièges réels rencontrés : les statistiques d'un
match utilisables seulement après lui, les snapshots Wayback qu'il faut lire avec leur date,
les pages d'événement figées par le cache pendant que le tournoi courait. C'est aussi le
chapitre où le mot « anachronisme » prend son sens exact.
2. Les familles de features
Le catalogue raisonné des 54 colonnes du leader, famille par famille : horloges, forme et momentum, statistiques individuelles, maps et rounds, économie bo3, rang mondial daté, contexte de l'événement.
Pour chacune : la construction exacte (avec sa formule), la source de données, l'importance mesurée — et, tout aussi important, la liste de ce qui n'a rien apporté. Le H2H pondéré par le recouvrement de roster, les boîtes « Past matches », les carrières Wayback, le dissensus des horloges : quatre chantiers entiers pour zéro millième de Brier. Ces échecs sont documentés avec les mêmes chiffres que les réussites.
3. L'ingénierie d'acquisition
D'où viennent physiquement les données. Le cache HLTV et ses 13 160 pages, le parsing par
expressions régulières ancrées, la politesse de 2,5 secondes entre deux requêtes. Les 403
de Cloudflare sur /stats et les contournements — ceux qui ont échoué (six impersonations,
sessions réchauffées) puis ceux qui ont marché (la Wayback Machine, les pages déjà en
cache). L'API ouverte de bo3.gg, ses 209 482 rounds, son appariement par noms à 85 %, et son
piège d'API silencieux.
Et les leçons d'infrastructure payées au prix fort : un cache sans expiration sur du contenu vivant, une pagination par offset qui glisse et fait disparaître deux jours entiers de matchs, des archives re-rendues au moment où on les consulte.
4. L'économie par round
Un zoom sur la famille la plus exotique du catalogue. Ce qu'un round de CS2 contient réellement — valeur d'équipement, bonus de défaite, éco, anti-éco, full-buy, round pistolet, premier kill, trade, clutch — et comment on transforme 209 482 de ces objets en six colonnes glissantes par équipe.
Puis le verdict, honnête : environ un à deux millièmes de Brier. Et l'argument qui reste malgré tout : le niveau round offre 2,4 fois plus d'observations que le niveau match au niveau des manches, et près de cinquante fois plus au niveau des rounds. La campagne n'a jamais construit ce modèle-là — c'est une piste, pas un résultat.
Le protocole de mesure, une fois pour toutes
Tous les chiffres cités dans les quatre chapitres suivent le même protocole. Le poser ici évite de le répéter à chaque page.
Trois jeux disjoints, découpés dans le temps. Le jeu de données est trié par date, puis coupé en trois : une partie d'ajustement, une partie de validation de 808 matchs, et un holdout de 1 146 matchs correspondant aux 42 derniers jours. La coupure est temporelle et non aléatoire — un tirage au sort mélangerait passé et futur et rendrait toute mesure optimiste.
Le holdout n'est touché qu'une fois. Les rapports d'approche enregistrent explicitement
un champ holdout_passes: 1. Tous les choix — quelles features garder, quelle
régularisation, quelle demi-vie, quelle fenêtre d'entraînement — sont faits sur les 808
matchs de validation. Le holdout ne sert qu'à publier le chiffre final.
Le même holdout d'une approche à l'autre. C'est ce qui rend les comparaisons possibles.
L'approche assault est allée jusqu'à reconstituer exactement les 1 146 matchs de
l'approche précédente : six matchs disparus des listings ont été réinjectés depuis un pickle
antérieur, six matchs nouveaux apparus après la coupure ont été exclus. Contrôle de la
reproduction : le leader précédent rejoué à froid donne 0,2153 contre 0,2154 publié — un
dix-millième d'écart, imputable à la re-extraction du cache.
Trois métriques, toujours les mêmes.
- le score de Brier, moyenne des carrés d'erreur de probabilité : \(\frac{1}{n}\sum (p_i - y_i)^2\). Plus bas est meilleur. C'est la métrique de référence du projet parce qu'elle récompense la calibration et pas seulement le bon côté du pari ;
- la log-loss, plus sévère avec les prédictions confiantes et fausses ;
- l'exactitude, la part de matchs dont le vainqueur est correctement désigné. La plus intuitive, et la moins informative des trois.
Les repères. Trois valeurs servent d'échelle de lecture dans tout le cours.
| repère | Brier | exactitude | nature |
|---|---|---|---|
| Glicko de Valve | 0,2422 | 56,0 % | baseline, mesurée chez nous |
| champion de départ | 0,2330 | 60,4 % | point de départ du concours, mesuré chez nous |
leader segmodel |
0,2041 | 67,9 % | arrivée, mesurée chez nous |
| bookmakers tier 1 | 0,198 | 68,7 % | littérature, autre pool |
La dernière ligne n'est pas comparable aux trois premières et le cours le rappellera à chaque fois qu'elle apparaît.
Ordre de lecture conseillé
Les chapitres 1 et 2 se lisent dans l'ordre : le second suppose acquis le vocabulaire du premier (balayage, état, fuite du futur). Les chapitres 3 et 4 sont indépendants l'un de l'autre et peuvent se lire après.
Si vous n'avez le temps que d'un seul chapitre, prenez le premier. C'est celui dont les erreurs coûtent le plus cher : une fuite du futur ne fait pas planter le programme, elle produit un très bon score et un modèle inutile.
Une convention de lecture
Tous les chiffres de cette partie sont des mesures faites sur notre pool — des matchs HLTV « ranked » mêlant tier 1 et tier 3. Quand on compare au repère des bookmakers (Brier 0,198, 68,7 % d'exactitude), il faut se rappeler que ce repère vient de la littérature et d'un pool tier 1 uniquement, où les écarts de force sont plus faibles et les matchs donc plus durs à prédire. La comparaison qui a du sens est interne : nos approches entre elles, sur les mêmes 1 146 matchs de holdout.
Le vocabulaire technique (Brier, log-loss, holdout, calibration, Glicko, TrueSkill, veto, KAST, ADR) est défini dans le glossaire ; les chapitres l'utilisent en confiance.
Retour au sommaire du cours.