Glicko-2 et TrueSkill : faire vivre l'incertitude
Le chapitre 2 s'est terminé sur un constat : Valve possède une machinerie bayésienne complète dans son code et la neutralise avec une constante. Ce chapitre la rallume, puis va deux crans plus loin.
Deux horloges y sont construites et mesurées :
- Glicko-2, qui ajoute un troisième nombre par équipe — la volatilité — et laisse l'incertitude respirer au fil du temps ;
- TrueSkill, qui change carrément d'objet suivi : ce ne sont plus les équipes qui portent un rating, ce sont les joueurs.
Le second gagne. Et il devient la meilleure feature de tout le concours de modèles.
Glicko-2 : l'incertitude sur l'incertitude
Glicko donnait deux nombres, \(r\) et \(RD\). Glicko-2 en donne trois.
| symbole | nom | ce qu'il dit |
|---|---|---|
| \(\mu\) | rating | où se trouve la force estimée |
| \(\phi\) | déviation | à quel point on est sûr de \(\mu\) |
| \(\sigma\) | volatilité | à quelle vitesse \(\mu\) a l'habitude de bouger |
La volatilité est le concept neuf. C'est l'incertitude sur l'incertitude : une équipe régulière, qui gagne et perd conformément aux attentes, a une \(\sigma\) basse — on peut lui faire confiance sur la durée. Une équipe qui alterne des tournois excellents et des sorties de piste a une \(\sigma\) haute : même quand on croit connaître son niveau, il faut s'attendre à ce qu'il dérive.
Intuition
Glicko répondait à « à quel point suis-je sûr de ce rating ? ». Glicko-2 répond en plus à « à quel point ce rating a-t-il l'habitude de me surprendre ? ». Deux équipes peuvent avoir la même barre d'erreur aujourd'hui et des trajectoires futures très différentes.
Le changement d'échelle
Glickman travaille sur une échelle interne où les calculs sont plus propres :
La constante \(173{,}7178\) vaut \(400 / \ln 10\) : c'est l'inverse du \(q\) du chapitre 2. Sur cette échelle, une unité de \(\mu\) vaut 173,7 points Elo, et la logistique s'écrit en base \(e\) sans facteur parasite. Notre implémentation la pose telle quelle :
SCALE = 173.7178
PHI_MAX = 350 / SCALE
Le plafond \(\phi_{\max}\) correspond à \(RD = 350\) : l'incertitude d'une équipe dont on ne sait strictement rien.
Les quatre étapes d'une mise à jour
Étape 1 — gonflement avant le match. Le temps qui passe use la connaissance :
où \(\Delta t\) est le temps écoulé depuis le dernier match, \(P\) la durée d'une « période de classement » (7 jours chez nous), et \(\sigma\) la volatilité courante. Une équipe inactive depuis quatre semaines voit son \(\phi\) gonfler de quatre périodes de variance.
Étape 2 — la variance de l'estimation apportée par ce match :
C'est l'inverse de l'information de Fisher du chapitre 2, sur l'échelle interne. Un match très déséquilibré (\(E\) proche de 0 ou 1) donne un \(v\) énorme : il n'apprend presque rien.
Étape 3 — l'écart observé, et la nouvelle volatilité :
Puis \(\sigma'\) est obtenue en résolvant numériquement \(f(x) = 0\) pour \(x = \ln(\sigma'^2)\), où :
Le premier terme dit « si la surprise \(\Delta\) est bien plus grande que ce que \(\phi\) et \(v\) prévoyaient, c'est que la volatilité était sous-estimée : monte-la ». Le second terme est un rappel élastique : il pénalise tout écart à la volatilité précédente, avec une raideur réglée par \(\tau\). Il n'y a pas de solution analytique, d'où l'algorithme d'Illinois (une régula falsi accélérée) dans notre code.
Étape 4 — mise à jour finale :
Reconnaissez la structure : \(\mu' = \mu + (\text{variance a posteriori}) \times (\text{surprise})\). C'est le même squelette qu'Elo et que Glicko. Ce qui change, c'est que le facteur devant la surprise est maintenant calculé, individuel, et évolutif dans le temps.
À retenir
Elo : \(K\) constant, imposé. Glicko : \(K\) calculé à partir de \(RD\). Glicko-2 : \(K\) calculé à partir de \(RD\), lui-même piloté par une volatilité qui s'apprend. Trois générations, une seule idée qu'on rend de plus en plus autonome.
Nos réglages, et ce qui n'a servi à rien
L'implémentation vit dans scratch/ml/bayes/run.py. Deux idées ont été ajoutées à
la formule standard, et aucune des deux n'a payé :
def _pre(self, team, when, players):
    """Gonflement de phi AVANT le match : inactivité + changement de line-up."""
Le gonflement par le churn de roster. L'idée était séduisante : quand une équipe change trois joueurs sur cinq, son rating devrait redevenir incertain. On mesure la proportion de joueurs remplacés depuis le dernier match et on gonfle \(\phi\) en proportion. Résultat en validation : 0.2336 avec, 0.2334 sans. Rien.
Le poids d'event. Traiter un match de tournoi majeur comme plusieurs
observations. Résultat : strictement identique, la ligne w=1 donne le même Brier
que w=0 à la quatrième décimale.
Le \(\tau\), lui, ne compte presque pas non plus :
| configuration | Brier (validation) |
|---|---|
| \(\tau = 0{,}3\), période 7 j | 0.2334 |
| \(\tau = 0{,}6\), période 7 j | 0.2334 |
| \(\tau = 1{,}2\), période 7 j | 0.2334 |
| \(\tau = 0{,}3\), période 30 j | 0.2336 |
| \(\tau = 0{,}3\), gonflement roster \(RD=75\) | 0.2336 |
Un paramètre auquel le résultat est insensible sur deux ordres de grandeur n'est pas un paramètre : c'est une décoration. On garde \(\tau = 0{,}3\) par convention et on passe à autre chose.
La mesure
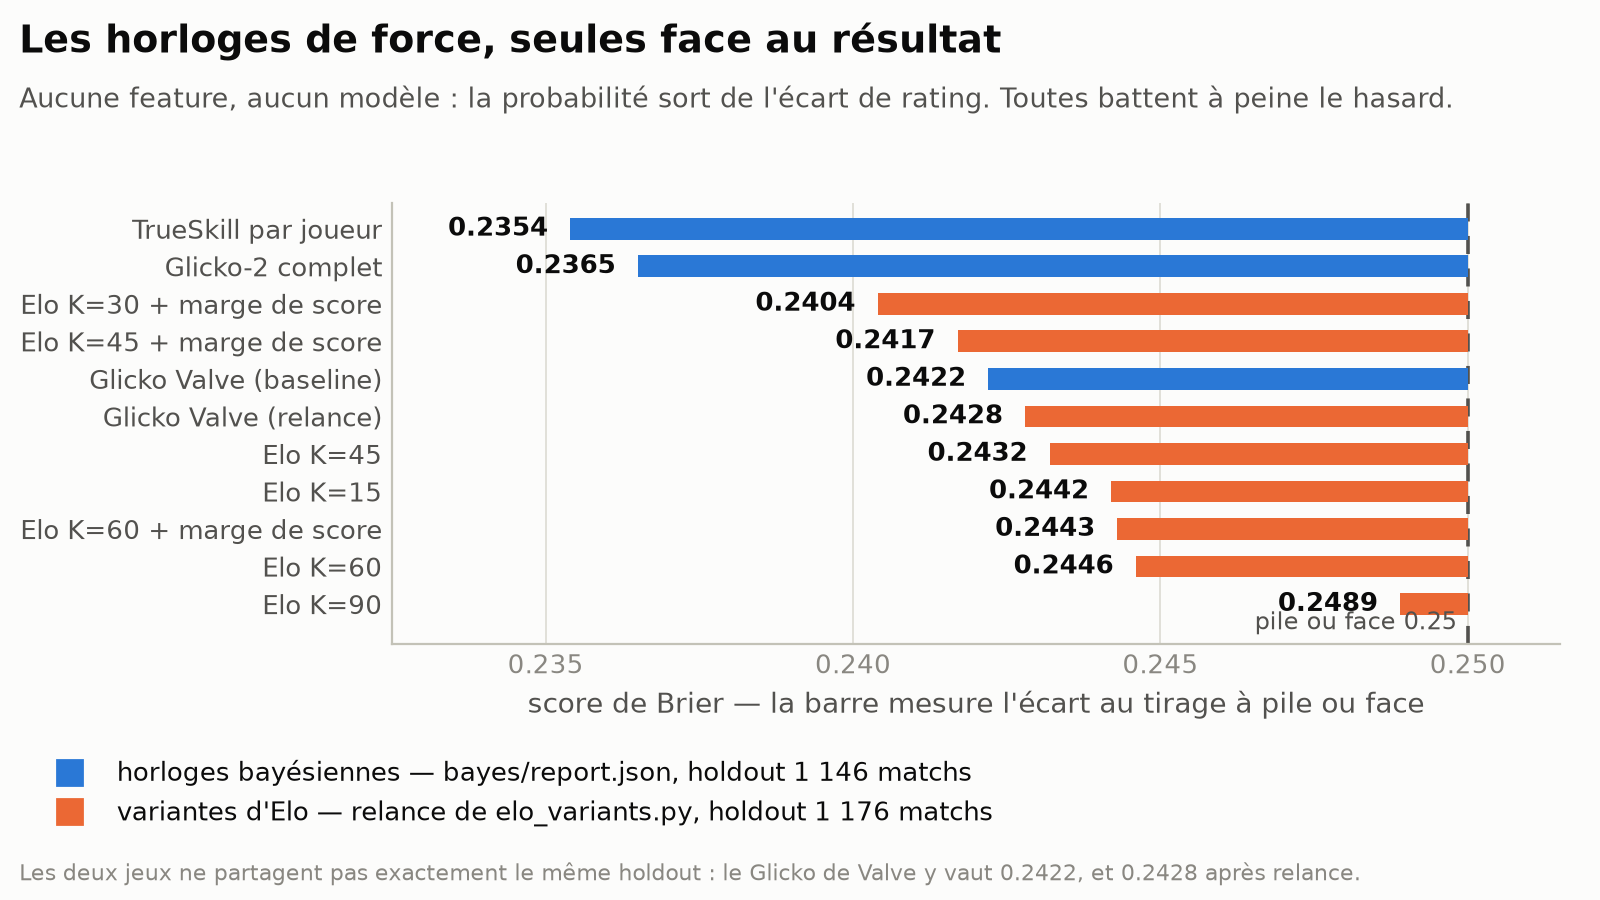
En prédicteur pur, sur le holdout de 1 146 matchs :
| horloge | accuracy | Brier | log-loss |
|---|---|---|---|
| Glicko de Valve (\(RD\) figé) | 56,0 % | 0.2422 | 0.6772 |
| Glicko-2 (\(\tau=0{,}3\), période 7 j) | 60,4 % | 0.2365 | 0.6665 |
Ressusciter l'incertitude vaut donc 0,0057 de Brier et 4,4 points d'accuracy,
mesuré chez nous. C'est le prix chiffré de la ligne FIXED_RD = 75.
TrueSkill : suivre les joueurs, pas les équipes
TrueSkill vient de Microsoft Research (Herbrich, Minka et Graepel, 2006). Il a été conçu pour le matchmaking de Xbox Live, où le problème est différent du nôtre : des équipes formées à la volée, de tailles variables, avec des joueurs qui n'ont jamais coéquipé. La réponse de Microsoft : ne jamais noter une équipe, seulement des joueurs.
C'est un changement d'objet, pas un raffinement de formule. Et pour CS2, c'est peut-être le bon.
Le modèle génératif
TrueSkill pose explicitement comment un match est fabriqué :
- Chaque joueur \(i\) a un talent latent \(s_i \sim \mathcal{N}(\mu_i, \sigma_i^2)\).
- Le jour du match, il produit une performance bruitée \(p_i \sim \mathcal{N}(s_i, \beta^2)\) — un joueur ne joue jamais exactement à son niveau.
- La performance d'une équipe est la somme des performances de son line-up : \(P_A = \sum_{i \in A} p_i\).
- L'équipe dont la performance est la plus grande gagne.
Les symboles :
- \(\mu_i\) : le talent estimé du joueur \(i\). Prior neutre : \(25\) ;
- \(\sigma_i\) : l'incertitude sur ce talent. Prior : \(25/3 \approx 8{,}33\) ;
- \(\beta\) : l'écart-type du bruit de performance — « à quel point un joueur peut jouer au-dessus ou en dessous de lui-même un soir donné » ;
- \(\tau\) : un ajout de variance à chaque match, l'équivalent du gonflement par inactivité de Glicko-2. Chez nous \(\tau = 25/300 \approx 0{,}083\).
Intuition
\(\beta\) est le paramètre le plus important, et le plus mal compris. Il ne dit pas « à quel point les joueurs sont différents » : il dit à quel point un résultat est aléatoire. Un \(\beta\) grand veut dire « ce jeu a beaucoup de variance, une victoire prouve peu » ; un \(\beta\) petit veut dire « le meilleur gagne presque toujours ». Aux échecs, \(\beta\) serait petit. En CS2, on va voir qu'il faut le prendre grand.
La probabilité de victoire
Comme tout est gaussien jusqu'à l'étape 4, la différence de performances d'équipe est gaussienne, et la probabilité de victoire est une fonction de répartition normale :
Les symboles :
- \(\Phi\) : la fonction de répartition de la loi normale centrée réduite ;
- le numérateur : l'écart de talent total entre les deux line-ups ;
- \(n\) : le nombre total de joueurs, \(10\) en CS2 ;
- \(n\beta^2\) : le bruit de performance cumulé ;
- \(\sum \sigma_k^2\) : l'incertitude cumulée sur les talents.
Le dénominateur est la clé. Il contient deux sources d'ignorance additionnées : le hasard irréductible du jeu (\(n\beta^2\)) et notre ignorance des talents (\(\sum\sigma_k^2\)). Plus le dénominateur est grand, plus la probabilité est tirée vers 0,5. Notre implémentation la calcule directement :
delta_mu = sum(x.mu for x in ta) - sum(x.mu for x in tb)
sum_sigma2 = sum(x.sigma ** 2 for x in ta + tb)
denom = math.sqrt(len(ta + tb) * beta * beta + sum_sigma2)
p = 0.5 * (1 + math.erf(delta_mu / denom / math.sqrt(2)))
Exemple numérique
Avec nos réglages retenus, \(\beta = 6{,}25\) et \(n = 10\) :
Cas 1 — deux équipes neuves. Toutes deux au prior, sauf que \(A\) a cinq joueurs à \(\mu = 30\) et \(B\) cinq joueurs à \(\mu = 25\). Donc \(\Delta\mu = 150 - 125 = 25\), et \(\sigma_k = 25/3\) pour tout le monde :
Cas 2 — les mêmes talents, mais bien établis. Après des dizaines de matchs, les \(\sigma\) sont descendus à 4,0 :
Même écart de talent, 77,6 % contre 85,7 %. Voilà exactement ce que le \(RD\) figé de Valve ne peut pas exprimer. L'horloge sait qu'elle sait, et elle le dit.
Les factor graphs, expliqués avec les mains
C'est la partie qui effraie dans les articles sur TrueSkill, et elle est plus simple que sa réputation.
Un factor graph est un dessin de qui-dépend-de-qui. On y met deux types de nœuds : les variables (des quantités inconnues : les talents, les performances) et les facteurs (des contraintes qui les relient : « la performance est le talent plus un bruit », « la somme de l'équipe A dépasse celle de l'équipe B »).
   talents          performances        somme équipe      comparaison
   (inconnus)       (inconnues)         (inconnue)        (OBSERVÉE)

   s₁ ──[+bruit β]── p₁ ─┐
   s₂ ──[+bruit β]── p₂ ─┤
   s₃ ──[+bruit β]── p₃ ─┼──[somme]── P_A ─┐
   s₄ ──[+bruit β]── p₄ ─┤                 │
   s₅ ──[+bruit β]── p₅ ─┘                 ├──[ P_A > P_B ]── ✓ A a gagné
                                           │
   s₆ ──[+bruit β]── p₆ ─┐                 │
   ...                   ├──[somme]── P_B ─┘
   s₁₀──[+bruit β]── p₁₀─┘
L'inférence consiste à faire circuler des messages le long des arêtes. Un message est simplement « voici ce que je crois de toi, compte tenu de tout ce que je sais de mon côté ». Le processus a deux temps :
Aller. Chaque talent envoie sa croyance vers sa performance, qui l'envoie vers la somme d'équipe, qui l'envoie vers le nœud de comparaison. À ce stade, le graphe « sait » quelle était sa prédiction avant le match.
Retour. Le nœud de comparaison reçoit l'observation — \(A\) a gagné, donc \(P_A > P_B\) — et renvoie l'information en sens inverse. Chaque nœud met à jour sa croyance et retransmet. À la fin, chaque joueur a un \(\mu\) et un \(\sigma\) révisés.
Intuition
Le message de retour transporte une seule idée : « votre somme a dépassé la leur ; répartissez-vous le crédit ». Et la répartition n'est pas égale — elle est proportionnelle à la variance de chacun. Le joueur dont on ne savait rien (\(\sigma\) grand) reçoit le gros du crédit, parce que c'est sur lui que l'observation était la plus informative. Le vétéran bien connu bouge à peine. C'est le comportement bayésien correct, et il tombe tout seul de la propagation.
Une difficulté technique subsiste, et c'est elle qui rend l'algorithme approché : le nœud de comparaison tronque une gaussienne (« sachant que la différence est positive »), et une gaussienne tronquée n'est plus une gaussienne. TrueSkill la remplace donc par la gaussienne de même moyenne et même variance — c'est ce qu'on appelle l'expectation propagation. C'est une approximation, elle est excellente en pratique, et c'est la seule concession du modèle.
En pratique, nous n'avons rien réimplémenté : la bibliothèque trueskill fait le
travail, et notre code se contente de définir l'environnement et de rejouer le
balayage chronologique.
env = trueskill.TrueSkill(mu=25.0, sigma=25 / 3, beta=beta, tau=tau,
                          draw_probability=0.0)
Le draw_probability=0.0 n'est pas un détail : en CS2, il n'y a pas de match nul.
Laisser la valeur par défaut aurait fait croire au modèle qu'une partie des
résultats est indécidable et aurait tiré toutes les probabilités vers le centre.
Pourquoi suivre les joueurs traverse les transferts de roster
Voici la raison de fond pour laquelle TrueSkill est un bon candidat en esport, et elle mérite d'être formulée proprement.
En CS2, l'entité « équipe » est une fiction juridique. L'objet qui produit la
performance, c'est un ensemble de cinq personnes. Quand une équipe classée
mondialement remplace deux joueurs, le moteur de Valve conserve son rating (sa règle
sharesRoster considère que trois joueurs communs suffisent à définir la même
entité). Le nombre continue, l'objet a changé.
TrueSkill n'a pas ce problème par construction :
   Équipe X, janvier          Équipe X, juin
   ┌───────────────┐          ┌───────────────┐
   │ A  B  C  D  E │          │ A  B  C  F  G │
   └───────────────┘          └───────────────┘
     Elo/Glicko : le rating de « X » est inchangé, les 2 nouveaux
                  héritent gratuitement du palmarès des partants.

     TrueSkill  : A, B, C gardent leur μ ; F et G apportent le leur,
                  gagné ailleurs. L'équipe du jour vaut la somme du
                  line-up du jour. Rien n'est hérité.
Limite importante
Ce mécanisme est réel et documenté dans le modèle, mais nous ne l'avons pas isolé expérimentalement. Ce que nous avons mesuré, c'est que TrueSkill bat Glicko-2 et le Glicko de Valve. Que ce soit à cause de la traversée des transferts est une explication plausible, pas une conclusion démontrée. Une expérience propre demanderait de dater les transferts, ce qui suppose de parser l'onglet roster des pages d'équipe HLTV — identifié comme manquant dans le rapport, jamais réalisé.
Le réglage de \(\beta\) : le seul paramètre qui compte
La grille de validation interne est sans ambiguïté :
| \(\beta\) | \(\tau = 0{,}083\) | \(\tau = 0{,}25\) | \(\tau = 0{,}5\) |
|---|---|---|---|
| \(25/8 = 3{,}12\) | 0.2464 | 0.2468 | 0.2480 |
| \(25/6 = 4{,}17\) | 0.2413 | 0.2417 | 0.2429 |
| \(25/4 = 6{,}25\) | 0.2357 | 0.2360 | 0.2370 |
Lecture verticale : passer de \(\beta = 3{,}12\) à \(\beta = 6{,}25\) gagne 0,0107 de Brier. C'est énorme à cette échelle. Lecture horizontale : tripler \(\tau\) coûte 0,0003. C'est du bruit.
La valeur par défaut de la bibliothèque est \(\beta = 25/6\), moitié de \(\sigma_0\). Nous avons dû monter à \(25/4\), et c'est un fait intéressant sur CS2 : le jeu est plus aléatoire que le réglage par défaut ne le suppose. Un \(\beta\) élevé revient à dire « une victoire prouve moins qu'on ne croit », donc à tempérer chaque mise à jour. La grille s'arrête à \(25/4\) ; rien ne dit qu'un \(\beta\) encore plus grand n'aurait pas fait mieux, et c'est un regret honnête du rapport.
La mesure : la meilleure horloge bayésienne
| horloge (prédicteur pur) | accuracy | Brier | log-loss |
|---|---|---|---|
| Glicko de Valve | 56,0 % | 0.2422 | 0.6772 |
| Glicko-2 | 60,4 % | 0.2365 | 0.6665 |
| TrueSkill par joueur | 60,9 % | 0.2354 | 0.6676 |
TrueSkill a le meilleur Brier et la meilleure accuracy. Notez au passage que Glicko-2 a un meilleur log-loss malgré un Brier moins bon : les deux métriques ne pénalisent pas identiquement les erreurs extrêmes (le log-loss est infiniment sévère près de 0 et 1). Quand deux métriques se contredisent d'un cheveu, il n'y a pas de vainqueur clair, et il faut le dire.
Un rappel utile : la meilleure horloge en prédicteur pur du projet reste l'Elo à marge du chapitre 3, à 0.2398 — mesuré, il est vrai, sur un assemblage légèrement différent. Ces trois-là se tiennent dans un mouchoir de poche. La figure horloges comparées les met côte à côte.
Le vrai résultat : ts_diff, feature numéro un du concours
Une horloge en prédicteur pur, c'est une expérience de laboratoire. Ce qui compte, c'est ce qu'elle apporte au modèle.
Le protocole est strict : on reprend le XGBoost champion — mêmes paramètres, mêmes
10 features, même early stopping — et on lui ajoute simplement deux colonnes de
l'horloge : son écart (diff) et la somme des incertitudes des deux camps
(sigma_sum).
| modèle | accuracy | Brier | log-loss |
|---|---|---|---|
| champion (reproduction) | 60,4 % | 0.2330 | 0.6568 |
| + Glicko-2 | 59,3 % | 0.2310 | 0.6524 |
| + TrueSkill | 63,8 % | 0.2256 | 0.6412 |
| + les deux | 62,0 % | 0.2258 | 0.6413 |
Trois observations, dans l'ordre d'importance.
TrueSkill fait gagner 0,0074 de Brier et 3,4 points d'accuracy. C'est le premier
vrai dépassement du champion de la campagne, et l'approche bayes/ prend la tête du
concours à ce moment-là avec 0.2256.
ts_diff devient la feature la plus importante du modèle, avec un gain de
16,9 — devant experience_diff (7,8), form10_diff (7,6) et melo_diff (7,1),
qui était le n°1 du champion précédent. ts_sigma_sum contribue aussi, à 4,9 :
le modèle utilise donc bel et bien l'incertitude de l'horloge, pas seulement son
écart. C'est la validation la plus directe de tout ce chapitre.
Les deux horloges ensemble ne font pas mieux qu'une seule (0.2258 contre 0.2256).
Elles mesurent la même chose par deux chemins ; leur information se recouvre presque
entièrement. Le détail est parlant : avec les deux, g2_diff (16,5) et ts_diff
(15,2) se partagent le gain que ts_diff prenait seul.
Erreur fréquente
Regardez la ligne « + Glicko-2 » : Brier meilleur (0.2310 contre 0.2330) et accuracy pire (59,3 % contre 60,4 %). Le piège du chapitre 1, en sens inverse. Un modèle mieux calibré peut trancher moins bien les matchs serrés, ce qui coûte de l'accuracy sans coûter de qualité. Il faut choisir sa métrique avant de regarder les résultats — nous avions choisi le Brier, donc Glicko-2 est bien une amélioration.
La variante par map : plus d'observations, pas plus d'information
Une idée naturelle, explorée dans la campagne push/ : mettre TrueSkill à jour non
pas une fois par série, mais une fois par map jouée. Comme une série Bo3 en
compte deux ou trois, cela donne 2,1 fois plus de mises à jour — chaque joueur
voit son rating révisé bien plus souvent, et la convergence devrait être plus
rapide.
Le résultat, en validation interne, sous le nom tsm_diff :
| variante | Brier (validation) |
|---|---|
| référence de la passe (40 features) | 0.2266 |
+ tsm (TrueSkill par map) |
0.2265 |
+ tsm, en retirant le TrueSkill par série |
0.2272 |
Un millième de gain quand on l'ajoute, deux millièmes de perte quand on remplace.
Autrement dit : la version par map porte à peu près la même information que la
version par série, et il vaut mieux garder les deux que d'échanger l'une contre
l'autre. Les deux colonnes tsm_diff et tsm_sigma_sum figurent dans les
40 features retenues du modèle push/, mais personne ne prétendra qu'elles ont
changé le cours de la campagne.
Intuition
Doubler le nombre d'observations ne double pas l'information quand les observations sont corrélées. Les deux maps d'un 2-0 sont jouées le même soir, par les mêmes dix personnes, souvent dans le même état de forme. Ce sont deux mesures du même instant, pas deux instants.
Ce qui manque, et qui aurait aidé
Le rapport bayes/report.json se termine par une liste de pages HLTV non collectées,
identifiées comme les prochains gisements. Deux concernent directement ce chapitre.
Les pages joueur. Aujourd'hui, tout nouveau joueur entre dans TrueSkill à
\(\mu = 25\), \(\sigma = 25/3\) — le prior neutre. C'est faux pour à peu près tout le
monde : un joueur qui arrive en tier 1 après trois ans de tier 2 n'est pas un
inconnu. Les pages hltv.org/player/<id> porteraient l'historique et le rating HLTV
individuel, de quoi initialiser des priors informés. C'est exactement le sujet du
chapitre 6, appliqué aux joueurs.
L'onglet roster des pages équipe. Il donne les dates exactes des transferts. Aujourd'hui, notre gonflement de \(\sigma\) ne peut se déclencher qu'au match suivant le changement, donc toujours trop tard. Cela expliquerait peut-être pourquoi le gonflement par churn de roster de Glicko-2 n'a rien donné : appliqué au mauvais moment, il ne peut rien apporter.
À retenir
Glicko-2 rend la volatilité dynamique et regagne 0,0057 de Brier sur la
baseline de Valve. TrueSkill change d'objet suivi — les joueurs, pas les équipes
— et fait mieux encore : 0.2354 en prédicteur pur, et surtout ts_diff
feature n°1 du concours (gain 16,9) qui fait passer le modèle de 0.2330 à
0.2256. Le paramètre décisif est \(\beta\), le bruit de performance, et CS2 en
demande plus que le réglage par défaut. Les deux horloges ensemble n'apportent
rien de plus qu'une seule : leur information se recouvre.
Chapitre suivant : pi-ratings et rang HLTV, où l'on change d'objectif — prédire un écart de manches plutôt qu'une victoire — puis d'univers, en allant chercher une horloge hors de notre propre système.