Les horloges de force
Tout ce cours tourne autour d'une seule question : quel nombre résume la force d'une équipe aujourd'hui ? Ce nombre, on l'appelle ici une horloge de force. C'est le cœur mathématique du projet, et c'est aussi la famille de méthodes qui a produit le plus gros gain mesuré de toute la campagne.
Avant de plonger dans Elo, Glicko, TrueSkill et les pi-ratings, il faut comprendre pourquoi la métaphore de l'horloge est la bonne — et pourquoi elle explique, à elle seule, presque toutes les décisions techniques des six chapitres qui suivent.
Pourquoi « horloge » et pas « classement »
Un classement, dans le langage courant, c'est un palmarès : il récompense ce qui a été accompli. Le classement VRS de Valve fait exactement cela, et c'est légitime — il sert à distribuer des invitations au Major, donc il doit récompenser des résultats acquis.
Une horloge, elle, ne récompense rien. Elle suit. On lui pose une question différente : quelle est la force de cette équipe en ce moment ? Et cette force n'est pas une constante : elle dérive. Un joueur part, un autre arrive, une équipe change de coach, une méta de maps se déplace, une équipe s'épuise sur six tournois d'affilée.
    force réelle (invisible)        ~~~~~~~~
                                   /        \___
                              ____/             \____
                             /                       \~~~~
    ─────────────────────────────────────────────────────────► temps

    l'horloge (ce qu'on calcule)   ·  ·  ·  ·  ·  ·  ·  ·  ·
                                   ↑        ↑        ↑
                                 match    match    match
                        (une observation bruitée à chaque fois)
Le vrai signal — la force réelle — n'est jamais observable. On n'observe que des matchs : des tirages binaires, gagné ou perdu, produits par un processus dont la force n'est qu'un paramètre parmi d'autres. Une horloge de force est donc un filtre : à chaque match, elle corrige son estimation d'un peu, dans la direction de la surprise.
Intuition
Une horloge de force fait le même métier qu'un thermostat : elle ne connaît pas la température vraie, elle ne connaît que l'écart entre ce qu'elle attendait et ce qu'elle a mesuré, et elle corrige d'une fraction de cet écart. Toute la difficulté du chapitre suivant tient dans le réglage de cette fraction : trop petite, l'horloge est sourde aux vrais changements ; trop grande, elle poursuit le bruit.
Cette métaphore a une conséquence pratique immédiate. Une horloge qui « suit un signal qui dérive » a nécessairement trois propriétés que nous allons retrouver dans chaque chapitre :
- Elle a une vitesse d'adaptation. C'est le \(K\) d'Elo, le \(\sigma\) de Glicko-2, le \(\tau\) de TrueSkill, le \(\lambda\) des pi-ratings. Ce paramètre arbitre entre réactivité et stabilité.
- Elle a une incertitude. Une horloge qui n'a vu qu'un match ne vaut pas une horloge qui en a vu cinquante. Certaines méthodes rendent cette incertitude explicite (Glicko, TrueSkill), d'autres la laissent implicite (Elo).
- Elle a un état initial. Et si cet état est faux, l'horloge met des dizaines de matchs à s'en remettre. C'est le sujet du chapitre 6, et c'est le plus gros gain mesuré de la campagne.
Ce que Valve calcule, ce que nous voulions
Le moteur de Valve enchaîne un seeding (quatre facteurs de mérite : gains, adversaires battus, réseau, LAN) puis un ajustement Glicko match par match. C'est un système hybride : un palmarès corrigé par une horloge.
Nous voulions autre chose : le meilleur prédicteur possible du prochain match. La différence n'est pas cosmétique. Un palmarès a le droit d'être conservateur, d'ignorer la marge d'une victoire, de figer son incertitude — il n'a pas à répondre de ses erreurs de prévision. Une horloge de prédiction, si.
Limite importante
Aucun des chiffres de cette partie ne dit que le VRS de Valve est « mal fait ». Ils disent qu'il n'est pas optimisé pour prédire — ce qui n'a jamais été son but. La comparaison n'est équitable que sur un seul terrain : la qualité de prévision sur nos matchs, avec notre protocole.
Comment on mesure une horloge
Avant les chiffres, le protocole. Il est identique dans les six chapitres, et il a trois règles.
Règle 1 — le balayage chronologique strict. Les horloges sont rejouées match après match, dans l'ordre du temps. L'état d'une équipe au moment de prédire un match ne contient que ce qui était connu avant ce match. La mise à jour n'a lieu qu'après. Sans cette discipline, une horloge « prédit » des matchs qu'elle a déjà vus, et toute l'évaluation devient un mensonge.
Règle 2 — le prédicteur pur. Une horloge est d'abord jugée seule : on transforme directement son écart de rating en probabilité (par une logistique ou par une normale, selon la méthode), sans aucun modèle d'apprentissage par-dessus. C'est la mesure la plus honnête de ce que l'horloge sait par elle-même. Dans un second temps seulement, on regarde ce qu'elle apporte au modèle, en l'injectant comme feature.
Règle 3 — le holdout intouchable. Les 42 derniers jours de données, soit 1 146 matchs, ne servent qu'à l'évaluation finale. Tous les réglages d'hyperparamètres se font sur une validation interne — les 42 jours qui précèdent le holdout. Quand une mesure de validation et une mesure de holdout diffèrent, les deux sont rapportées, et c'est la seconde qui compte.
Trois métriques accompagnent chaque mesure, et elles ne disent pas la même chose :
- l'accuracy — la proportion de matchs où le camp annoncé favori l'emporte. Elle ne regarde que le côté de 0,5 ;
- le score de Brier, \(\frac{1}{n}\sum (p_i - y_i)^2\) — l'erreur quadratique moyenne sur la probabilité. C'est la métrique d'arbitrage de tout le projet ;
- le log-loss, \(-\frac{1}{n}\sum \big[y_i \ln p_i + (1-y_i)\ln(1-p_i)\big]\) — encore plus sévère que le Brier sur les convictions extrêmes trompées.
Le chapitre 1 explique pourquoi ce choix du Brier n'est pas une lubie, et pourquoi une accuracy qui monte peut être une mauvaise nouvelle.
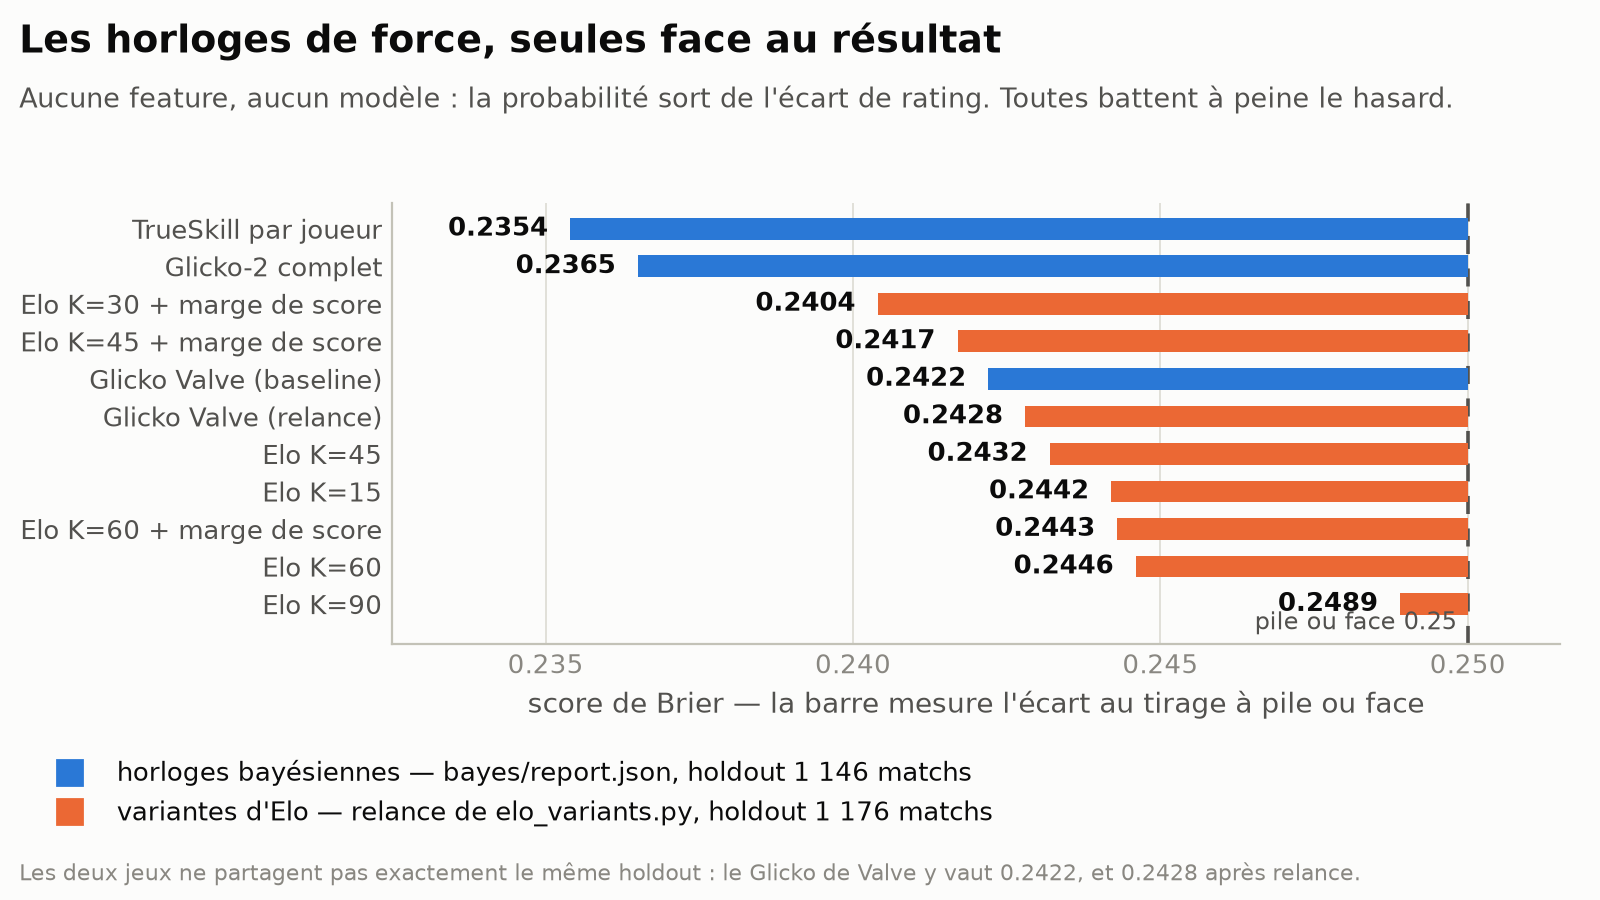
Les cinq horloges, en prédicteur pur
| horloge | Brier | accuracy | source |
|---|---|---|---|
| Elo à marge, \(K=30\) | 0.2398 | — | scratch/elo_variants.py |
| TrueSkill par joueur | 0.2354 | 60.9 % | scratch/ml/bayes/report.json |
| Glicko-2 | 0.2365 | 60.4 % | scratch/ml/bayes/report.json |
| Glicko de Valve (baseline) | 0.2422 | 56.0 % | scratch/ml/bayes/report.json |
| Elo \(K\) libre (meilleur : \(K=45\)) | 0.2432 | 55.8 % | scratch/elo_variants.py |
Ces deux sources ne mesurent pas exactement le même pool — d'où le Valve à 0.2422 d'un côté et 0.2423 de l'autre. L'écart de 0.0001 est du bruit d'assemblage, pas un désaccord ; on le signale plutôt que de le lisser.
Le tableau se lit en deux temps. D'abord : toutes nos horloges battent la baseline de Valve, ce qui n'était pas acquis. Ensuite, et c'est le plus instructif : la meilleure au Brier (Elo à marge) n'est pas la meilleure en accuracy, et la meilleure une fois injectée dans un modèle (TrueSkill) n'est aucune des deux. Trois classements différents pour cinq objets. Le chapitre 1 explique pourquoi.
Une figure récapitule ces cinq mesures : horloges comparées.
Ce que vous allez lire
Les six chapitres suivent une progression volontaire : du plus simple au plus riche, puis un chapitre final qui relativise tout le reste.
La carte des paramètres
Les cinq horloges disent la même chose dans cinq dialectes. Ce tableau est la table de traduction ; gardez-le sous la main en lisant les chapitres.
| horloge | ce qu'elle porte | vitesse d'adaptation | incertitude | notre réglage |
|---|---|---|---|---|
| Elo | \(r\) | \(K\), constante imposée | absente | \(K = 30\) |
| Glicko (Valve) | \(r\), \(RD\) | \(K\) calculé depuis \(RD\) | figée à \(RD = 75\) | — |
| Elo à marge | \(r\) | \(K \times m\), \(m\) = facteur de marge | absente | \(K = 30\), \(m \in [0{,}75\,;1{,}75]\) |
| Glicko-2 | \(\mu\), \(\phi\), \(\sigma\) | pilotée par \(\phi\) et \(\sigma\) | vivante, gonflée par l'inactivité | \(\tau = 0{,}3\), période 7 j |
| TrueSkill | \(\mu_i\), \(\sigma_i\) par joueur | pilotée par \(\sigma_i\) et \(\beta\) | vivante, par joueur | \(\beta = 25/4\), \(\tau = 25/300\) |
| pi-ratings | \(\pi\) en manches | \(\lambda\), amortie en \(\log\) | absente | \(\lambda = 0{,}06\) |
Trois lectures transversales, qui reviendront chapitre après chapitre.
La colonne « vitesse d'adaptation » raconte l'histoire d'une émancipation progressive : d'un \(K\) posé à la main par Arpad Elo, on passe à un \(K\) calculé depuis une incertitude, puis à une incertitude elle-même apprise. Chaque génération retire un paramètre arbitraire.
La colonne « incertitude » explique l'essentiel des écarts de performance mesurés. Les trois horloges qui l'ignorent (Elo, Elo à marge, pi-ratings) restent compétitives, mais uniquement parce qu'elles compensent ailleurs — par la marge, par la granularité.
Et la colonne « ce qu'elle porte » contient la rupture la plus profonde de la partie : TrueSkill ne note pas le même objet que les autres. Ce n'est pas un raffinement de formule, c'est un changement de sujet.
Comment lire les formules de cette partie
Chaque formule est introduite dans cet ordre : d'abord l'intuition en français, ensuite l'écriture mathématique, ensuite la définition de chaque symbole, enfin un exemple numérique avec de vraies valeurs du projet. Si une formule vous résiste, sautez à son exemple numérique : il est toujours juste en dessous.
Les notations sont communes à toute la partie :
- \(r_A\), \(r_B\) : les ratings des deux équipes, sur l'échelle Elo classique où 1500 est le point de départ neutre et 400 points d'écart valent un rapport de cotes de 10 contre 1 ;
- \(E\) : la probabilité que l'horloge attribue à la victoire de \(A\) ;
- \(y\) : le résultat observé, \(1\) si \(A\) gagne, \(0\) sinon ;
- \(K\), \(\lambda\), \(\tau\) : les vitesses d'adaptation, selon la méthode.
À retenir
Une horloge de force n'est pas un palmarès : c'est un filtre qui poursuit un signal invisible et mouvant. Les trois questions à lui poser sont toujours les mêmes — à quelle vitesse corrige-t-elle, connaît-elle sa propre incertitude, et d'où part-elle. Les six chapitres qui suivent répondent à ces trois questions, dans cet ordre.
Commencez par le modèle fondateur.