Les métriques
À la fin d'une campagne d'évaluation, on dispose de 1 146 couples : une probabilité annoncée \(p_i\) et un résultat observé \(y_i\) valant 1 si l'équipe 1 a gagné, 0 sinon. Une métrique est une machine qui compresse ces 2 292 nombres en un seul.
Aucune compression n'est neutre. Chaque métrique choisit ce qu'elle garde et ce qu'elle jette — et c'est en comprenant ce que chacune jette qu'on sait laquelle croire.
Ce chapitre présente les trois métriques utilisées dans tout le projet : l'accuracy, le score de Brier et la log-loss. Il explique ensuite pourquoi le Brier a été désigné juge de paix, et comment se lit une courbe de calibration.
Trois questions différentes
Avant les formules, l'intuition. Les trois métriques ne posent pas la même question au modèle :
| Métrique | Question posée | Ce qu'elle jette |
|---|---|---|
| Accuracy | « As-tu désigné le bon vainqueur ? » | tout ce qui n'est pas le côté de 0,5 |
| Brier | « De combien t'es-tu trompé ? » | rien, mais elle pardonne les erreurs extrêmes |
| Log-loss | « À quel point es-tu surpris par la réalité ? » | rien, et elle ne pardonne rien du tout |
Un modèle peut être excellent selon l'une et médiocre selon l'autre. La campagne en a fourni plusieurs exemples, tous chiffrés plus bas.
L'accuracy : le taux de bons pronostics
Définition
On transforme chaque probabilité en pronostic — on annonce l'équipe 1 si \(p_i \geq 0{,}5\), l'équipe 2 sinon — puis on compte les fois où on a eu raison.
| Symbole | Signification |
|---|---|
| \(n\) | Nombre de matchs évalués (1 146 pour notre holdout) |
| \(p_i\) | Probabilité annoncée que l'équipe 1 gagne le match \(i\) |
| \(y_i\) | Résultat réel : 1 si l'équipe 1 a gagné, 0 sinon |
| \(\mathbf{1}[\cdot]\) | Vaut 1 si la condition est vraie, 0 sinon |
Exemple chiffré
Le leader de la campagne, segmodel, affiche une accuracy de 0,6789 sur le
holdout. Cela signifie très exactement :
368 matchs ont été annoncés du mauvais côté. Une pièce lancée en aurait départagé 573.
Ce que l'accuracy ne voit pas
L'accuracy est une fonction en escalier. Elle ne regarde que de quel côté de 0,5 tombe la probabilité. Passer de 0,51 à 0,99 sur un match effectivement gagné ne lui fait ni chaud ni froid ; passer de 0,49 à 0,51 la fait basculer d'un coup.
Trois observations de la campagne le rendent concret.
Premier cas : même accuracy, Brier différent. L'approche logreg (une
régression logistique à 22 variables) et le champion de départ (un XGBoost)
affichent tous deux 60,4 % d'accuracy sur le holdout. Leurs Brier diffèrent :
0,2315 contre 0,2330. Les deux modèles désignent le même nombre de vainqueurs,
mais l'un le fait avec des probabilités plus honnêtes. L'accuracy est
strictement aveugle à cette différence.
Deuxième cas : une transformation invisible à l'accuracy. L'approche
hardcore a testé, entre autres, un rétrécissement des probabilités vers 0,5 :
Pour \(s < 1\), toutes les probabilités se rapprochent du centre : le modèle devient moins confiant. Mais \(p'\) reste du même côté de 0,5 que \(p\), pour tout \(s > 0\). L'accuracy est donc inchangée par construction, quel que soit \(s\). Seuls le Brier et la log-loss peuvent dire si le rétrécissement améliore ou dégrade le modèle. (En l'occurrence : \(s = 0{,}85\) était neutre à 0,2146 en validation, \(s = 0{,}7\) dégradait à 0,2154 — le leader n'était pas surconfiant sur ce segment.)
Troisième cas : l'accuracy ne se transporte pas dans le Monte Carlo. Le simulateur du chapitre 1 tire des matchs au sort selon \(p\). Un modèle qui annonce 0,51 partout et un modèle qui annonce 0,99 partout ont la même accuracy mais produisent des mondes radicalement différents.
Erreur fréquente
Optimiser l'accuracy revient à optimiser une décision binaire alors que le livrable est un nombre continu. C'est un désalignement d'objectif : le modèle apprend à gagner un concours qu'on ne joue pas.
L'accuracy reste utile — elle est lisible, on la comprend immédiatement, et une chute d'accuracy signale toujours un problème. Elle est un indicateur de contrôle, jamais le critère de décision.
Le score de Brier : l'erreur quadratique moyenne
Intuition
Le Brier ne demande pas « as-tu eu raison ? » mais « de combien es-tu tombé à côté ? ». Il mesure l'écart entre la probabilité annoncée et le résultat, en le mettant au carré pour punir davantage les grosses erreurs que les petites.
Définition
Les symboles sont ceux du tableau précédent. Le score est compris entre 0 (prédiction parfaite et certaine à chaque match) et 1 (certitude systématique et systématiquement fausse). Plus bas est meilleur.
Exemple chiffré, à la main
Trois matchs, trois probabilités annoncées, trois résultats :
| Match | \(p_i\) annoncé | \(y_i\) observé | \((p_i - y_i)^2\) |
|---|---|---|---|
| 1 | 0,87 | 1 (gagné) | \((0{,}87-1)^2 = 0{,}0169\) |
| 2 | 0,58 | 0 (perdu) | \((0{,}58-0)^2 = 0{,}3364\) |
| 3 | 0,43 | 1 (gagné) | \((0{,}43-1)^2 = 0{,}3249\) |
Le match 1 — annoncé confiant et gagné — coûte presque rien. Les matchs 2 et 3 — annoncés du bon côté ou presque, mais démentis — coûtent l'essentiel. Noter que le match 3 était annoncé perdant (0,43 < 0,5) et pèse pourtant moins lourd que le match 2, annoncé gagnant à 0,58 : le Brier ne raisonne pas en termes de pronostic, seulement de distance.
Les repères
Une pièce parfaitement équilibrée annonce \(p = 0{,}5\) à chaque match. Quel que soit le résultat, elle encaisse \((0{,}5 - y)^2 = 0{,}25\). D'où le repère fondamental :
Tout modèle au-dessus de 0,25 est pire que ne rien savoir. C'est le plancher de dignité, pas l'objectif.
Ce que le Brier contient
Le Brier se décompose — c'est la décomposition de Murphy — en trois termes qui disent chacun quelque chose de différent :
| Terme | Ce qu'il mesure |
|---|---|
| Fiabilité (reliability) | Quand tu annonces 70 %, la réalité fait-elle 70 % ? C'est la calibration. |
| Résolution | Sais-tu séparer les matchs faciles des matchs serrés, ou annonces-tu 50 % partout ? |
| Incertitude | Le bruit propre au pool — hors de portée du modèle. |
Cette décomposition est la raison technique du choix qui suit : le Brier est la seule des trois métriques qui contienne explicitement un terme de calibration. Optimiser le Brier, c'est refuser à la fois de raconter n'importe quoi (fiabilité) et de se réfugier dans la prudence (résolution).
La log-loss : la surprise
Intuition
La log-loss mesure à quel point la réalité surprend le modèle. Un événement auquel le modèle donnait 90 % et qui se produit : peu de surprise. Un événement auquel il donnait 2 % et qui se produit quand même : sidération, et la facture est salée.
Définition
Pour chaque match, un seul des deux termes survit : si \(y_i = 1\), il reste \(-\ln p_i\) ; si \(y_i = 0\), il reste \(-\ln(1-p_i)\). On paie toujours le logarithme de la probabilité qu'on avait accordée à ce qui s'est effectivement produit.
Exemples chiffrés
Sur les trois matchs de l'exemple précédent :
Le repère de la pièce vaut :
Et l'erreur confiante, celle qui fait mal :
Un seul match annoncé à 90 % et perdu coûte donc 2,30 — soit plus de trois fois le coût d'une prédiction totalement ignorante. À la limite, un modèle qui annonce \(p = 0\) sur un match qu'il perd encaisse \(-\ln 0 = +\infty\) : un seul match suffit à détruire la moyenne.
Limite importante
C'est un piège d'implémentation classique. Le code du projet borne les probabilités par \(\varepsilon = 10^{-12}\) avant le logarithme, ce qui plafonne la pénalité d'une erreur absolue à environ 27,6 au lieu de l'infini. Sans cette borne, un unique 0 ou 1 mal placé rendrait la log-loss inexploitable et, pire, non comparable entre approches.
Ce que la log-loss apporte, et son défaut
La log-loss est la fonction de coût que la régression logistique minimise directement : c'est sa fonction de vraisemblance. C'est aussi la métrique la plus naturelle pour raisonner en logits et en additions de signaux — elle est donc partout dans le code. Son défaut est le revers exact de sa qualité : elle est dominée par une poignée de matchs. Sur 1 146 lignes, deux ou trois surprises confiantes suffisent à déplacer la moyenne plus que tout le reste du travail de modélisation. C'est une métrique nerveuse.
Pourquoi le Brier est le juge de paix
Le protocole de la campagne fixe le Brier comme critère unique de classement. Les onze approches sont ordonnées par Brier ; battre le champion sur ce seul chiffre donne droit à une ligne au classement. Trois raisons.
Il contient la calibration. Via son terme de fiabilité, il refuse les probabilités décoratives. C'est directement ce dont le Monte Carlo a besoin : une probabilité de 0,63 doit vouloir dire 63 %, sinon les fractions de futurs simulés du chapitre 1 sont fausses.
Il est borné et stable. Chaque match contribue au plus 1. Sur un échantillon de 1 146 lignes, aucune ligne isolée ne peut faire basculer le classement — ce qui n'est pas vrai de la log-loss.
Il reste lisible. 0,25 est la pièce, 0,20 est un bon modèle sur ce pool, 0 est inatteignable. L'échelle est intuitive, à la différence des nats de la log-loss. Les trois métriques sont néanmoins rapportées ensemble dans chaque rapport d'approche : le Brier décide, la log-loss révèle les surconfiances, l'accuracy sert de contrôle de cohérence lisible.
Intuition
En pratique, Brier et log-loss se sont presque toujours accordés au cours de la campagne. Le classement final les voit descendre de concert, de 0,2315 / 0,6538 pour la première approche à 0,2041 / 0,5916 pour la dernière. Le désaccord entre les deux métriques est rare — mais quand il survient, c'est le signe qu'un modèle a payé sa moyenne avec quelques certitudes malheureuses.
La calibration, en pratique
Le principe
Un modèle est calibré si, parmi tous les matchs où il a annoncé environ 70 %, l'équipe désignée gagne effectivement environ 70 % du temps.
C'est une propriété de groupe, pas de match individuel : on ne peut pas vérifier une probabilité sur un seul événement. Il faut regrouper.
La table par tranches
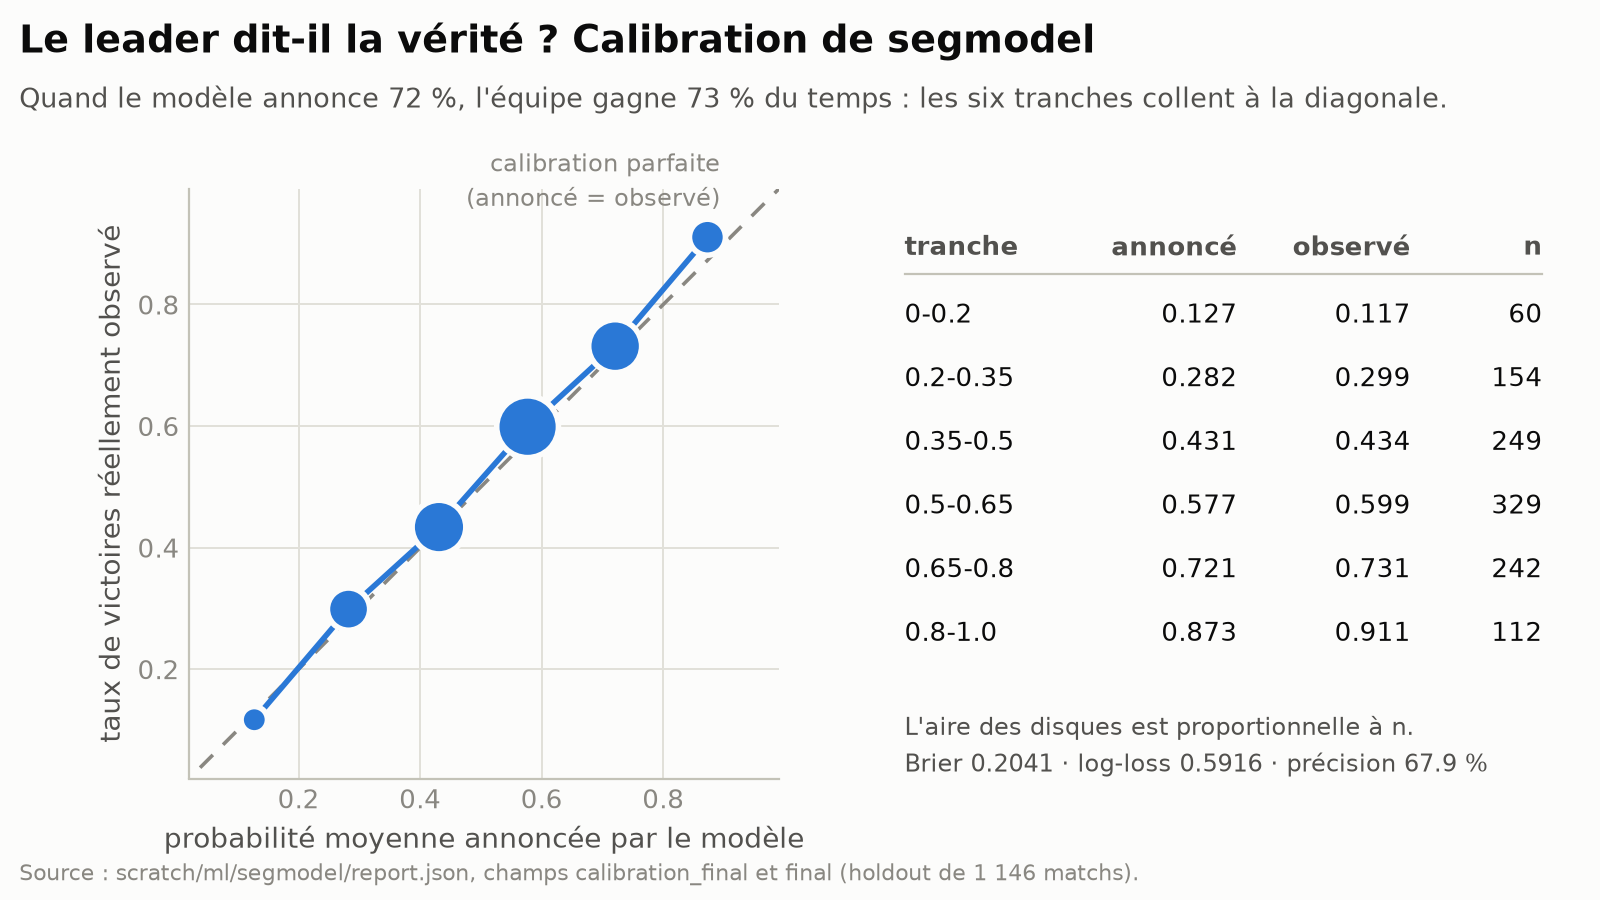
La méthode retenue dans tout le projet : découper l'intervalle \([0, 1]\) en six tranches, et comparer dans chacune la probabilité moyenne annoncée à la fréquence de victoire réellement observée.
Voici la table du leader segmodel, sur les 1 146 matchs du holdout :
| Tranche | \(n\) | Probabilité moyenne annoncée | Fréquence réelle | Écart |
|---|---|---|---|---|
| 0 – 0,20 | 60 | 0,127 | 0,117 | \(-0{,}010\) |
| 0,20 – 0,35 | 154 | 0,282 | 0,299 | \(+0{,}017\) |
| 0,35 – 0,50 | 249 | 0,431 | 0,434 | \(+0{,}003\) |
| 0,50 – 0,65 | 329 | 0,577 | 0,599 | \(+0{,}022\) |
| 0,65 – 0,80 | 242 | 0,721 | 0,731 | \(+0{,}010\) |
| 0,80 – 1,00 | 112 | 0,873 | 0,911 | \(+0{,}038\) |
La lecture est directe : dans la tranche 0,65 – 0,80, le modèle a annoncé 72,1 % en moyenne et l'équipe désignée a gagné 73,1 % du temps. L'écart d'un point est négligeable.
Un modèle parfaitement calibré aurait une colonne « écart » entièrement nulle. Représentée graphiquement, sa courbe suivrait la diagonale.
Comment la lire honnêtement
Deux réflexes.
Regarder le signe des écarts. Ici, cinq des six écarts sont positifs : la réalité est systématiquement un peu au-dessus de l'annonce. Le modèle est légèrement sous-confiant — il gagne un peu plus souvent qu'il ne le dit. C'est le défaut le moins grave des deux, et la conséquence attendue d'une forte régularisation L2, qui tire les coefficients vers zéro et donc les probabilités vers 0,5.
Regarder \(n\) avant de conclure. L'écart le plus spectaculaire, \(+0{,}038\) dans la tranche haute, porte sur 112 matchs seulement. L'incertitude d'échantillonnage d'une fréquence observée vaut approximativement :
| Symbole | Signification |
|---|---|
| \(\hat{q}\) | Fréquence de victoire observée dans la tranche |
| \(n\) | Nombre de matchs dans la tranche |
| \(\sigma\) | Écart-type de cette fréquence, dû au seul hasard d'échantillonnage |
L'écart de 0,038 vaut donc environ 1,4 fois cet écart-type. C'est dans le bruit. Conclure « le modèle est sous-confiant sur les gros favoris » à partir de cette seule ligne serait une surinterprétation — le constat tient parce que cinq tranches sur six vont dans le même sens, pas parce que celle-ci est grande.
Erreur fréquente
Une courbe de calibration se lit avec les effectifs sous les yeux. Les tranches extrêmes sont toujours les moins peuplées et les plus bruyantes, et ce sont pourtant celles qui attirent l'œil. Sans les \(n\), une table de calibration est un test de Rorschach.
Calibration et discrimination sont deux choses
Un modèle qui annoncerait la fréquence de base — mettons 0,55 — à absolument tous les matchs serait parfaitement calibré et totalement inutile : il ne sépare rien. C'est le terme de résolution du Brier qui l'en empêche.
Inversement, un modèle très discriminant mais surconfiant classera bien les matchs tout en annonçant des probabilités mensongères. C'est le cas que le projet redoute le plus, parce que c'est celui qui trompe le Monte Carlo sans se faire remarquer à l'accuracy.
Un bon modèle a besoin des deux. C'est exactement ce que la somme « fiabilité \(-\) résolution » du Brier arbitre en un seul chiffre.
Les repères, et leurs caveats
Tous les chiffres ci-dessous portent sur les mêmes 1 146 matchs du holdout, à l'exception explicite de la dernière ligne.
| Repère | Brier | Log-loss | Accuracy |
|---|---|---|---|
| Pièce lancée | 0,250 | 0,693 | 50 % |
| Glicko de Valve (baseline officielle) | 0,2422 | 0,677 | 56,0 % |
| Champion au départ de la campagne (XGBoost v2) | 0,2330 | 0,657 | 60,4 % |
Leader final segmodel |
0,2041 | 0,5916 | 67,9 % |
| Bookmakers (littérature, tier 1) | 0,198 | — | 68,7 % |
Les deux premiers repères sont des mesures internes. La pièce est une constante mathématique ; le Glicko de Valve est le modèle qui sert réellement à produire le classement officiel, recalculé sur nos données. Battre le Glicko était le minimum vital ; le leader final lui prend 0,038 de Brier et près de 12 points d'accuracy.
La dernière ligne n'est pas une mesure interne. Elle vient de la littérature et porte sur du tier 1. Le chapitre 1 détaille pourquoi la comparaison est indicative : notre pool mélange les niveaux, ce qui rend mécaniquement les matchs plus faciles à départager.
Limite importante
L'écart entre 0,2041 et 0,198 vaut 0,0061. C'est moins que l'incertitude d'échantillonnage du niveau absolu du Brier sur 1 146 matchs, que l'on peut estimer à environ \(\pm 0{,}005\) (un écart-type, reconstitué depuis la table de calibration).
Dire « nous sommes à 0,0061 des bookmakers » est donc une phrase à manipuler avec des pincettes : sur des pools différents, avec une incertitude de cet ordre, ce n'est pas une distance mesurable, c'est un ordre de grandeur.
Attention toutefois : cette incertitude de \(\pm 0{,}005\) concerne le niveau absolu. Comparer deux de nos approches entre elles est une comparaison appariée — mêmes matchs, mêmes résultats, seules les probabilités changent — dont l'incertitude est nettement plus petite. C'est ce qui permet de départager 0,2041 et 0,2044. Plus petite, mais pas nulle : le chapitre 3 montre ce qu'il advient quand on l'oublie.
Ce que ces métriques ne disent pas
Trois angles morts, à garder en tête pour tout le reste du cours.
Elles ne mesurent pas l'objectif final. L'objectif du projet est \(P(\text{invitation au Major})\), pas le Brier par match. Un modèle légèrement moins bon en moyenne mais meilleur sur les équipes en lutte pour le dernier slot serait préférable — aucune des trois métriques ne le détecte.
Elles sont agrégées. Un Brier global de 0,2041 recouvre 0,1722 sur LAN et 0,2205 sur le Bo3 en ligne entre équipes établies. La moyenne cache où le modèle travaille bien et où il rame.
Elles ne disent rien du gain économique. Battre un bookmaker au Brier n'est pas battre le marché : il faudrait tenir compte de la marge intégrée aux cotes. Ce projet ne parie pas, la question ne se pose pas — mais la confusion est fréquente et vaut d'être écartée explicitement.
À retenir
- Accuracy : simple, lisible, aveugle à tout ce qui n'est pas le côté de 0,5. Indicateur de contrôle, jamais critère de décision.
- Brier \(=\frac{1}{n}\sum (p_i - y_i)^2\) : juge de paix du projet, parce qu'il contient explicitement la calibration, qu'il est borné et qu'il reste lisible. Pièce = 0,25 ; leader = 0,2041.
- Log-loss \(=-\frac{1}{n}\sum [y_i \ln p_i + (1-y_i)\ln(1-p_i)]\) : ce que les modèles minimisent réellement, mais dominée par quelques erreurs confiantes. Pièce \(= \ln 2 \approx 0{,}693\) ; leader = 0,5916.
- Une table de calibration par tranches se lit avec les effectifs : dans le holdout, cinq écarts sur six sont positifs — le leader est légèrement sous-confiant, effet attendu de la régularisation.
- Les repères externes (0,198) viennent d'un autre pool. À côté d'une incertitude de l'ordre de \(\pm 0{,}005\) sur le niveau absolu, ils indiquent une ambition, pas un verdict.
Chapitre suivant : Le protocole — comment on s'assure que tous ces chiffres veulent dire quelque chose.