Leçons généralisables
Ce chapitre range CS2 au placard. Ce qui suit vaut pour n'importe quel problème où l'on apprend un modèle sur des données historiques pour prédire un événement futur : churn de clients, défaut de paiement, panne d'équipement, résultat sportif, conversion publicitaire.
Huit leçons. Chacune a coûté quelque chose pendant la campagne, et chacune est adossée à un chiffre qu'on peut vérifier. La dernière — savoir s'arrêter — est celle qui n'a été comprise qu'au tout dernier chantier.
1. La donnée bat le modèle, et ce n'est pas serré
C'est la leçon la plus banale de l'apprentissage appliqué, et c'est aussi celle qu'on continue d'ignorer parce qu'elle est moins amusante que de régler un modèle. Cette campagne l'a chiffrée.
Sur les 0.0381 point de Brier gagnés entre la baseline et le leader :
- 89 % viennent d'apports d'information — nouvelles familles de features extraites d'un cache déjà présent, nouvelles horloges de force, historique plus long, sources externes ;
- 4 % viennent de raffinements de modélisation — interactions, mélange par segment, sélection de features ;
- le reste se partage entre effets croisés.
Le contre-exemple parfait est disponible : une exploration entière a été consacrée au réglage des arbres de décision. Trois bibliothèques, cinquante essais d'optimisation chacune, mise en sac de huit modèles, calibrations testées. Meilleur résultat sur le jeu de test : 0.2331, contre 0.2330 pour le modèle non réglé qu'il devait battre.
Pendant ce temps, une autre exploration analysait des tables HTML que personne n'avait jamais lues dans un cache déjà sur le disque, et gagnait 0.0042 point.
À retenir — la question à se poser avant de régler quoi que ce soit
« Ai-je épuisé ce que mes données contiennent déjà ? » Dans cette campagne, la réponse était non pendant quatre chantiers consécutifs. Le cache contenait des statistiques par joueur, un veto de cartes, des scores par manche avec les mi-temps, et un historique de classement daté — tout cela était sur le disque depuis le premier jour.
Corollaire moins évident : l'initialisation de vos états est une donnée. Le plus gros gain unitaire de la campagne (−0.0072, deux tiers du saut d'assault) vient d'une seule décision : étendre la fenêtre d'historique de six à douze mois, pour que les ratings arrivent chauds au moment de l'évaluation. Aucune feature nouvelle, aucun modèle nouveau — juste des compteurs qui avaient eu le temps de converger.
Si votre pipeline entretient un état — rating, moyenne glissante, score de récence, compteur d'événements — posez-vous la question : au moment où j'évalue, depuis combien de temps cet état tourne-t-il ? Si la réponse est « à peu près autant que la durée de vie typique du signal », vous mesurez un modèle qui n'a pas fini de démarrer.
2. Le linéaire bat les arbres dès que les features sont bonnes
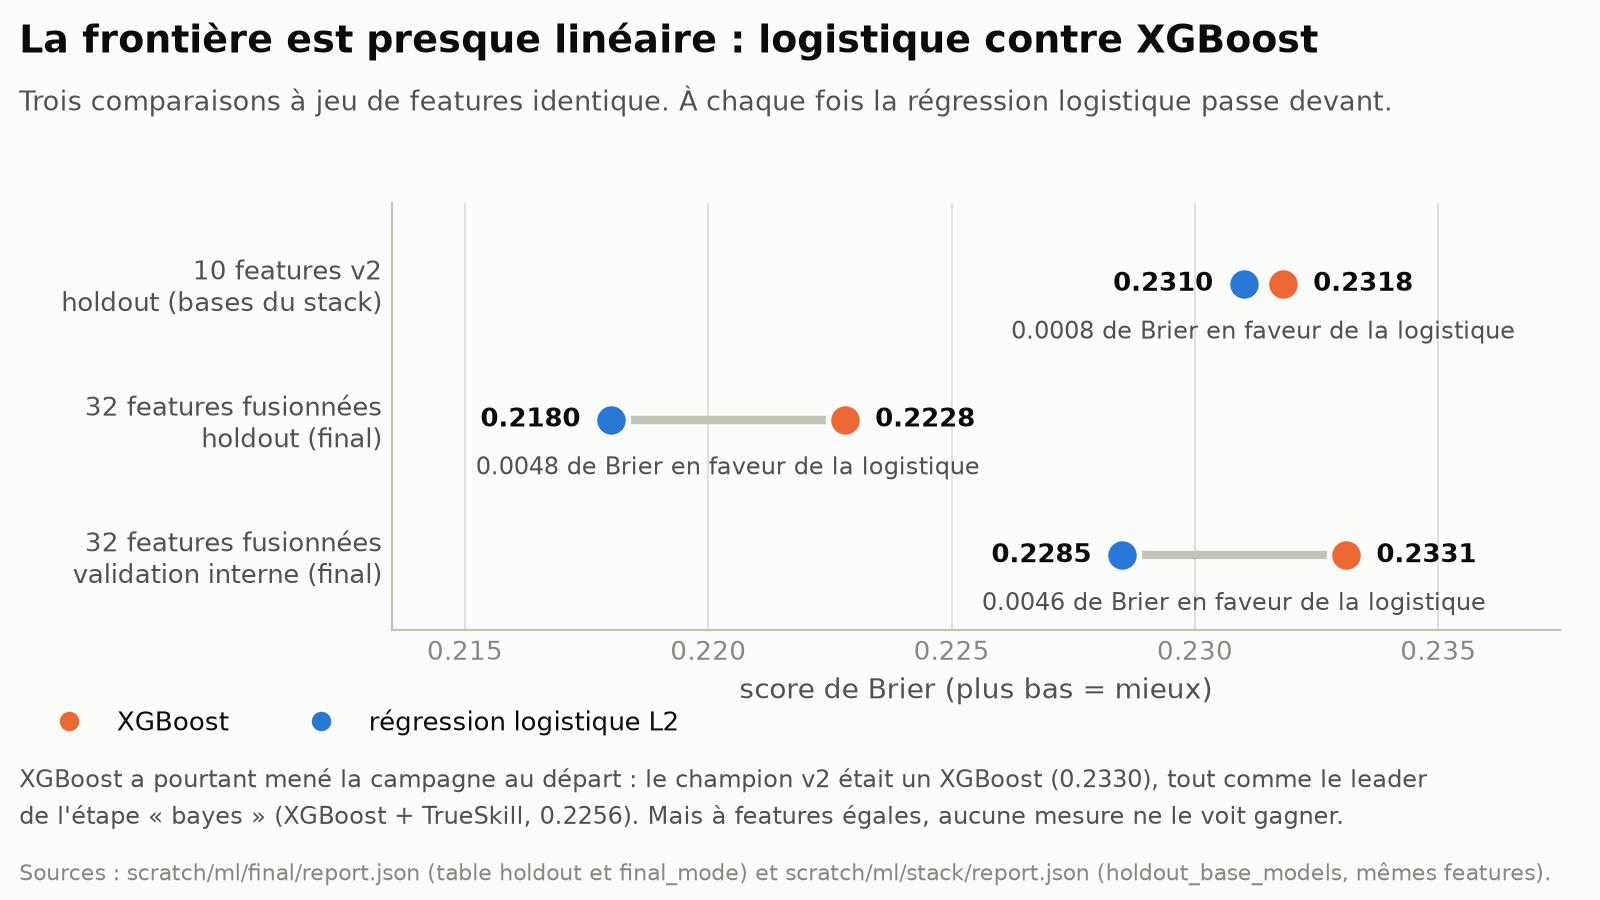
Ce résultat est apparu quatre fois, indépendamment, à quatre moments de la campagne.
| Où | Modèle linéaire | Arbres | Écart |
|---|---|---|---|
| Concours — logistique 22 features contre champion 10 features | 0.2315 | 0.2330 | −0.0015 |
| Empilement — mêmes features des deux côtés | 0.2310 | 0.2329 | −0.0019 |
| Fusion — mêmes 32 features, validation interne | 0.2285 | 0.2331 | −0.0046 |
| Réglage automatique exhaustif de trois bibliothèques, holdout | — | 0.2331 | — |
Les deux lignes du milieu sont les seules comparaisons à features strictement identiques ; ce sont aussi les plus nettes.
À partir de la fusion, tous les leaders de la campagne sont des régressions logistiques régularisées. Le leader final est une logistique à 54 features mélangée à une seconde logistique.
L'explication n'est pas que les arbres sont mauvais. C'est que les arbres servent à découvrir des interactions et des seuils que vous n'avez pas encodés. Quand vos features sont déjà des différences signées entre deux équipes — écart d'Elo, écart de forme, écart de part de manches — vous avez déjà fait le travail que les arbres feraient : vous avez centré le problème sur zéro et rendu la frontière presque droite.
Il reste alors deux inconvénients aux arbres et aucun avantage : ils ont plus de variance, et ils produisent des probabilités moins lisses.
La confirmation la plus nette vient d'une idée qui devait marcher. La recette GBDT→LR de Facebook (2014) consiste à faire pousser un petit ensemble d'arbres, à transformer les feuilles atteintes en variables indicatrices, et à donner ces indicatrices à une régression logistique. C'est une méthode éprouvée sur des données publicitaires. Résultat ici : 0.2405 et au-delà, très loin de la logistique nue à 0.2263. Les feuilles n'apportaient que du bruit.
Erreur fréquente — croire qu'un résultat de littérature se transporte
GBDT→LR fonctionne sur des features catégorielles à très haute cardinalité, où les interactions à découvrir sont innombrables. Nos features sont une quarantaine de différences continues. Le contexte de validité d'une méthode fait partie de la méthode ; le rapport d'origine le dit, l'usage ne le retient pas toujours.
Test pratique pour votre projet : entraînez la logistique avant l'arbre, sur exactement les mêmes features. Si elle est à moins d'un pour cent, ne prenez pas l'arbre — vous perdez l'interprétabilité et le calibrage pour rien.
3. L'ensemblage exige que les erreurs soient décorrélées
Un ensemble de modèles ne combine pas des prédictions : il combine des désaccords. S'il n'y a pas de désaccord, il n'y a rien à gagner.
Cette campagne a testé l'ensemblage deux fois, dans deux régimes opposés, et les deux ont échoué pour des raisons différentes.
Premier essai — pas de diversité. L'approche « stack » construit cinq modèles de base, produit des prédictions hors-échantillon par blocs temporels, choisit son méta-modèle et son calibrateur par validation interne. Tout est fait dans les règles. Gain : 0.2329 → 0.2306, soit 0,23 point, contre 0,5 à 1 point attendus.
Le rapport identifie la cause : les cinq bases partagent les mêmes features. Un XGBoost et une logistique entraînés sur les mêmes colonnes se trompent sur les mêmes matchs.
Second essai — de la diversité, et toujours rien. Le chantier lastmile a repris le problème par le bon bout : six modèles de base sans aucune feature partagée, un par famille de signal. Horloges bayésiennes, statistiques joueurs, cartes et manches, rang mondial, économie par manche, features de base. Prédictions hors-échantillon par six blocs temporels, méta-logistique nourrie des logits et du désaccord entre bases.
| Configuration | Brier en validation |
|---|---|
| Empilement sur familles disjointes, seul | 0.2201 |
| Empilement + modèle plat à 46 features | 0.2178 |
| Mélange 50/50 empilement / meilleur modèle | 0.2170 |
| Modèle plat, sans empilement | 0.2163 |
La diversité était bien là — et l'empilement a quand même perdu.
Intuition — pourquoi le modèle plat gagne quand même
Un empilement fait travailler chaque base en aveugle sur sa famille, puis demande à un méta-modèle de les recombiner. Un modèle plat sur l'union des features voit toutes les colonnes en même temps et peut exploiter les interactions entre familles — par exemple entre l'incertitude d'une horloge et un écart de statistiques joueurs.
L'empilement détruit cette information au niveau des bases et demande au méta de la reconstituer à partir de six nombres. Il ne peut pas.
L'empilement gagne quand les bases sont fortes individuellement et structurellement différentes (un modèle temporel, un modèle textuel, un modèle graphe). Il perd quand toutes les bases sont le même modèle nourri de sous-ensembles de colonnes.
Règle pratique : avant de monter un empilement, mesurez la corrélation des erreurs de vos bases. Si elle dépasse 0,9, gardez la meilleure et passez à autre chose. Et testez systématiquement le modèle plat sur l'union des features — c'est la ligne de base que l'empilement doit battre, pas la meilleure base individuelle.
4. La validation peut mentir, et elle ment de façon crédible
C'est la leçon la plus coûteuse à apprendre, parce que le mensonge est indistinguable de la vérité au moment où on le lit.
Quatre épisodes datés de cette campagne, dont un seul où la validation a dit vrai.
| Heure (UTC) | Chantier | Validation | Holdout | Verdict |
|---|---|---|---|---|
| 25/08 04 h 54 | segmodel | 0.2147 contre 0.2163 | 0.2041 contre 0.2044 | confirmé |
| 25/08 06 h 59 | hardcore | 0.2135 contre 0.2147 | 0.2042 contre 0.2041 | démenti |
| 25/08 08 h 14 | ultimate | 0.2157 contre 0.2147 | 0.2041 = contrôle | mort en validation |
| 25/08 09 h 28 | lastcard | 0.2135 contre 0.2147 | 0.2044 contre 0.2041 | démenti |
L'épisode où elle avait raison. Le candidat segmodel affiche le meilleur score de validation jamais observé, il est repris, exploré, et confirmé en holdout. La validation avait dit vrai.
Les deux épisodes où elle avait tort. hardcore et lastcard affichent tous deux exactement −0.0012 en validation. Les deux résultats sont cohérents avec une théorie solide — compromis biais-variance sur un segment à faible signal pour le premier, préchauffage d'horloge éprouvé ailleurs pour le second. Les deux sont reproduits sur une grille entière : 110 configurations pour hardcore, six variantes convergentes pour lastcard. Les deux s'effondrent en holdout, à +0.0001 et +0.0003.
L'épisode intermédiaire. ultimate n'a même pas atteint le holdout avec un candidat : l'idée dégradait déjà en validation (0.2157 contre 0.2147), et le protocole prévoyait de n'aller plus loin qu'en cas de gain. La discipline a économisé une passe.
La différence entre l'épisode réussi et les deux démentis n'est visible sur aucune métrique de validation. Elle tient à la taille de l'échantillon sur lequel la décision est prise : le segment dur ne compte que 531 matchs dans la fenêtre de validation, et un écart de 0.0012 sur 531 observations est du bruit.
Erreur fréquente — croire qu'un seuil de déclenchement suffit
lastcard avait fait les choses correctement : un seuil de bruit de 0.0005 fixé avant de mesurer, et la passe holdout déclenchée seulement s'il était franchi. Il l'a été, largement — et le résultat était quand même du bruit.
Un seuil fixé d'avance protège contre l'auto-persuasion, pas contre l'insuffisance de l'échantillon. Pour être honnête, ce seuil aurait dû être calculé à partir de la taille du jeu de validation, pas choisi rond.
La raison pour laquelle un tel seuil est illusoire tient à un mécanisme arithmétique, qui vaut pour toute sélection de candidats.
Limite importante — 110 configurations sur 531 matchs, c'est une pêche
Le mécanisme est arithmétique. Quand on évalue \(N\) candidats sur un échantillon de validation, le meilleur des \(N\) a un score qui contient le vrai signal plus le meilleur tirage de bruit parmi \(N\). Plus \(N\) est grand et plus l'échantillon est petit, plus cette prime au bruit est grosse.
Avec 110 candidats sur 531 matchs, une amélioration apparente de 0.0012 est parfaitement compatible avec l'absence totale d'effet.
Trois défenses pratiques, toutes appliquées dans cette campagne :
Un jeu de test qui n'est jamais consulté pour décider. C'est ce qui a permis de trancher : la validation disait oui, le holdout a dit non, et on a cru le holdout parce qu'il n'avait servi à rien d'autre.
Un contrôle de reproduction à chaque étape. Chaque chantier commence par re-mesurer le leader précédent et vérifier qu'il retombe sur le même chiffre : squeeze reproduit à 0.2153 contre 0.2154 publié, assault à 0.2054 exact, segmodel à 0.2041 exact chez hardcore, chez ultimate et chez lastcard. Sans ce contrôle, une amélioration apparente peut venir d'un changement silencieux du pipeline — et le +0.0003 de lastcard aurait pu passer pour un problème de données plutôt que pour ce qu'il était.
Se méfier des gains inférieurs au bruit de l'échantillon. Un ordre de grandeur utile : sur 1 000 observations binaires, l'écart-type du Brier est de l'ordre de 0.005. Un gain de 0.0012 mesuré sur 531 observations n'est pas mesurable ; un gain de 0.0100 sur 1 146 l'est. Les gains de 0.0010 et 0.0003 des deux derniers chantiers ne sont, honnêtement, pas distinguables de zéro — ils ont été retenus parce qu'ils allaient dans le bon sens et ne coûtaient rien, pas parce qu'ils sont établis.
5. Un instrument de mesure se corrompt en silence
Cette leçon-ci n'est pas une leçon de modélisation. C'est une leçon d'ingénierie, et elle a fait perdre plus de temps que toutes les mauvaises idées de features réunies.
Le rappel des faits : un test de non-régression qui tournait chaque jour affichait 0,63 à 1,11 point d'écart moyen le soir, et 4,83 à 6,75 le lendemain matin, sans qu'une ligne de code n'ait changé. Aucune erreur, aucun avertissement, tous les contrôles de complétude au vert. Juste des chiffres faux.
La cause était dans le cache : un listing paginé par décalage, dont deux tranches de pages provenaient de deux collectes différentes. Entre les deux générations, 35 matchs étaient tombés dans un trou et n'apparaissaient sur aucune page.
Trois enseignements, du plus spécifique au plus général.
L'état des entrées fait partie du résultat. Un chiffre de test n'est interprétable qu'accompagné d'une description de ce qu'il a lu. Dans ce cas précis, deux exécutions du même code sur la « même » base donnaient 6,09 et 1,18.
Une pagination par décalage n'est pas un identifiant stable. Dès que la source insère en tête, la page \(n\) d'hier et la page \(n\) d'aujourd'hui ne contiennent pas la même chose. Mettre en cache par numéro de page est une erreur de conception, pas un accident. Il faut mettre en cache par contenu, ou détecter le décalage.
Un cache sans expiration est correct exactement pour les contenus immuables. Le projet en a fait la liste explicite : les pages de match terminées, oui ; les pages d'événement en cours, les listings triés par date et les classements du jour, non. Le critère commun retenu : un contenu est figé quand son élément le plus récent a plus d'un jour.
À retenir — faire échouer bruyamment plutôt que mesurer faux
Le correctif final n'est pas une meilleure collecte : c'est une sentinelle. Si deux pages consécutives du cache viennent de générations différentes et laissent un trou temporel significatif, le calcul lève une erreur au lieu de produire un chiffre.
C'est la bonne forme du correctif. Un pipeline qui refuse de tourner sur une entrée douteuse coûte une intervention manuelle ; un pipeline qui produit un chiffre faux coûte une demi-journée d'enquête et, potentiellement, une décision prise à l'envers.
Les deux seuils de la sentinelle sont réglés sur des mesures et non sur l'intuition : le trou toléré est de 12 heures parce que la plus longue accalmie réelle observée est de 9,9 heures, et la tolérance en queue de fenêtre est de 14 jours parce qu'au-delà le poids d'ancienneté borne l'impact à environ un demi-point. Un garde-fou dont les seuils ne sont pas justifiés par une mesure finira désactivé — soit parce qu'il se déclenche trop, soit parce qu'il ne se déclenche jamais.
6. L'intégrité temporelle n'est pas négociable
Dans un problème de prédiction temporelle, la règle est simple à énoncer et facile à violer par accident : une feature d'un événement ne peut contenir que de l'information antérieure à cet événement.
La violation la plus courante n'est pas la triche. C'est l'inversion de deux lignes de code :
for match in matches_ordonnes_chronologiquement:
    etat.mettre_a_jour(match)          # ← FAUX : l'état contient déjà ce match
    features = etat.lire(match)
for match in matches_ordonnes_chronologiquement:
    features = etat.lire(match)        # ← JUSTE : l'état ignore ce match
    etat.mettre_a_jour(match)
La version fautive produit un modèle spectaculaire et sans valeur. Elle ne lève aucune erreur, ne dégrade aucune métrique, et n'est visible qu'en production — au moment où le modèle, privé de son information illicite, s'effondre.
La deuxième famille de violations est plus subtile : l'anachronisme de source. Une page web consultée aujourd'hui décrit l'état du monde d'aujourd'hui, même quand on l'utilise pour reconstituer une journée passée. La campagne précédente du projet — la reproduction du classement officiel — a buté dix fois sur ce mode de défaillance ; sept de ses dix correctifs sont des valeurs d'aujourd'hui injectées dans un calcul d'hier.
Exemples réels, tous corrigés : un drapeau « tournoi terminé » lu au présent alors qu'il fallait savoir s'il était terminé à la date rejouée ; une page d'événement mise en cache pendant le tournoi, figeant une dotation partielle pour toujours ; un rattachement entre tournois affiché tel qu'il est aujourd'hui et non tel qu'il était.
Erreur fréquente — croire qu'une source datée est temporellement propre
Le projet a récupéré 966 clichés de statistiques de carrière depuis des archives web. Chaque cliché porte sa date, donc l'intégrité temporelle est « gratuite » : on n'utilise un cliché que pour les matchs postérieurs à sa date.
Sauf que d'autres sources du même lot sont des instantanés à la date de capture : les statistiques par carte et les notes de joueurs d'une page d'équipe décrivent la situation au moment où la page a été téléchargée, pas à la date qu'on rejoue. Dans un même fichier, une colonne peut être datée point par point et la voisine ne pas l'être. C'est écrit noir sur blanc dans le rapport de collecte — et c'est le genre de note qu'il faut lire avant d'utiliser un jeu de données, pas après.
La question à poser à toute nouvelle source est toujours la même : « que disait cette source à la date que je rejoue ? » Si vous ne pouvez pas répondre, la source n'est pas utilisable pour un backtest.
7. Un échec chiffré vaut un succès
Les rapports de cette campagne contiennent plus d'échecs que de réussites, et c'est délibéré.
| Idée | Mesure | Statut |
|---|---|---|
| Recomposition de série depuis des modèles par carte | 0.2303 – 0.2379 | mort |
| GBDT→LR (feuilles d'arbres en features) | 0.2405 et + | mort |
| Empilement sur familles disjointes | 0.2201 | mort |
| Label multinomial 2-0 / 2-1 | 0.2292 | mort |
| XGBoost à contraintes monotones | 0.2302 | mort |
| Calibration forcée (Platt, isotonique) | dégrade partout | mort |
| Statistiques de carrière archivées | 0.2166 (19 % de couverture) | mort |
| Head-to-head pondéré par recouvrement de roster | 0.2264 | mort |
| Modèle simple sur le segment dur | +0.0001 en holdout | mort |
| Réglage exhaustif de trois bibliothèques d'arbres | 0.2331 | mort |
| Économie recalculée sur douze mois | 0.2157 en validation contre 0.2147 | mort |
TrueSkill par carte réchauffé (wtsm) |
+0.0003 en holdout | mort |
Un échec noté « ça n'a pas marché » sera retenté dans trois mois par quelqu'un qui aura oublié — ou par vous-même. Un échec noté « 0.2405 contre 0.2263, sur tel jeu, avec telle décision prise sur telle validation » est fermé définitivement, et il transporte de l'information : l'écart de 0.0142 entre GBDT→LR et la logistique nue ne dit pas seulement « ça rate », il dit « ça rate énormément, donc l'hypothèse sous-jacente — des interactions cachées à découvrir — est fausse ici ».
Trois pratiques qui rendent ça possible et qui ne coûtent presque rien :
Un rapport machine par chantier. Un fichier JSON qui accumule chaque évaluation sous un nom lisible, écrit après chaque mesure et non à la fin. Il sert de mémoire, de mécanisme de reprise après interruption, et de source pour la rédaction.
Un journal horodaté sur disque. Pas la sortie standard d'un terminal : un fichier. La campagne a perdu un run entier de plusieurs heures parce que la seule trace vivait dans une fenêtre qui a disparu.
La discipline d'écrire ce qu'on n'a pas fait. Le rapport d'assault liste explicitement les croisements coupés faute de temps ; le rapport de lastmile signale un candidat meilleur en validation que la logique d'adoption n'avait pas promu. Ce second aveu a directement produit le leader final de la campagne.
À retenir — la valeur d'un projet n'est pas son meilleur modèle
À la fin de cette campagne, le livrable qui vaut le plus n'est pas le fichier de 5 Ko contenant les coefficients du leader. C'est l'ensemble des rapports, qui disent quelles portes sont fermées, avec quels chiffres, et quelles portes restent ouvertes.
Le modèle sera périmé dans six mois. La carte des impasses, non.
8. Savoir s'arrêter est une mesure, pas un ressenti
La question « quand arrête-t-on ? » se tranche habituellement au feeling, à la fatigue ou au budget. Cette campagne a produit un critère chiffré, et elle l'a produit sans le chercher.
Le critère : le taux de survie des gains de validation.
Pendant la première moitié de la campagne, chaque gain détecté en validation s'est retrouvé en holdout. Six fois d'affilée — final, push, squeeze, assault, lastmile, segmodel. Le mécanisme fonctionnait : la validation proposait, le holdout confirmait.
Puis la relation s'est rompue, trois fois de suite, en deux heures et demie.
| Chantier | Ce que disait la validation | Ce qu'a dit le holdout |
|---|---|---|
| hardcore | −0.0012, sur 110 configurations convergentes | +0.0001 |
| ultimate | +0.0010 — l'idée meurt avant le holdout | contrôle exact, aucun candidat |
| lastcard | −0.0012, seuil de déclenchement franchi | +0.0003 |
À retenir — la règle d'arrêt
Tant que les gains de validation survivent au holdout, il reste du signal à extraire. Dès qu'ils cessent d'y survivre plusieurs fois de suite, le signal extractible de vos données est épuisé.
Ce n'est pas une intuition sur la difficulté du problème : c'est une propriété observable de votre dispositif expérimental, et elle se lit dans vos propres rapports.
Trois précisions pour que la règle soit utilisable.
Elle exige un holdout intact. Le critère repose entièrement sur le fait que le jeu de test n'a jamais servi à décider. Un holdout consulté vingt fois ne peut plus démentir personne — il dira ce que la validation dit, et vous continuerez à poursuivre du bruit indéfiniment.
Elle exige d'avoir compté les survies, pas seulement les échecs. Six succès consécutifs puis trois échecs consécutifs : c'est la séquence qui porte l'information, pas le dernier résultat. Sans le journal horodaté de chaque chantier, cette séquence n'existe pas.
Elle ne dit pas que le problème est résolu. Elle dit que ces données sont épuisées. C'est une conclusion sur le jeu de données, pas sur le plafond théorique : l'écart restant aux bookmakers tient à de l'information qu'on n'a pas, et il se rouvrira le jour où cette information arrivera.
Limite importante — trois n'est pas un nombre magique
« Trois échecs consécutifs » n'est pas un critère statistique établi ; c'est ce qui s'est produit ici, sur des chantiers coûteux, avec des gains apparents tous de même amplitude et tous démentis dans le même sens. Sur un projet où chaque chantier coûte une semaine, on s'arrêterait probablement après deux ; sur un projet où il coûte dix minutes, on continuerait plus longtemps.
Ce qui se généralise, c'est la quantité observée — le taux de survie des gains de validation au holdout — pas le seuil qu'on lui applique.
Récapitulatif
| # | Leçon | Le chiffre qui la porte |
|---|---|---|
| 1 | La donnée bat le modèle | 89 % du gain vient d'information, 4 % de modélisation |
| 2 | Le linéaire bat les arbres sur bonnes features | 0.2285 contre 0.2331 à features identiques |
| 3 | L'ensemblage exige des erreurs décorrélées | modèle plat 0.2163 contre empilement 0.2201 |
| 4 | La validation peut mentir | 1 confirmation contre 2 démentis, tous à −0.0012 en validation |
| 5 | Un instrument se corrompt en silence | 6,09 puis 1,18 sans changement de code |
| 6 | L'intégrité temporelle n'est pas négociable | 7 des 10 correctifs du moteur sont des anachronismes |
| 7 | Un échec chiffré vaut un succès | 12 portes fermées, chacune avec sa mesure |
| 8 | Savoir s'arrêter est une mesure | 6 gains de validation survivent, puis 3 d'affilée ne survivent plus |
Aucune de ces huit leçons ne parle de CS2. Six ne parlent même pas d'apprentissage automatique — elles parlent de conduite d'expériences. C'est probablement le vrai enseignement de la campagne : à ce niveau de maturité d'un projet, le facteur limitant n'est presque jamais l'algorithme.
Chapitre précédent : La carte de prévisibilité · Chapitre suivant : Épilogue · Glossaire