Segments et blends — le modèle qui a gagné
Le leader final n'est pas un modèle. C'est trois modèles logistiques : un global, un
entraîné sur les matchs où les deux équipes sont bien connues des horloges, un entraîné
sur les autres — et une règle de mélange qui les combine. Il s'appelle segmodel, il
marque Brier 0.2041, log-loss 0.5916, accuracy 67.9 % sur le holdout de 1 146 matchs,
et ce chapitre le construit pièce par pièce.
L'intuition : tous les matchs ne se prédisent pas pareil
Une régression logistique unique fait une hypothèse forte : le barème est le même pour tous les matchs. Un point d'écart TrueSkill vaut autant en finale de LAN que dans un Bo1 de qualification en ligne entre deux équipes que personne ne connaît.
C'est visiblement faux. En LAN, le public, le décalage horaire et l'enjeu changent les performances ; entre équipes obscures, les ratings sont eux-mêmes incertains, et il faudrait leur faire moins confiance. Le modèle devrait pouvoir dire : « dans ce contexte, écoute davantage cette feature-ci ».
Deux façons de le lui permettre, de la plus légère à la plus lourde :
   ① interaction                     ② mixture par régime

   un seul modèle, mais              deux modèles complets,
   des pentes qui changent           chacun entraîné sur sa
   selon un indicateur               moitié des données
                                     puis mélangés

   z = b + Σ wⱼ xⱼ                   p_seg = σ(w_seg·x)
       + γ·s + Σ δⱼ s xⱼ             p_glob = σ(w_glob·x)
                                     logit p = 0.75 logit p_seg
                                             + 0.25 logit p_glob
Les deux ont été mesurées. Les deux ont marché — la seconde un peu mieux.
① Les interactions segment × features
Une interaction est le produit de deux features. Si \(s \in \{0, 1\}\) est un indicateur de segment et \(x_j\) une feature, ajouter \(s \cdot x_j\) au modèle change l'équation en
où \(\mathcal{T}\) est l'ensemble des features choisies pour l'interaction, \(\gamma\) décale l'intercept dans le segment, et \(\delta_j\) modifie la pente de la feature \(j\) dans le segment. Concrètement :
- pour un match hors segment (\(s = 0\)), la pente de \(x_j\) est \(w_j\) ;
- pour un match dans le segment (\(s = 1\)), elle devient \(w_j + \delta_j\).
Un modèle linéaire enrichi d'interactions reste linéaire en ses paramètres — donc convexe, donc facile à ajuster — mais il n'est plus linéaire en ses features : c'est une fonction affine par morceaux.
Ce que lastmile a mesuré
L'approche lastmile a testé quatre indicateurs de segment, chacun croisé avec les 7
features les plus fortes du modèle :
| Bloc d'interactions testé | Brier validation |
|---|---|
| référence : 46 features, sans interaction | 0.2169 |
+ lan × 7 features |
0.2172 |
+ bo3 × 7 features |
0.2180 |
+ inf × 7 features |
0.2163 |
+ stakes × 7 features |
0.2168 |
Trois des quatre dégradent. Le seul qui apporte quelque chose est inf, l'indicateur
« les deux équipes sont bien connues des horloges ». Les 7 features croisées sont
melo_diff, ts_diff, glicko_diff, hr_rank_diff, round_share_diff, wmelo_diff
et pi_diff_a — que des écarts de force.
Le modèle passe donc de 46 à 54 features : les 46 d'origine, plus inf, plus les 7
produits inf × feature. Gain : 0.0006 de Brier en validation. C'est ce modèle à 54
features qui, porté sur le holdout, a donné 0.2044 et pris la tête du concours.
Intuition — ce que dit ce gain
Que inf × écart de force améliore les choses signifie : quand les horloges
connaissent bien les deux équipes, il faut leur faire davantage confiance. C'est
exactement ce qu'on espérait — et c'est aussi la seule des quatre hypothèses testées
qui ait survécu à la mesure. Les trois autres (LAN, format, enjeu) modifient
peut-être le jeu, mais pas la façon dont les features doivent être lues.
L'indicateur inf, précisément
L'indicateur repose sur ts_sigma_sum, une feature produite par
l'horloge TrueSkill :
où \(\sigma_i\) est l'écart-type que TrueSkill maintient sur le niveau du joueur \(i\), pour les dix joueurs des deux équipes. C'est une mesure d'ignorance : elle est grande quand le système n'a vu que peu de matchs des joueurs concernés, petite quand tout le monde est bien étalonné.
Ordres de grandeur, avec nos réglages (\(\sigma\) initial \(= 25/3 \approx 8.33\)) :
| Situation | ts_sigma_sum |
|---|---|
| dix joueurs jamais vus | \(\sqrt{10 \times 8.33^2} \approx 26.4\) |
| médiane de notre jeu d'entraînement | 17.41 |
| dix joueurs très établis | nettement sous 15 |
L'indicateur est alors défini par
Le seuil \(\tau = 17.41\) est un quantile calculé sur le jeu d'ajustement seulement, jamais sur la validation ni sur le holdout — sinon la définition même du segment serait contaminée par le futur.
② La mixture par régime
L'étape suivante va plus loin que des pentes différentes : elle entraîne un modèle entier par segment.
Pour chaque valeur \(v \in \{0, 1\}\) de l'indicateur :
- on extrait du jeu d'ajustement les matchs tels que \(s = v\) ;
- si ce sous-ensemble dépasse 300 lignes, on y entraîne une logistique complète (mêmes 54 features, même \(C = 0.3\), même standardisation — mais recalculée sur le sous-ensemble) ;
- à la prédiction, chaque match reçoit la sortie du modèle de son segment, mélangée à celle du modèle global.
Le garde-fou des 300 lignes n'est pas décoratif : sans lui, un segment rare produirait un modèle à 54 poids ajustés sur quelques dizaines de matchs, c'est-à-dire du bruit certifié. Avec un seuil à la médiane, chaque segment reçoit environ la moitié des 9 479 lignes d'ajustement, ce qui est confortable.
Le mélange se fait en logits
Voici la formule exacte, telle qu'elle est codée dans run_segmodel.py et reprise dans
le code de production vrs/winprob.py :
avec \(w = 0.75\) pour le leader : trois quarts au modèle de segment, un quart au modèle global.
Pourquoi pas une simple moyenne de probabilités ?
Parce qu'un mélange en logits est une moyenne géométrique des cotes. En repassant à l'exponentielle :
Trois exemples numériques montrent la différence de comportement :
| \(p_{\text{seg}}\) | \(p_{\text{glob}}\) | Blend de logits (\(w = 0.75\)) | Moyenne arithmétique |
|---|---|---|---|
| 0.70 | 0.60 | 0.676 | 0.675 |
| 0.90 | 0.60 | 0.852 | 0.825 |
| 0.05 | 0.50 | 0.099 | 0.163 |
Au centre, les deux méthodes sont indiscernables. Aux extrêmes, elles divergent radicalement : quand un modèle annonce 5 % et l'autre 50 %, la moyenne arithmétique rend 16 % — elle ne peut jamais descendre en dessous d'un quart de l'écart au plus prudent — là où le blend de logits rend 10 %, beaucoup plus près de l'avis tranché.
Intuition — mélanger des avis, pas des chiffres
Une probabilité de 0.5 est une absence d'information ; une probabilité de 0.02 est une information très forte. Sur l'échelle des probabilités, ces deux affirmations sont à 0.48 l'une de l'autre ; sur l'échelle des logits, elles sont à 3.9. Le logit est la bonne échelle pour combiner des avis, parce que c'est l'échelle sur laquelle l'information s'ajoute — c'est aussi, exactement, l'échelle sur laquelle nos modèles logistiques travaillent.
La grille de sélection
Tout a été balayé sur la validation interne (les 808 matchs qui précèdent le holdout), jamais sur le holdout. Quatre axes :
- la variable de segmentation :
ts_sigma_sum(ignorance des horloges) ouwn_min, le log du nombre de matchs d'historique de l'équipe la moins couverte ; - le seuil : quantile 0.35, 0.50 ou 0.65 du jeu d'ajustement ;
- le poids du blend \(w\) : 0.25, 0.50 ou 0.75 ;
- le jeu de features : 46 ou 54.
Soit 36 combinaisons, plus les repères. Extrait des résultats :
| Configuration | Brier validation |
|---|---|
| global 46 features, sans segment (référence) | 0.2169 |
lastmile 54 features, sans segment |
0.2163 |
segment ts_sigma_sum médiane, \(w = 0.25\), 54 f |
0.2155 |
segment ts_sigma_sum médiane, \(w = 0.50\), 54 f |
0.2149 |
segment ts_sigma_sum médiane, \(w = 0.75\), 54 f |
0.2147 |
segment ts_sigma_sum médiane, \(w = 0.75\), 46 f |
0.2148 |
segment ts_sigma_sum quantile 0.35, \(w = 0.50\), 54 f |
0.2159 |
segment ts_sigma_sum quantile 0.65, \(w = 0.50\), 54 f |
0.2159 |
segment wn_min médiane, \(w = 0.50\), 54 f |
0.2161 |
segment wn_min quantile 0.35, \(w = 0.75\), 46 f |
0.2177 |
Trois enseignements se lisent dans ce tableau.
D'abord, la médiane gagne contre les deux autres quantiles, sur les deux jeux de features. Couper l'échantillon en deux moitiés égales donne à chaque modèle le maximum de données ; couper au tiers ou aux deux tiers déséquilibre sans rien apporter.
Ensuite, plus de poids au segment est mieux : \(w\) va de 0.25 (0.2155) à 0.75 (0.2147) en s'améliorant à chaque cran. Les modèles de segment sont vraiment meilleurs sur leur domaine ; le global ne sert plus que de garde-fou.
Enfin, wn_min ne segmente rien d'utile : toutes ses variantes sont entre 0.2160 et
0.2177, c'est-à-dire au niveau ou en dessous du modèle sans segment. Compter les matchs
d'historique n'est pas la même chose que mesurer l'incertitude des ratings — la seconde
information est plus fine, parce qu'elle intègre la cohérence des résultats et pas
seulement leur nombre.
Erreur fréquente
Conclure de ce tableau qu'un segment améliore forcément un modèle. La moitié des lignes de la grille complète fait moins bien que le modèle plat. Une segmentation n'aide que si le mécanisme de décision diffère réellement entre les deux régimes ; sinon elle divise l'échantillon pour rien.
Le résultat sur le holdout
Une seule passe, avec le contrôle d'intégrité obligatoire (rejouer le leader précédent et vérifier qu'on retrouve son chiffre exact) :
| Modèle | n | Brier | Log-loss | Accuracy |
|---|---|---|---|---|
lastmile rejoué (contrôle) |
1 146 | 0.2044 | 0.5931 | 67.5 % |
segmodel (candidat choisi en validation) |
1 146 | 0.2041 | 0.5916 | 67.9 % |
Le gain est de 0.0003 de Brier. Il faut le dire franchement : c'est minuscule.
L'incertitude d'un Brier mesuré sur 1 146 matchs est de l'ordre de 0.005 — un calcul d'ordre de grandeur obtenu en supposant le modèle parfaitement calibré et en prenant l'écart-type des contributions individuelles \((p_i - y_i)^2\) à partir de notre propre table de calibration. La comparaison entre deux modèles sur les mêmes matchs est appariée, donc bien plus précise que cela — les deux modèles se trompent en grande partie sur les mêmes rencontres, et seule la différence compte. Mais même appariée, une différence de 0.0003 n'établit pas grand-chose à elle seule.
Ce qui rend le résultat crédible n'est pas ce 0.0003 isolé : c'est que la même configuration était déjà en tête sur la validation interne (0.2147 contre 0.2163), sur une fenêtre disjointe, et que l'ordre des trois modèles est le même des deux côtés.
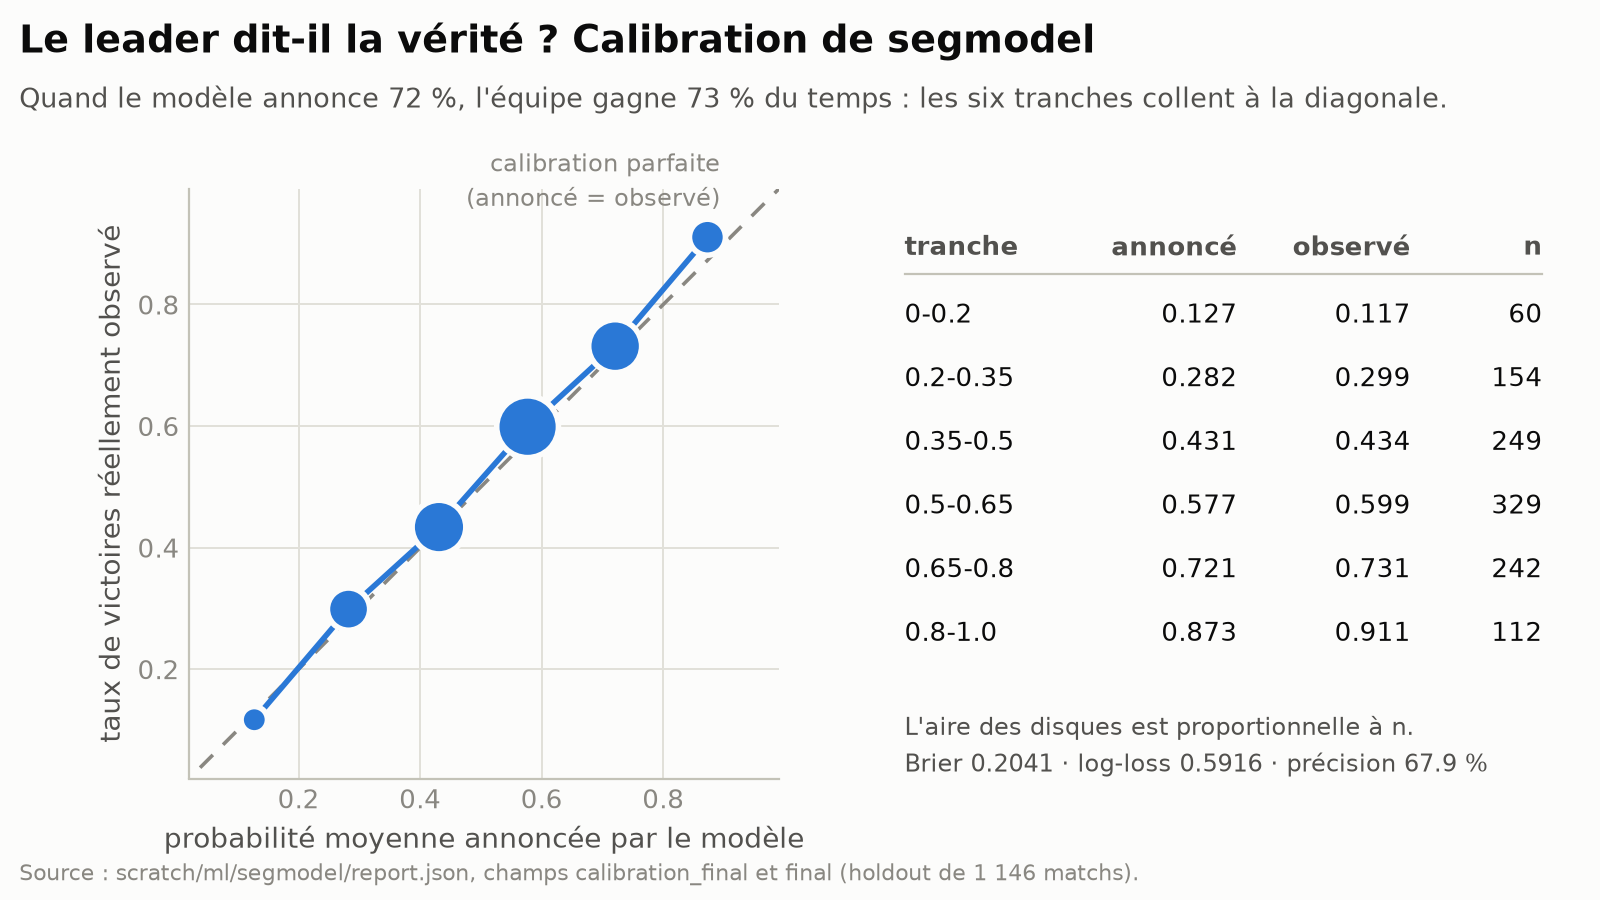
La calibration du leader
| Tranche | n | Probabilité moyenne annoncée | Taux de victoire réel |
|---|---|---|---|
| 0 – 0.2 | 60 | 0.127 | 0.117 |
| 0.2 – 0.35 | 154 | 0.282 | 0.299 |
| 0.35 – 0.5 | 249 | 0.431 | 0.434 |
| 0.5 – 0.65 | 329 | 0.577 | 0.599 |
| 0.65 – 0.8 | 242 | 0.721 | 0.731 |
| 0.8 – 1.0 | 112 | 0.873 | 0.911 |
C'est une calibration propre : l'écart maximal est de 0.038, dans la tranche haute où l'échantillon est le plus petit, et le modèle y est sous-confiant (il annonce 87 %, il obtient 91 %). À comparer au champion XGBoost, dont la tranche 0.65–0.8 annonçait 72.8 % pour 64.5 % réels — un écart de 8 points, dans le mauvais sens.
Voir la figure calibration-leader.png.
La carte des segments
Une fois la passe holdout consommée, on peut la découper — sans rien réentraîner, sans rien choisir : c'est du pur reporting, autorisé parce qu'aucune décision n'en dépend. C'est la partie la plus riche d'enseignements de toute la campagne.
| Segment | n | Brier | Accuracy |
|---|---|---|---|
horloges froides (inf = 0) |
244 | 0.1591 | 75.0 % |
| Bo1 (non-Bo3) | 60 | 0.1729 | 76.7 % |
| LAN | 380 | 0.1722 | 74.7 % |
| ensemble du holdout | 1 146 | 0.2041 | 67.9 % |
| Bo3 | 1 086 | 0.2058 | 67.4 % |
horloges informées (inf = 1) |
902 | 0.2163 | 66.0 % |
| en ligne (non-LAN) | 766 | 0.2199 | 64.5 % |
| noyau dur : en ligne ET Bo≥3 | 758 | 0.2205 | 64.3 % |
Voir la figure segments.png.
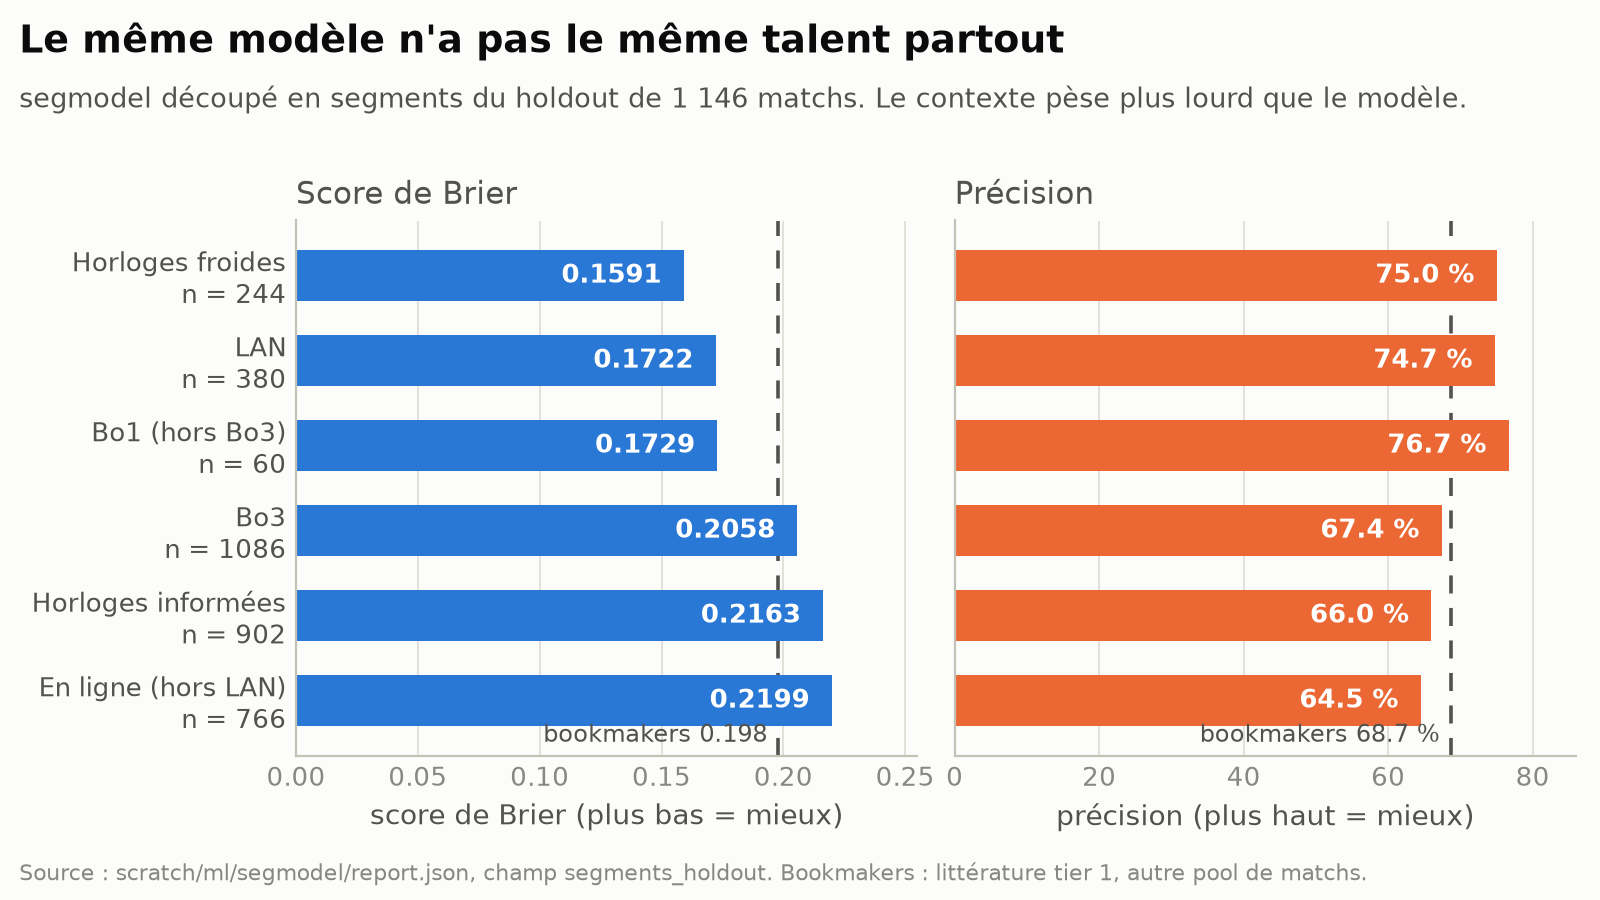
L'amplitude est spectaculaire : de 0.1591 à 0.2205, soit un facteur 1.4 sur le Brier entre le pocket le plus prévisible et le noyau le plus dur. Sur le segment LAN, le modèle atteint 0.1722 et 74.7 % d'accuracy — c'est-à-dire, en apparence, mieux que le repère bookmakers (0.198 / 68.7 %). En apparence seulement : ce repère de littérature porte sur un pool tier 1, pas sur nos matchs de LAN toutes catégories confondues, où les écarts de niveau sont plus francs.
Limite importante — l'hypothèse de départ était inversée
Tout le monde, y compris nous, aurait parié que les matchs « bien informés » (les
deux équipes bien connues des horloges) seraient les plus faciles à prédire. La
mesure dit l'inverse : inf = 1 donne 0.2163 et inf = 0 donne 0.1591.
L'explication tient en une phrase : une équipe mal connue des horloges est en général une équipe obscure, et une équipe obscure joue le plus souvent contre beaucoup plus fort qu'elle. Le segment « froid » n'est pas un segment de matchs incertains, c'est un segment de mismatchs, où même un modèle grossier voit juste.
Il faut donc distinguer deux choses qu'on confond spontanément : la quantité d'information dont on dispose, et la difficulté intrinsèque du match. Elles sont ici corrélées négativement. À rapprocher du démarrage à froid, qui a montré de son côté combien coûtent les états mal étalonnés.
Le corollaire pratique est net. Le progrès qui reste à faire ne se trouve pas là où le modèle est déjà bon, mais dans le noyau dur — 758 matchs de Bo3 en ligne entre équipes établies, Brier 0.2205, accuracy 64.3 %. C'est exactement ce segment qu'une approche ultérieure a attaqué de front, et échoué à améliorer : voir le cimetière.
Pourquoi la mixture marche : biais et variance
Le raisonnement est classique et vaut la peine d'être posé.
Un modèle entraîné sur tout le jeu de données voit beaucoup de lignes : sa variance est faible. Mais si le mécanisme de décision diffère entre régimes, il en apprend un compromis qui ne correspond à aucun des deux : son biais est élevé.
Un modèle entraîné sur un segment apprend le bon mécanisme pour ce segment : biais faible. Mais il voit deux fois moins de lignes : variance plus élevée.
Le blend \(w = 0.75\) est un curseur explicite entre les deux :
C'est, littéralement, un rétrécissement du modèle de segment vers le modèle global — la même idée que la régularisation L2 du chapitre 1, appliquée non plus aux poids mais aux prédictions. Et comme pour \(C\), le bon dosage est mesuré, pas deviné : la grille dit 0.75, avec 0.50 juste derrière.
Pour aller plus loin — pourquoi ne pas empiler les segments ?
Rien n'interdit en théorie de segmenter sur deux variables (LAN × informé, quatre modèles), voire d'apprendre l'appartenance au segment plutôt que de la fixer par un seuil — c'est ce que fait un mixture of experts, où un réseau de « gating » apprend à pondérer les experts en fonction de l'entrée.
Deux raisons de s'être arrêté là. La première est le volume : quatre segments sur 9 479 lignes d'ajustement, c'est 2 400 lignes par modèle de 54 poids, et le garde-fou des 300 lignes deviendrait vite actif. La seconde est la mesure : sur les quatre indicateurs testés en interaction, un seul apportait quelque chose. Il n'y avait pas quatre régimes à découvrir, il y en avait un.
Ce qui est parti en production
Le code de production vrs/winprob.py implémente exactement ce modèle, avec les mêmes
constantes déclarées en tête de fichier :
C_L2 = 0.3            # régularisation retenue par lastmile/segmodel
W_SEGMENT = 0.75      # poids du modèle de segment dans le blend de logits
SEG_QUANTILE = 0.5    # seuil « informé » : médiane de ts_sigma_sum sur le train
MIN_SEGMENT = 300     # en dessous, pas de modèle de segment (règle segmodel)
Le modèle y est ré-entraîné chaque jour sur une fenêtre glissante de 12 mois, avec un contrôle out-of-sample rejoué à chaque entraînement — voir le chapitre 5.
À retenir
L'essentiel du chapitre
- Une interaction \(s \cdot x_j\) donne au modèle une pente différente selon le régime, sans quitter le cadre linéaire (donc convexe).
- Sur quatre indicateurs testés, un seul apporte quelque chose :
inf, construit à partir de l'incertitude TrueSkillts_sigma_sum, seuillée à sa médiane (17.41). - Une mixture par régime va plus loin : un modèle complet par segment, mélangé au modèle global. Garde-fou : pas de modèle de segment sous 300 lignes.
- Le mélange se fait en logits (moyenne géométrique des cotes), pas en probabilités : c'est l'échelle sur laquelle l'information s'ajoute.
- Le réglage retenu — segmentation à la médiane, \(w = 0.75\), 54 features — donne 0.2147 en validation et 0.2041 / 0.5916 / 67.9 % sur le holdout.
- La carte des segments est la vraie découverte : la difficulté varie d'un facteur 1.4, et l'hypothèse « mieux informé = plus prévisible » est inversée dans les faits.
Le chapitre suivant enterre proprement tout ce qui n'a pas marché : le cimetière.