Le gradient boosting — le champion déchu
XGBoost était le champion à battre au début du concours : Brier 0.2330 contre 0.2422 pour le Glicko de Valve. C'est aussi, sur données tabulaires, le premier réflexe de n'importe quel praticien — et un bon réflexe. Ce chapitre explique comment il fonctionne, comment il a été réglé chez nous, où il a gagné, et pourquoi il a fini par perdre.
Un arbre de décision, d'abord
Un arbre de décision pose des questions binaires sur les features et descend jusqu'à une feuille, qui porte une valeur.
                    ts_diff < 3.2 ?
                    ╱            ╲
                 oui              non
                 ╱                  ╲
       hr_rank_diff < 0 ?        lan == 1 ?
        ╱          ╲              ╱        ╲
      oui          non          oui        non
      ╱              ╲          ╱            ╲
  feuille A      feuille B   feuille C    feuille D
   −0.31           +0.08      +0.44        +0.22
Chaque feuille contient une valeur ajoutée au score (le logit), pas une probabilité. Un match descend l'arbre selon ses features et récolte la valeur de la feuille où il atterrit.
L'apprentissage consiste à choisir, à chaque nœud, la feature et le seuil qui séparent le mieux les victoires des défaites. Un arbre capture donc naturellement deux choses qu'un modèle linéaire ne voit pas :
- les non-linéarités : « au-delà de 200 points d'écart, l'écart supplémentaire ne change plus rien » se code en un seuil ;
- les interactions : un chemin qui teste
ts_diffpuislanencode « l'écart de niveau compte davantage en LAN » sans qu'on ait à le prévoir.
Le problème est qu'un arbre seul est instable et grossier. Profond, il apprend le bruit par cœur ; peu profond, il ne dit presque rien. D'où le boosting.
Le boosting : corriger ses erreurs, petit à petit
L'idée, formalisée par Friedman en 2001, est de construire une somme d'arbres où chaque arbre corrige ce que les précédents ont raté :
où :
- \(F_m\) est le score cumulé après \(m\) arbres (un logit, converti en probabilité par la sigmoïde du chapitre précédent) ;
- \(h_m\) est le \(m\)-ième arbre, entraîné sur les erreurs courantes ;
- \(\eta\) est le learning rate, un facteur de prudence entre 0 et 1.
La question est : sur quoi entraîner \(h_m\) ? Sur le gradient de la perte par rapport au score courant. Pour la log-loss, ce gradient a la forme rencontrée au chapitre 1 :
C'est simplement l'erreur signée. Un match annoncé à 0.80 et perdu (\(y = 0\)) a \(g = +0.80\) : il tire fort. Un match annoncé à 0.52 et gagné a \(g = -0.48\). Chaque arbre apprend donc à prédire dans quelle direction et de combien le score courant se trompe, et on ajoute une fraction \(\eta\) de sa correction.
Intuition — la descente d'un escalier
La régression logistique cherche un jeu de poids qui explique tout d'un coup. Le boosting avance par petits pas : il regarde ce qui reste faux, ajoute une petite correction ciblée, regarde à nouveau, corrige encore. Après quelques centaines de pas, la fonction obtenue peut être arbitrairement compliquée — c'est sa force, et c'est aussi ce qui le rend capable d'apprendre le bruit si on le laisse faire.
Ce que XGBoost ajoute
XGBoost affine ce schéma sur deux points. D'abord il utilise une approximation du second ordre de la perte, ce qui donne une formule fermée pour la valeur des feuilles :
où \(j\) désigne une feuille, \(g_i\) le gradient et \(h_i = p_i(1 - p_i)\) la dérivée seconde (hessienne) du match \(i\), et \(\lambda\) un terme de régularisation L2 sur les valeurs de feuille. On retrouve la logique du rétrécissement : plus une feuille contient peu de matchs (donc un \(H_j\) faible), plus \(\lambda\) écrase sa valeur vers zéro.
Ensuite il choisit chaque coupure en maximisant un gain explicite, qui compare la perte avant et après séparation, et refuse la coupure si le gain ne dépasse pas un seuil.
Les réglages, et ce qu'ils contrôlent
| Hyperparamètre | Ce qu'il fait | Effet quand on l'augmente |
|---|---|---|
eta (learning rate) |
fraction de chaque correction appliquée | apprentissage plus rapide, plus instable |
max_depth |
profondeur maximale d'un arbre | interactions plus riches, sur-ajustement plus facile |
min_child_weight |
poids minimal (somme des hessiennes) dans une feuille | feuilles plus peuplées, modèle plus lisse |
subsample |
fraction de lignes tirées par arbre | décorrèle les arbres, ajoute du bruit utile |
colsample_bytree |
fraction de features tirées par arbre | idem, sur les colonnes |
num_boost_round |
nombre d'arbres | capacité totale |
early_stopping_rounds |
arrêt si la perte de validation ne s'améliore plus | évite d'ajouter des arbres nuisibles |
Deux d'entre eux méritent d'être compris ensemble : eta et le nombre d'arbres se
compensent. Un eta deux fois plus petit demande environ deux fois plus d'arbres pour
la même capacité, mais donne un modèle plus lisse. Le petit eta est presque toujours
le bon choix quand le temps de calcul le permet — et sur 6 000 lignes, il le permet
largement.
Nos paramètres réels, et pourquoi ils sont si petits
Le champion de production (vrs/predict.py) utilise :
params = {"objective": "binary:logistic", "eval_metric": "logloss",
          "max_depth": 3, "eta": 0.05, "subsample": 0.8,
          "colsample_bytree": 0.8, "min_child_weight": 20}
booster = xgb.train(params, dtrain, num_boost_round=300,
                    early_stopping_rounds=30)
Le modèle final, après re-réglage sur la validation interne, n'a changé qu'une chose :
max_depth passé de 3 à 4, min_child_weight restant à 20. Le re-réglage a été jugé
sur le Brier de validation du mélange logistique + XGBoost, ce qui donnait 0.2293 pour
la profondeur 4 contre 0.2297 pour la profondeur 3 — un écart de 0.0004, c'est-à-dire
rien du tout, mais rien du tout dans le bon sens.
Ces valeurs sont beaucoup plus timides que les réglages qu'on voit sur les gros jeux de données. La raison est arithmétique.
Le calcul qui explique tout
Le jeu d'entraînement du concours, sur la timeline de base, compte 6 062 matchs, dont 4 916 avant le holdout et 4 108 avant la fenêtre de validation. Avec 10 à 32 features. C'est petit.
Regardons min_child_weight = 20. Ce paramètre ne compte pas des lignes, il compte la
somme des hessiennes \(h_i = p_i(1 - p_i)\) dans la feuille. Or nos probabilités
tournent autour de 0.5 à 0.7, donc \(h_i\) vaut entre 0.21 et 0.25. Pour atteindre une
somme de 20, il faut donc
Chaque feuille contient au minimum 80 matchs environ. Sur 4 108 lignes
d'entraînement, cela borne à une cinquantaine le nombre de feuilles réellement
peuplables — et max_depth = 3 en autorise 8 par arbre. Autrement dit, les deux
contraintes se renforcent : chaque arbre est un très gros grain, et la finesse ne vient
que de leur accumulation.
Comparons les capacités :
| Modèle | Paramètres appris | Lignes d'entraînement |
|---|---|---|
| Logistique 32 features | 33 (32 poids + intercept) | 4 916 |
XGBoost depth=3, 300 arbres |
jusqu'à 2 400 valeurs de feuille + les coupures | 4 916 |
Limite importante — le régime de petites données
Toutes les conclusions de ce chapitre valent dans ce régime : quelques milliers de lignes, quelques dizaines de features déjà travaillées. Avec 500 000 matchs et des features brutes, le classement pourrait s'inverser, et la littérature suggère fortement qu'il s'inverserait. Ce que nous avons mesuré, c'est le comportement sur nos volumes.
L'early stopping, et un piège réel dans notre propre code
L'early_stopping_rounds = 30 signifie : continuer à ajouter des arbres tant que la
perte mesurée sur un jeu d'évaluation s'améliore, et s'arrêter après 30 arbres sans
progrès, en gardant le meilleur nombre d'arbres.
C'est une excellente idée — à condition que le jeu d'évaluation ne soit pas celui sur
lequel on rapporte le score final. Or dans vrs/predict.py, l'appel est
booster = xgb.train(params, dtrain, evals=[(dtest, "holdout")],
                    early_stopping_rounds=30, ...)
Le dtest passé en surveillance est le holdout. Le nombre d'arbres retenu est donc
choisi en regardant les données de test : c'est une fuite, faible (un seul
hyperparamètre, choisi sur un critère bruité) mais réelle, qui flatte très légèrement le
champion.
Le concours l'a corrigé : final fait l'early stopping sur la queue temporelle du jeu
d'entraînement, jamais sur le holdout — c'est explicitement noté comme « leçon stack »
dans son rapport.
Erreur fréquente
Passer son jeu de test en evals par confort, parce que c'est le tableau qu'on a
sous la main. C'est la fuite la plus banale du gradient boosting, et elle est
invisible : le code tourne, les chiffres sont beaux. Le réflexe correct est de
découper une queue de validation dans le train — chronologiquement, pour un
problème temporel comme le nôtre.
Un signe visible de l'ampleur du problème : le même champion, ré-entraîné par trois approches différentes du concours, donne un Brier holdout de 0.2318, 0.2329 et 0.2330. Un étalement de 0.0012 sur ce qui est censé être le même modèle — utile à garder en tête avant de célébrer un gain de 0.0005.
Où XGBoost a gagné
Il faut lui rendre justice : c'est lui qui a fait sortir le projet de la baseline.
| Modèle | Brier holdout | Accuracy |
|---|---|---|
| Glicko de Valve (baseline) | 0.2422 | 56.0 % |
| Champion v2 : XGBoost + Elo à marge | 0.2330 | 60.4 % |
Ce saut de 0.0092 de Brier et de 4.4 points d'accuracy est le plus gros de toute l'histoire du projet avant le concours. Il combine deux apports : de nouvelles features (l'Elo à marge, la forme, le H2H, la LAN, le repos) et un modèle capable de les combiner sans qu'on ait à spécifier comment.
Le boosting a aussi gagné à l'intérieur de la famille bayes, qui a construit des
horloges TrueSkill par joueur et les a passées à un XGBoost : Brier 0.2256, meilleure
approche du concours pendant un moment, et de loin devant le premier modèle logistique
(0.2315) qui, lui, n'avait pas ces features.
La leçon n'est pas « XGBoost est inutile ». Elle est : XGBoost était le bon outil tant que les features étaient pauvres, parce qu'il fabriquait lui-même les non-linéarités qui manquaient.
Où il a perdu
Le basculement se produit exactement au moment où les familles de features fusionnent.
Le modèle final réunit pour la première fois trois familles (horloges bayésiennes,
statistiques joueurs, données de maps) en 32 features et compare, sur la même
validation interne, trois candidats :
Candidat, final, 32 features |
Brier validation |
|---|---|
XGBoost (max_depth = 4, re-réglé) |
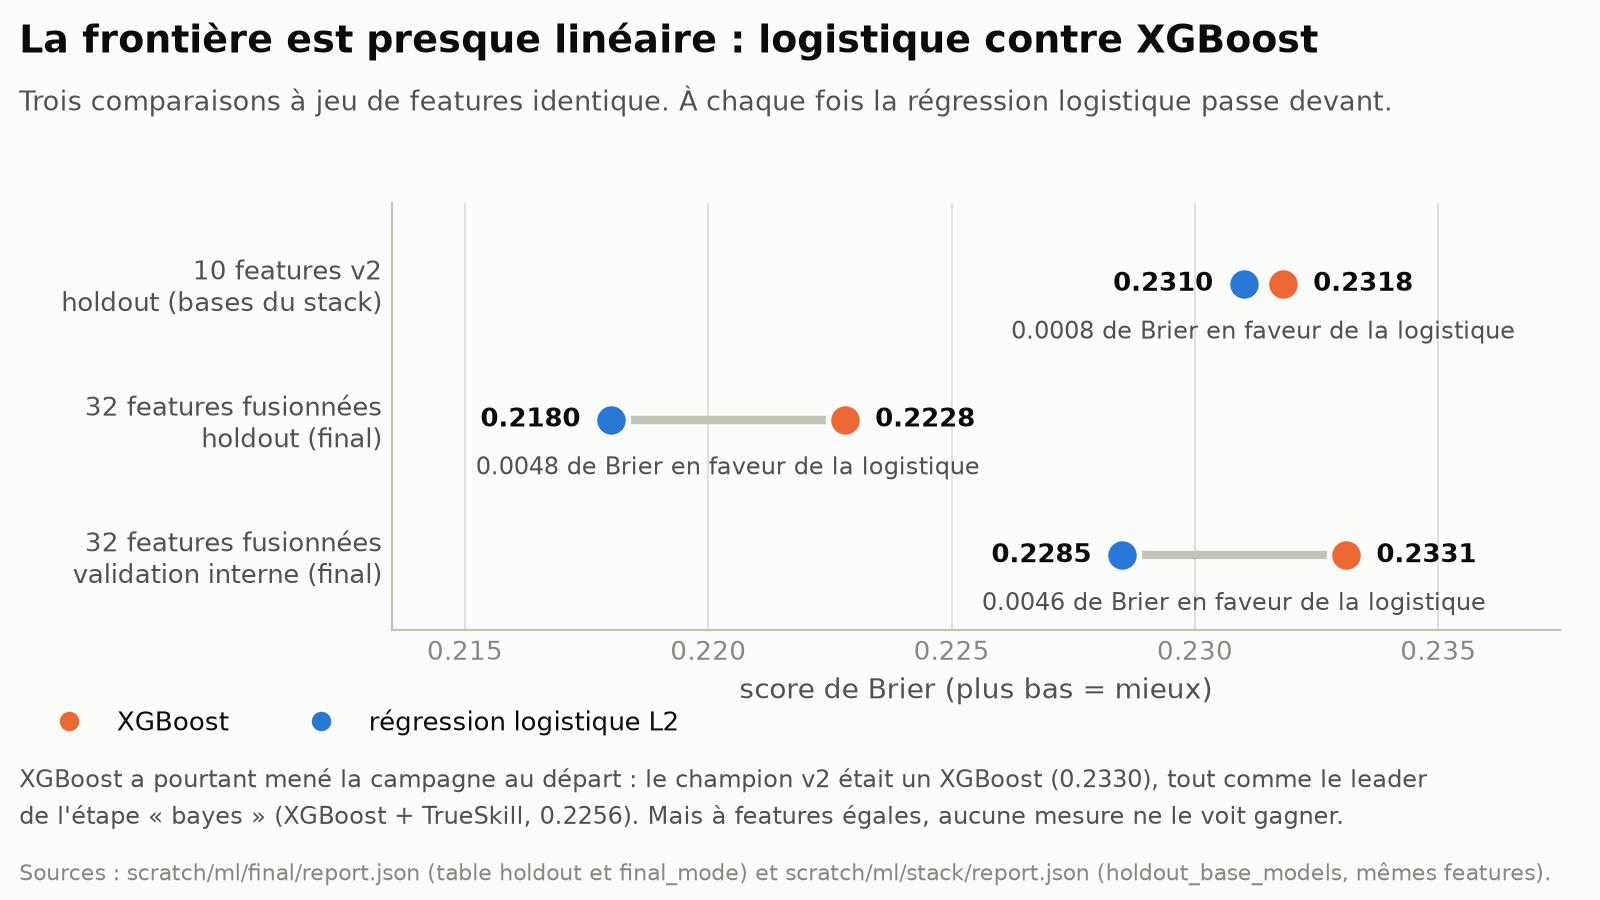
0.2331 |
| Régression logistique L2, \(C = 0.3\) | 0.2285 |
| Moyenne des deux | 0.2293 |
Le verdict est net et il s'est confirmé sur le holdout : 0.2224 pour le meilleur XGBoost,
0.2180 pour la logistique. Le modèle push a rejoué la comparaison avec 40 features
et obtenu le même ordre (XGBoost simple 0.2302, XGBoost à contraintes de monotonie
0.2307, logistique 0.2263 en validation).
Fait notable, la moyenne des deux modèles est entre les deux, plus près du meilleur : XGBoost n'apportait rien que la logistique ne sût déjà. C'est le sujet du chapitre 4.
La tentative de sauvetage : les contraintes de monotonie
push a essayé un XGBoost à contraintes de monotonie : on impose à l'arbre que la
probabilité soit croissante en ts_diff, en melo_diff, etc. C'est une façon d'injecter
dans les arbres la connaissance métier qui rend la logistique si efficace — « plus forte
veut dire plus de chances », toujours, sans exception apprise du bruit.
Résultat : 0.2307 en validation, contre 0.2302 sans contrainte et 0.2263 pour la logistique. Les contraintes n'ont pas nui, elles n'ont pas aidé non plus. L'explication la plus simple est que le problème n'était pas la monotonie mais la granularité : là où la logistique lit un écart continu, un arbre lit un escalier, et l'escalier ne peut qu'approcher la droite au prix d'une variance supplémentaire.
   Ce que la logistique lit          Ce qu'un arbre lit
   de ts_diff → logit                de ts_diff → logit

     logit │        ╱                  logit │      ┌──
           │      ╱                          │   ┌──┘
           │    ╱                            │ ──┘
           │  ╱                              │
           └────────── ts_diff               └────────── ts_diff

   Sur une relation vraiment linéaire, chaque marche est une erreur
   d'approximation qu'il faut payer en variance.
La figure frontiere-lineaire.png illustre
cette comparaison à features égales.
Le tableau récapitulatif
| Étape de la campagne | Features | Meilleur modèle | Brier holdout |
|---|---|---|---|
| v1 | — | Glicko de Valve | 0.2422 |
| v2 | 10 brutes | XGBoost | 0.2330 |
bayes |
+ TrueSkill par joueur | XGBoost | 0.2256 |
final |
32, trois familles | logistique | 0.2180 |
push → segmodel |
40 → 54 | logistique | 0.2172 → 0.2041 |
À retenir
L'essentiel du chapitre
- Le boosting construit une somme d'arbres, chacun entraîné sur l'erreur courante \(p_i - y_i\), ajoutée avec un facteur de prudence \(\eta\).
- XGBoost donne une formule fermée pour la valeur des feuilles, \(w^\star = -G/(H + \lambda)\), qui rétrécit d'autant plus que la feuille est peu peuplée.
- Nos réglages sont petits parce que le jeu est petit :
min_child_weight = 20impose environ 80 matchs par feuille sur 4 108 lignes d'entraînement, etmax_depth = 3limite à 8 feuilles par arbre. - L'early stopping doit se faire sur une queue de validation issue du train. Notre code de production le fait sur le holdout — fuite faible mais documentée.
- Il a gagné tant que les features étaient pauvres (0.2422 → 0.2330 → 0.2256), et perdu dès qu'elles sont devenues riches (0.2331 contre 0.2285 à features égales).
Le chapitre suivant construit le modèle qui a finalement gagné : segments et blends, où l'on découvre que tous les matchs ne se prédisent pas de la même façon.