Le démarrage à froid : le plus gros gain de la campagne
Voici le chapitre qui relativise les cinq précédents.
Nous avons passé beaucoup d'énergie à comparer des formules : Elo contre Glicko, \(K\) contre \(K\), marge de série contre marge de manches, volatilité dynamique contre \(RD\) figé, joueurs contre équipes. Les gains mesurés vont de 0,001 à 0,007 de Brier.
Puis nous avons changé une chose qui n'est pas une formule du tout — l'état de départ des horloges — et gagné 0,0072 de Brier d'un coup, plus que n'importe quelle famille de features de tout le concours.
C'est le résultat le plus important de cette partie, et probablement du cours entier.
Le problème : tout le monde part de 1500
Regardez le code de production du modèle de victoire :
def rating(self, team_id):
    return self.glicko.setdefault(team_id, model.GlickoTeam(1500.0))
La première fois qu'une équipe apparaît dans le balayage chronologique, elle reçoit 1500. C'est vrai de toutes nos horloges, sans exception :
| horloge | valeur de départ | signification |
|---|---|---|
| Glicko de Valve | \(r = 1500\), \(RD = 75\) | « équipe moyenne, et j'en suis sûr » |
| Elo à marge | \(r = 1500\) | « équipe moyenne » |
| Glicko-2 | \(\mu = 0\), \(\phi = \phi_{\max}\) | « équipe moyenne, et je n'en sais rien » |
| TrueSkill | \(\mu = 25\), \(\sigma = 25/3\) | idem, par joueur |
| pi-ratings | \(\pi = 0\) | « écart de manches nul » |
Ce n'est pas un bug : c'est le seul choix raisonnable en l'absence d'information. Mais c'est un prior massivement faux pour à peu près toutes les équipes du pool. Une organisation du top 5 mondial ne vaut pas 1500. Une équipe de qualification régionale non plus. Et l'horloge met du temps à s'en apercevoir.
Limite importante
Le Glicko de Valve cumule ici les deux erreurs : il part d'un prior faux et il affirme en connaître la précision, puisque son \(RD\) vaut 75 dès le premier match. Il annonce donc « équipe moyenne, avec la même confiance qu'une équipe suivie depuis cent matchs ». Glicko-2 et TrueSkill, eux, partent au moins avec une incertitude maximale : ils savent qu'ils ne savent pas.
Combien de matchs pour se réchauffer ?
C'est une question à laquelle on peut répondre exactement.
Prenons une équipe dont la force vraie correspond à 1800, qui joue contre un pool calibré à 1500, avec \(K = 30\). Elle gagne donc en moyenne 84,9 % de ses matchs. À chaque match, son rating avance de \(K\) fois l'écart entre sa probabilité de victoire réelle et celle que l'horloge attend. Voici la trajectoire moyenne :
| matchs joués | rating | part du chemin parcouru |
|---|---|---|
| 1 | 1510,5 | 3,5 % |
| 5 | 1548,0 | 16,0 % |
| 10 | 1586,7 | 28,9 % |
| 20 | 1643,9 | 48,0 % |
| 30 | 1683,1 | 61,0 % |
| 50 | 1731,5 | 77,2 % |
| 100 | 1779,6 | 93,2 % |
| 200 | 1797,9 | 99,3 % |
La convergence est géométrique, avec une constante de temps d'environ 23 matchs. Il faut une vingtaine de matchs pour combler la moitié de l'écart, et plus de cent pour être vraiment arrivé.
Intuition
La lenteur vient d'un effet de ciseaux. Loin de l'équilibre, la surprise \(y - E\) est grande, donc le pas est grand — mais la sigmoïde est plate aux extrêmes, donc il faut beaucoup de points de rating pour changer \(E\) de peu. Près de l'équilibre, la sigmoïde est pentue mais la surprise est petite. Dans les deux régimes, l'approche est lente.
Le chiffre qui fait mal
Et maintenant, la question qui tue : combien de matchs les équipes de notre pool jouent-elles réellement dans la fenêtre de six mois ?
Mesure directe sur les 6 062 matchs du balayage (fichier
scratch/ml/squeeze/squeeze_features.pkl) :
| grandeur | valeur |
|---|---|
| équipes distinctes | 656 |
| matchs par équipe, moyenne | 18,5 |
| matchs par équipe, médiane | 7 |
| équipes à 5 matchs ou moins | 298, soit 45 % |
| équipes à 10 matchs ou moins | 366, soit 56 % |
| équipes à 20 matchs ou moins | 435, soit 66 % |
La médiane est à sept matchs. Croisez ce chiffre avec le tableau de convergence : sept matchs, c'est environ 22 % du chemin parcouru. Pour la moitié des équipes de notre pool, l'horloge n'est jamais sortie du voisinage de 1500.
Ce n'est pas un problème marginal réservé aux figurants. Comptons les matchs plutôt que les équipes :
1 895 des 6 062 matchs — soit 31 % — opposent au moins une équipe qui joue 20 matchs ou moins dans toute la fenêtre.
Presque un match sur trois est prédit avec au moins une horloge non convergée. Le diagnostic du journal de la campagne — « la faiblesse n°1 était bien le démarrage à froid » — n'était pas une intuition : c'est ce que ce tableau dit.
   distribution des matchs par équipe sur 6 mois (656 équipes)

   ≤5    ████████████████████████████████████████████  298   (45 %)
   6-10  ██████████                                     68   (10 %)
   11-20 ██████████                                     69   (11 %)
   21-30 ████████                                       53    (8 %)
   31-50 █████████████                                  90   (14 %)
   >50   ███████████                                    78   (12 %)
                                     médiane = 7 matchs ↑
Erreur fréquente
Raisonner sur la moyenne (18,5 matchs) et conclure « ça devrait aller ». La distribution est très asymétrique : une poignée d'équipes tier 1 joue 80 à 120 matchs et tire la moyenne vers le haut, pendant que la moitié du pool en joue sept. Sur des distributions à queue lourde, la médiane raconte l'histoire, la moyenne la cache.
Ce que Valve fait, et que nous ne faisions pas
Ironie de l'affaire : le moteur de Valve, que nous avons critiqué pendant cinq chapitres, a une réponse au démarrage à froid — et elle est plutôt bonne.
Valve ne part pas de 1500. Il calcule d'abord un seeding à partir de quatre facteurs de mérite (gains en tournoi, adversaires distincts battus, réseau d'adversaires, participation LAN), puis remappe ce score sur l'intervalle \([400, 2000]\) :
MIN_SEEDED_RANK = 400
MAX_SEEDED_RANK = 2000
team.rank_value = remap_value_clamped(
    team.seed_value, min_seed, max_seed, MIN_SEEDED_RANK, MAX_SEEDED_RANK
)
team.glicko = GlickoTeam(team.rank_value)
L'horloge Glicko ne démarre donc pas au centre : elle démarre là où le palmarès de l'équipe la place, et elle ne fait que corriger ce placement match après match. C'est une réponse structurelle au démarrage à froid, et elle explique en partie pourquoi la baseline de Valve tient si bien face à nos horloges plates.
Nos horloges de prédiction, elles, n'avaient rien de tel. Elles partaient toutes de 1500, plat. C'est l'écart qu'il a fallu combler — par une autre voie.
Le réchauffage, première voie : douze mois natifs
L'idée est simple au point d'être vexante : au lieu de commencer le balayage chronologique au début de la fenêtre de six mois, le commencer six mois plus tôt. Les matchs supplémentaires ne servent pas à entraîner le modèle ; ils servent uniquement à faire tourner les horloges pour qu'elles arrivent chaudes au début de la période d'intérêt.
   avant (froid)
                          ┌──── fenêtre native 6 mois ────┐
   horloges à 1500  ─────►│ balayage + entraînement       │──► holdout
                          2026-02                    2026-07

   après (réchauffé)
        ┌── réchauffage 6 mois ──┬──── fenêtre native ────┐
        │ balayage SEUL          │ balayage + entraînement│──► holdout
        2025-08              2026-02                 2026-07
La distinction entre « faire tourner les horloges » et « entraîner le modèle » est
essentielle, et le protocole de la campagne assault/ l'isole proprement. Le
build_dataset.py produit deux jeux de features pour les mêmes matchs :
feats (états réchauffés sur 12 mois) et feats_cold (états rejoués depuis 6 mois
seulement). Même modèle, mêmes lignes d'entraînement, mêmes hyperparamètres : seule
change la température des horloges.
La mesure
Holdout de 1 146 matchs, tableau pré-enregistré, une seule passe :
| configuration | accuracy | Brier | log-loss |
|---|---|---|---|
squeeze reproduit, froid, train 6 mois |
64,6 % | 0.2153 | 0.6191 |
| états réchauffés, train 6 mois | 66,2 % | 0.2081 | 0.6007 |
| + train étendu à 12 mois | 66,3 % | 0.2078 | 0.6002 |
Et voici le détail qui rend le résultat concluant plutôt que simplement bon : étendre le jeu d'entraînement de 4 916 à 10 287 lignes n'apporte que 0,0003 de plus. Le gain ne vient donc pas de « plus de données pour apprendre », il vient uniquement de la température des horloges. C'est exactement l'expérience qu'il fallait faire, et elle a été faite dans le bon ordre.
À retenir
Réchauffer les horloges sur six mois supplémentaires — sans changer une seule ligne de formule, sans ajouter une seule feature, sans agrandir le jeu d'entraînement — vaut −0,0072 de Brier et +1,6 point d'accuracy. C'est le plus gros gain unitaire de toute la campagne.
Pour situer : la meilleure amélioration de formule des chapitres précédents (TrueSkill injecté dans le modèle) valait 0,0074, et elle avait demandé une horloge bayésienne complète, une bibliothèque externe, une grille d'hyperparamètres et un changement d'objet suivi. Le réchauffage a demandé de reculer une date.
Le réchauffage, deuxième voie : 40 023 matchs bo3.gg
Six mois de plus, c'est bien. Mais notre cache HLTV a lui-même une profondeur limitée, et la même logique pousse à aller chercher de l'historique ailleurs.
Le site bo3.gg publie des résultats de matchs CS2 remontant bien plus loin. La
collecte industrialisée dans harvest/ a rapporté :
| gisement | volume | période |
|---|---|---|
bo3_history.pkl — résultats de matchs |
40 023 | 2024-01 → 2026-08 |
| maps et scores associés | 77 890 | idem |
| matchs avec les maps détaillées | 39 375 | idem |
Ces 40 023 matchs ne rejoignent pas le jeu d'entraînement — ils ne portent ni nos identifiants d'équipe, ni nos rosters, ni nos poids d'event. Ils servent exclusivement à faire tourner les horloges avant le début de notre fenêtre.
Trois horloges sont réchauffées de cette façon, par nom d'équipe normalisé :
def bo3_warm_feats(recs):
    """Horloges réchauffées depuis 2024-01 sur bo3_history, par nom normalisé.
    Lues strictement avant t (les matchs bo3 simultanés ne sont pas appliqués)."""
wmelo_diff: l'Elo à marge du chapitre 3, réchauffé depuis janvier 2024 ;wglicko_diff: le Glicko de Valve, idem ;wpi_diff: les pi-ratings du chapitre 5, alimentés par les scores de manches map par map ;wn_min: \(\ln(1 + \min(n_A, n_B))\), le nombre de matchs bo3.gg vus pour la moins observée des deux équipes. C'est une feature de confiance : elle dit au modèle à quel point les trois précédentes sont fiables.
Le point technique le plus délicat est l'intégrité temporelle. Les horloges bo3 sont
avancées jusqu'à la date du match courant, strictement avant (bo3[j][0] < r["t"]),
et jamais au-delà. Un match bo3.gg joué le même jour n'est pas appliqué.
La mesure
| configuration | accuracy | Brier | log-loss |
|---|---|---|---|
| réchauffé natif + train 12 mois | 66,3 % | 0.2078 | 0.6002 |
| + rounds-éco seul | 66,7 % | 0.2064 | 0.5970 |
| + réchauffage bo3 seul | 66,4 % | 0.2063 | 0.5974 |
assault — combinaison choisie en validation |
66,8 % | 0.2054 | 0.5954 |
Le réchauffage externe apporte 0,0015 de plus, à peu près à égalité avec la famille des features économiques (pistolets, anti-éco, clutchs). En validation interne, il faisait mieux encore — 0.2219 sans, 0.2184 avec, soit 0,0035 — mais le holdout est plus sévère. C'est un écart normal entre validation et test ; on rapporte les deux et on croit le second.
Une seule des quatre features de réchauffage externe a survécu à la sélection
gloutonne : wmelo_diff, l'Elo à marge réchauffé. Le Glicko réchauffé et les
pi-ratings réchauffés n'apportaient rien en plus. Retour du chapitre 3 : quand on
n'a droit qu'à une horloge, c'est l'Elo à marge qu'il faut prendre.
Limite importante
L'appariement avec bo3.gg se fait par nom d'équipe normalisé, pas par
identifiant. Deux organisations homonymes, une équipe qui change de nom, une
académie qui porte le nom du club — chacun de ces cas produit un réchauffage
faux. Le rapport de collecte documente 4 302 vainqueurs concordants sur 4 304
matchs appariés (les deux discordants sont explicitement exclus), et un
appariement global à 85 %. C'est propre, mais c'est un point de fragilité réel
que wn_min ne suffit pas à neutraliser.
La décomposition complète
Voici, dans l'ordre chronologique de la campagne, la cascade complète depuis la baseline de Valve jusqu'au leader final. La figure décomposition des gains la met en forme.
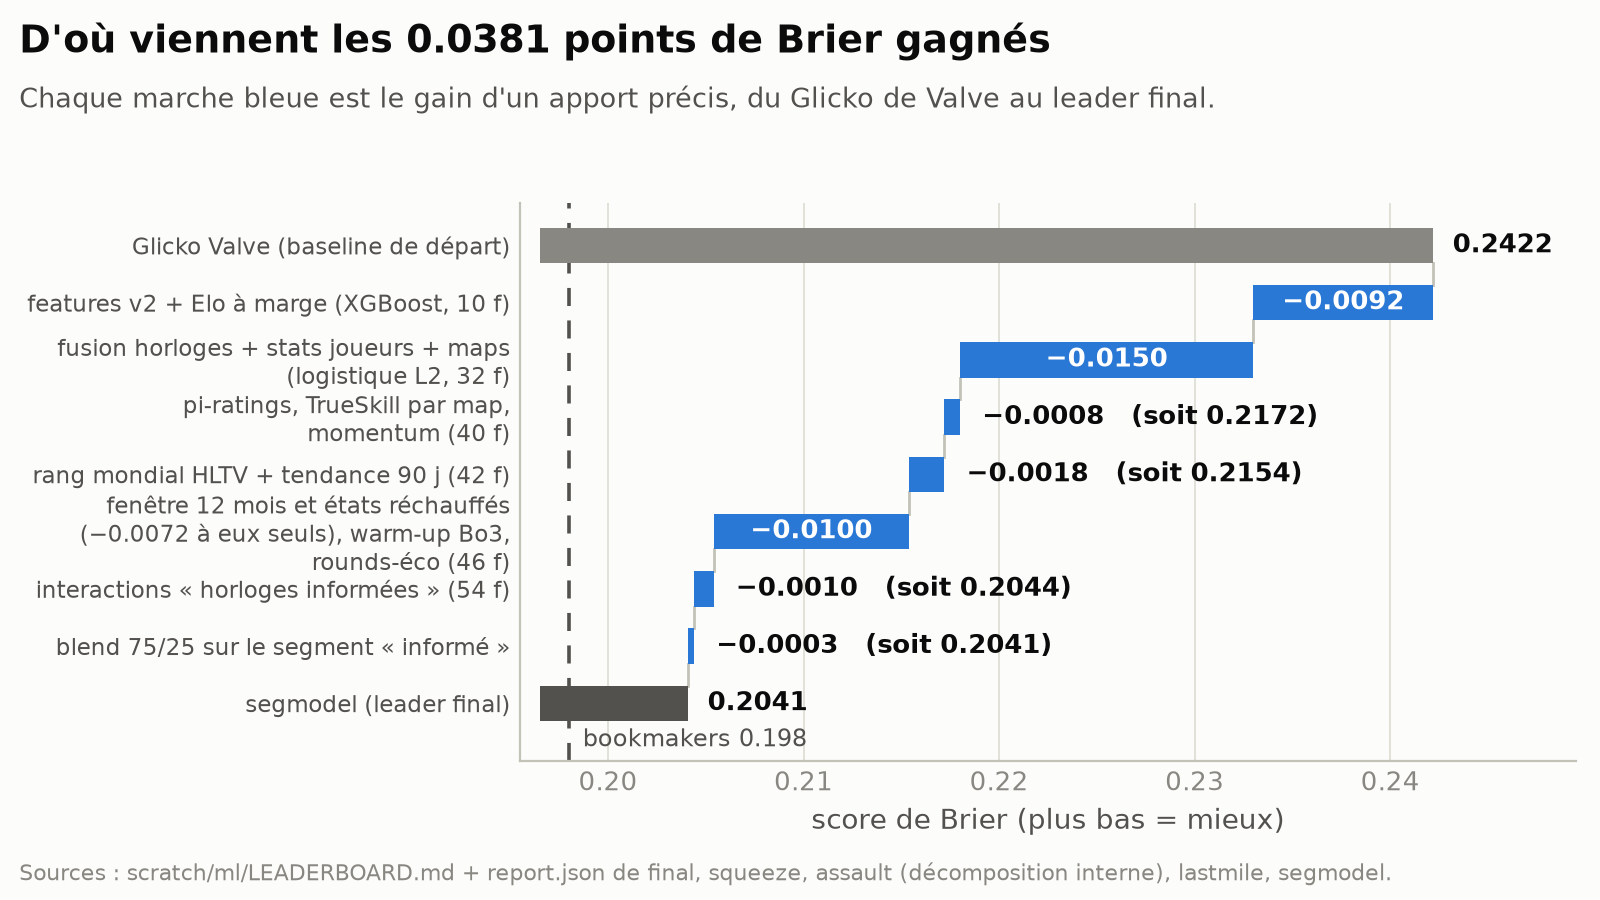
| étape | ce qui est ajouté | Brier | gain |
|---|---|---|---|
| baseline Valve | Glicko \(RD\) figé, prédicteur pur | 0.2422 | — |
| champion v2 | XGBoost 10 features, dont l'Elo à marge | 0.2330 | −0.0092 |
bayes |
TrueSkill par joueur | 0.2256 | −0.0074 |
push |
pi-ratings, TrueSkill par map, momentum | 0.2172 | −0.0084 |
squeeze |
rang mondial HLTV daté | 0.2154 | −0.0018 |
| réchauffage natif | 12 mois d'historique, mêmes formules | 0.2081 | −0.0072 |
assault |
+ éco + réchauffage bo3 | 0.2054 | −0.0027 |
segmodel |
segmentation « informé » + blend | 0.2041 | −0.0013 |
Le réchauffage figure au deuxième rang des gains unitaires, derrière le champion v2 (qui cumulait dix features) et à égalité avec TrueSkill et les pi-ratings — sauf qu'il n'a rien coûté en complexité de modèle. Zéro feature ajoutée, zéro paramètre supplémentaire.
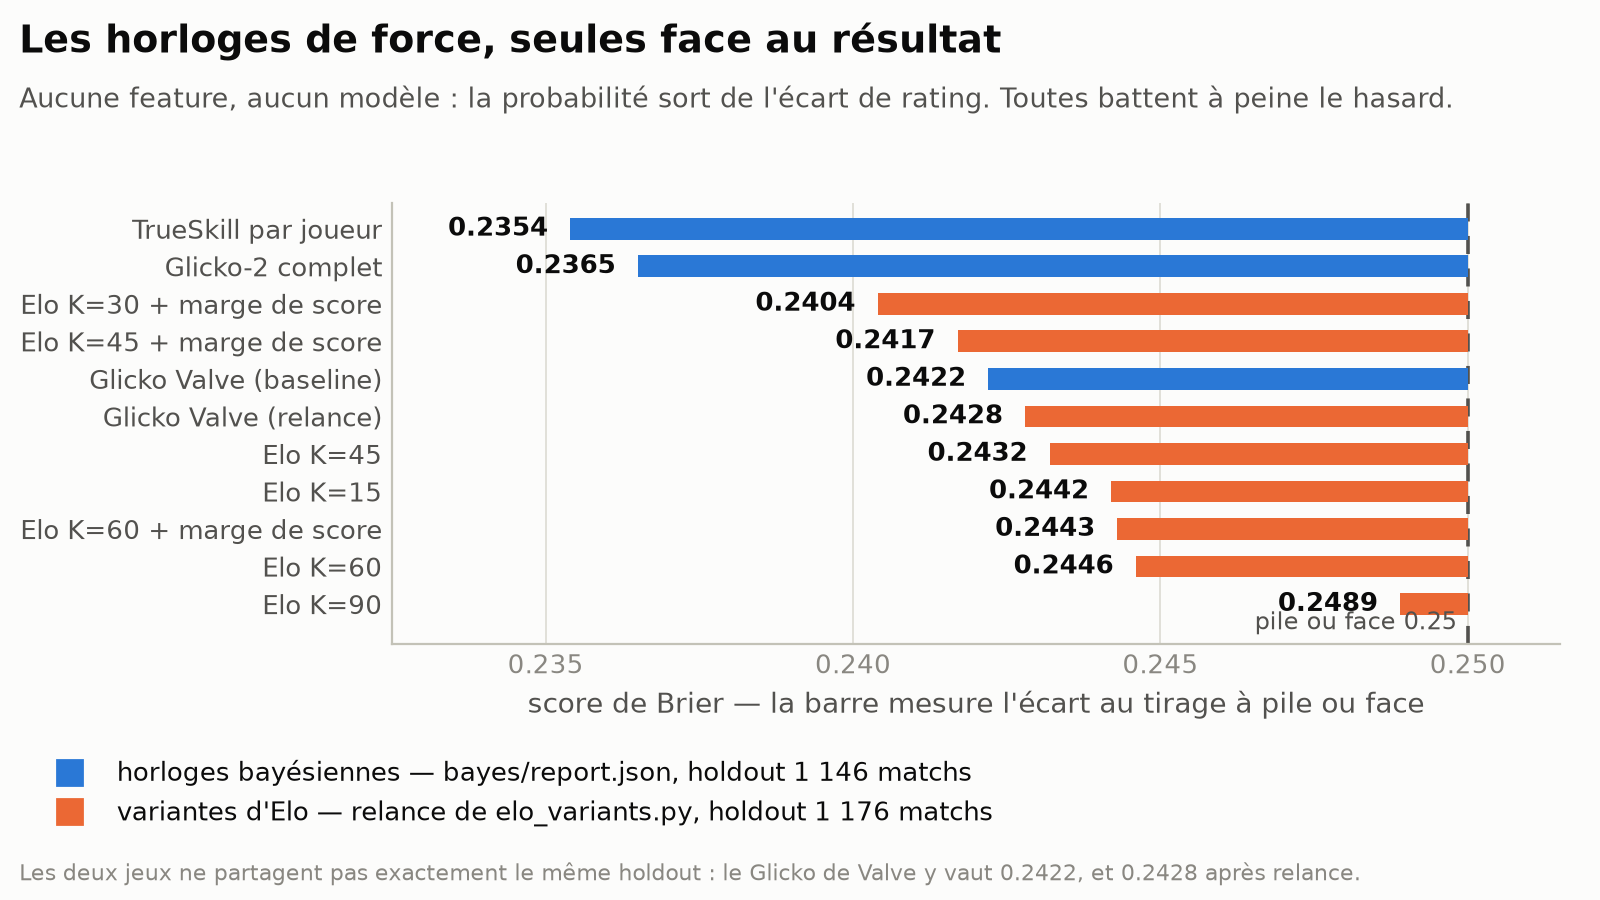
Pour la comparaison des horloges elles-mêmes, en prédicteur pur, voir la figure horloges comparées.
Pourquoi c'est la faiblesse numéro un
Trois raisons, dans l'ordre de gravité.
Une horloge froide ne se trompe pas au hasard : elle se trompe dans un sens connu. Toutes les équipes non convergées sont tirées vers 1500, c'est-à-dire vers le centre. Les forts sont sous-estimés, les faibles surestimés, et l'horloge annonce systématiquement des matchs plus serrés qu'ils ne le sont. C'est un biais, pas du bruit — et un biais ne s'annule pas en moyennant sur 1 146 matchs.
L'erreur se propage à toutes les features dérivées. glicko_diff, melo_diff,
ts_diff, pi_diff_a : toutes sont des différences d'horloges. Si les deux horloges
sont froides, la différence est fausse, et le modèle apprend à faire confiance à une
variable bruitée. Pire encore, il apprend un coefficient atténué pour compenser —
ce qui dégrade aussi ses prédictions sur les matchs où les horloges étaient chaudes.
Ce sont les matchs les plus prévisibles qui sont ratés. Un match entre une équipe tier 1 établie et un qualifié régional obscur devrait être le match le plus facile du lot. Il est justement celui où l'horloge de l'outsider est froide, donc où la prédiction est le plus tirée vers 0,5. On perd de l'argent, si l'on peut dire, sur les matchs les plus faciles.
C'est cohérent avec la décomposition par segments du modèle final : le segment « horloges froides » atteint 0.1591 de Brier et 75,0 % d'accuracy une fois le problème corrigé, ce qui en fait l'un des segments les plus prévisibles du holdout. Le potentiel était là depuis le début ; il était juste inaccessible tant que les horloges partaient de 1500.
Ce qui reste à faire
Le réchauffage a été poussé aussi loin que les données disponibles le permettaient, mais deux angles n'ont pas été traités.
Le réchauffage par joueur. TrueSkill initialise tout nouveau joueur à
\(\mu = 25\) — le prior neutre. Les pages hltv.org/player/<id>, identifiées mais
jamais collectées, porteraient l'historique et le rating individuel de chaque joueur.
Un joueur qui monte de tier 2 en tier 1 arriverait avec son vrai niveau au lieu de la
moyenne. C'est exactement le même problème que celui de ce chapitre, un cran plus
bas.
Le seeding par le mérite, comme Valve. Rien n'empêcherait d'initialiser nos
horloges de prédiction avec le rank_value_seed du moteur VRS — qui est déjà calculé
par notre propre port du modèle de Valve — au lieu de 1500 plat. L'idée n'a pas été
essayée. Elle est gratuite en collecte et coûte quelques lignes.
Erreur fréquente
Chercher le gain dans la sophistication du modèle avant d'avoir vérifié la qualité de son état initial. La campagne a exploré Glicko-2, TrueSkill, factor graphs, XGBoost monotone, GBDT→LR, modèles map-level recomposés, labels multinomiaux — et le gain le plus net est venu d'un décalage de six mois sur la date de début du balayage. L'ordre inverse aurait fait gagner des semaines.
Résumé de la partie
Six chapitres, cinq horloges, une vingtaine de mesures. Si vous ne deviez retenir qu'un seul encadré de toute cette partie, ce serait celui-ci — parce qu'il porte le gain le plus important et qu'il ne parle pas de mathématiques.
À retenir
Toutes nos horloges partaient de 1500. La convergence d'un Elo de \(K=30\) demande une vingtaine de matchs pour la moitié du chemin et plus de cent pour arriver ; or la médiane de notre pool est de 7 matchs sur six mois, et 31 % des matchs opposent au moins une équipe à 20 matchs ou moins. Réchauffer les horloges sur douze mois natifs vaut −0,0072 de Brier à formules et features constantes ; y ajouter 40 023 matchs bo3.gg 2024-2026 en apporte 0,0015 de plus. C'est le plus gros gain unitaire de la campagne — et il ne concerne aucune formule.
Les six chapitres de cette partie se résument en une phrase : une horloge de force vaut par sa formule, mais elle vaut davantage encore par la longueur de sa mémoire. Le chapitre 5 le disait déjà avec le rang HLTV, qui perçait notre fenêtre de six mois. Celui-ci le dit avec nos propres horloges.
Retour à l'introduction de la partie, ou au sommaire du cours.