Le cache KV en FP4 — les 890 octets, vérifiés
Ce chapitre rassemble les résultats des trois précédents en un seul calcul : d'où viennent exactement les 890 octets par jeton annoncés par DeepSeek.
Les ingrédients
Le cache global contient deux choses, et seulement deux :
- le cache principal (main KV) — le latent compressé de 512 canaux qui sert à l'attention ;
- les clés d'indexeur (indexer K) — le vecteur de 128 canaux utilisé pour scorer les positions.
Les requêtes ne sont pas mises en cache : elles sont recalculées à chaque jeton. Le cache de fenêtre glissante n'appartient pas au cache global : il est borné par requête, indépendamment de la longueur du contexte.
Le coût d'une entrée
Cache principal
512 canaux, format E2M1, une échelle E4M3 tous les 16 canaux :
soit 288 octets par entrée : 256 octets de données et 32 octets d'échelles.
Clés d'indexeur
128 canaux, format E2M1, une échelle E8M0 tous les 32 canaux — le MXFP4 standard :
soit 68 octets par entrée : 64 octets de données et 4 octets d'échelles.
D'où viennent ces deux réglages
Ils ne figurent pas dans config.json. Ils sont lisibles dans
l'implémentation d'inférence publiée par DeepSeek, inference/model.py :
# Compressed KV uses groups of 16 with E4M3 scales; the indexer uses 32 with E8M0.
fp4_act_quant(latent, 16, True, scale_dtype=torch.float8_e4m3fn)
Sans cette ligne, le calcul ne tombe pas juste : avec un bloc de 32 partout, on obtiendrait 880 octets ; en ignorant les échelles, 832.
Le compte par couche
Une couche de ratio \(m\) ne stocke qu'une entrée pour \(m\) jetons. Son coût amorti par jeton est donc divisé par \(m\).
| Couche | Zone | Ratio | Cache principal | Clés d'indexeur | Total |
|---|---|---|---|---|---|
| 2 | encodeur | 2 | 144,0 o | 34,0 o | 178,0 o |
| 8 | encodeur | 2 | 144,0 o | 34,0 o | 178,0 o |
| 14 | encodeur | 2 | 144,0 o | 34,0 o | 178,0 o |
| 20 | décodeur | 1 | 288,0 o | 68,0 o | 356,0 o |
| Total | 720,0 o | 170,0 o | 890,0 o |
890,0 octets par jeton, exactement le chiffre annoncé.
Ce que cette vérification établit
Le fait que le calcul tombe au dixième d'octet près confirme trois choses qui ne sont écrites nulle part explicitement :
- seules les quatre couches sources contribuent au cache global — les 36 autres ne stockent rien ;
- le cache global comprend bien le cache principal et les clés d'indexeur, et rien d'autre ;
- les deux formats FP4 distincts sont bien ceux du code d'inférence, et l'échelle par bloc est bien comptée dans le chiffre annoncé.
Le script complet est en analyse critique.
Ce que cela donne aux échelles réelles
| Longueur de contexte | Cache global |
|---|---|
| 4 096 jetons | 3,5 Mio |
| 128 000 jetons | 109 Mio |
| 1 048 576 jetons | 0,87 Gio |
Un contexte d'un million de jetons tient dans moins d'un gibioctet. À titre de comparaison, le même contexte sur DeepSeek-V1 67B — architecture de 2023, GQA à 8 têtes, cache en BF16 — occuperait 372 Gio.
Le facteur 437 contre DeepSeek-V1
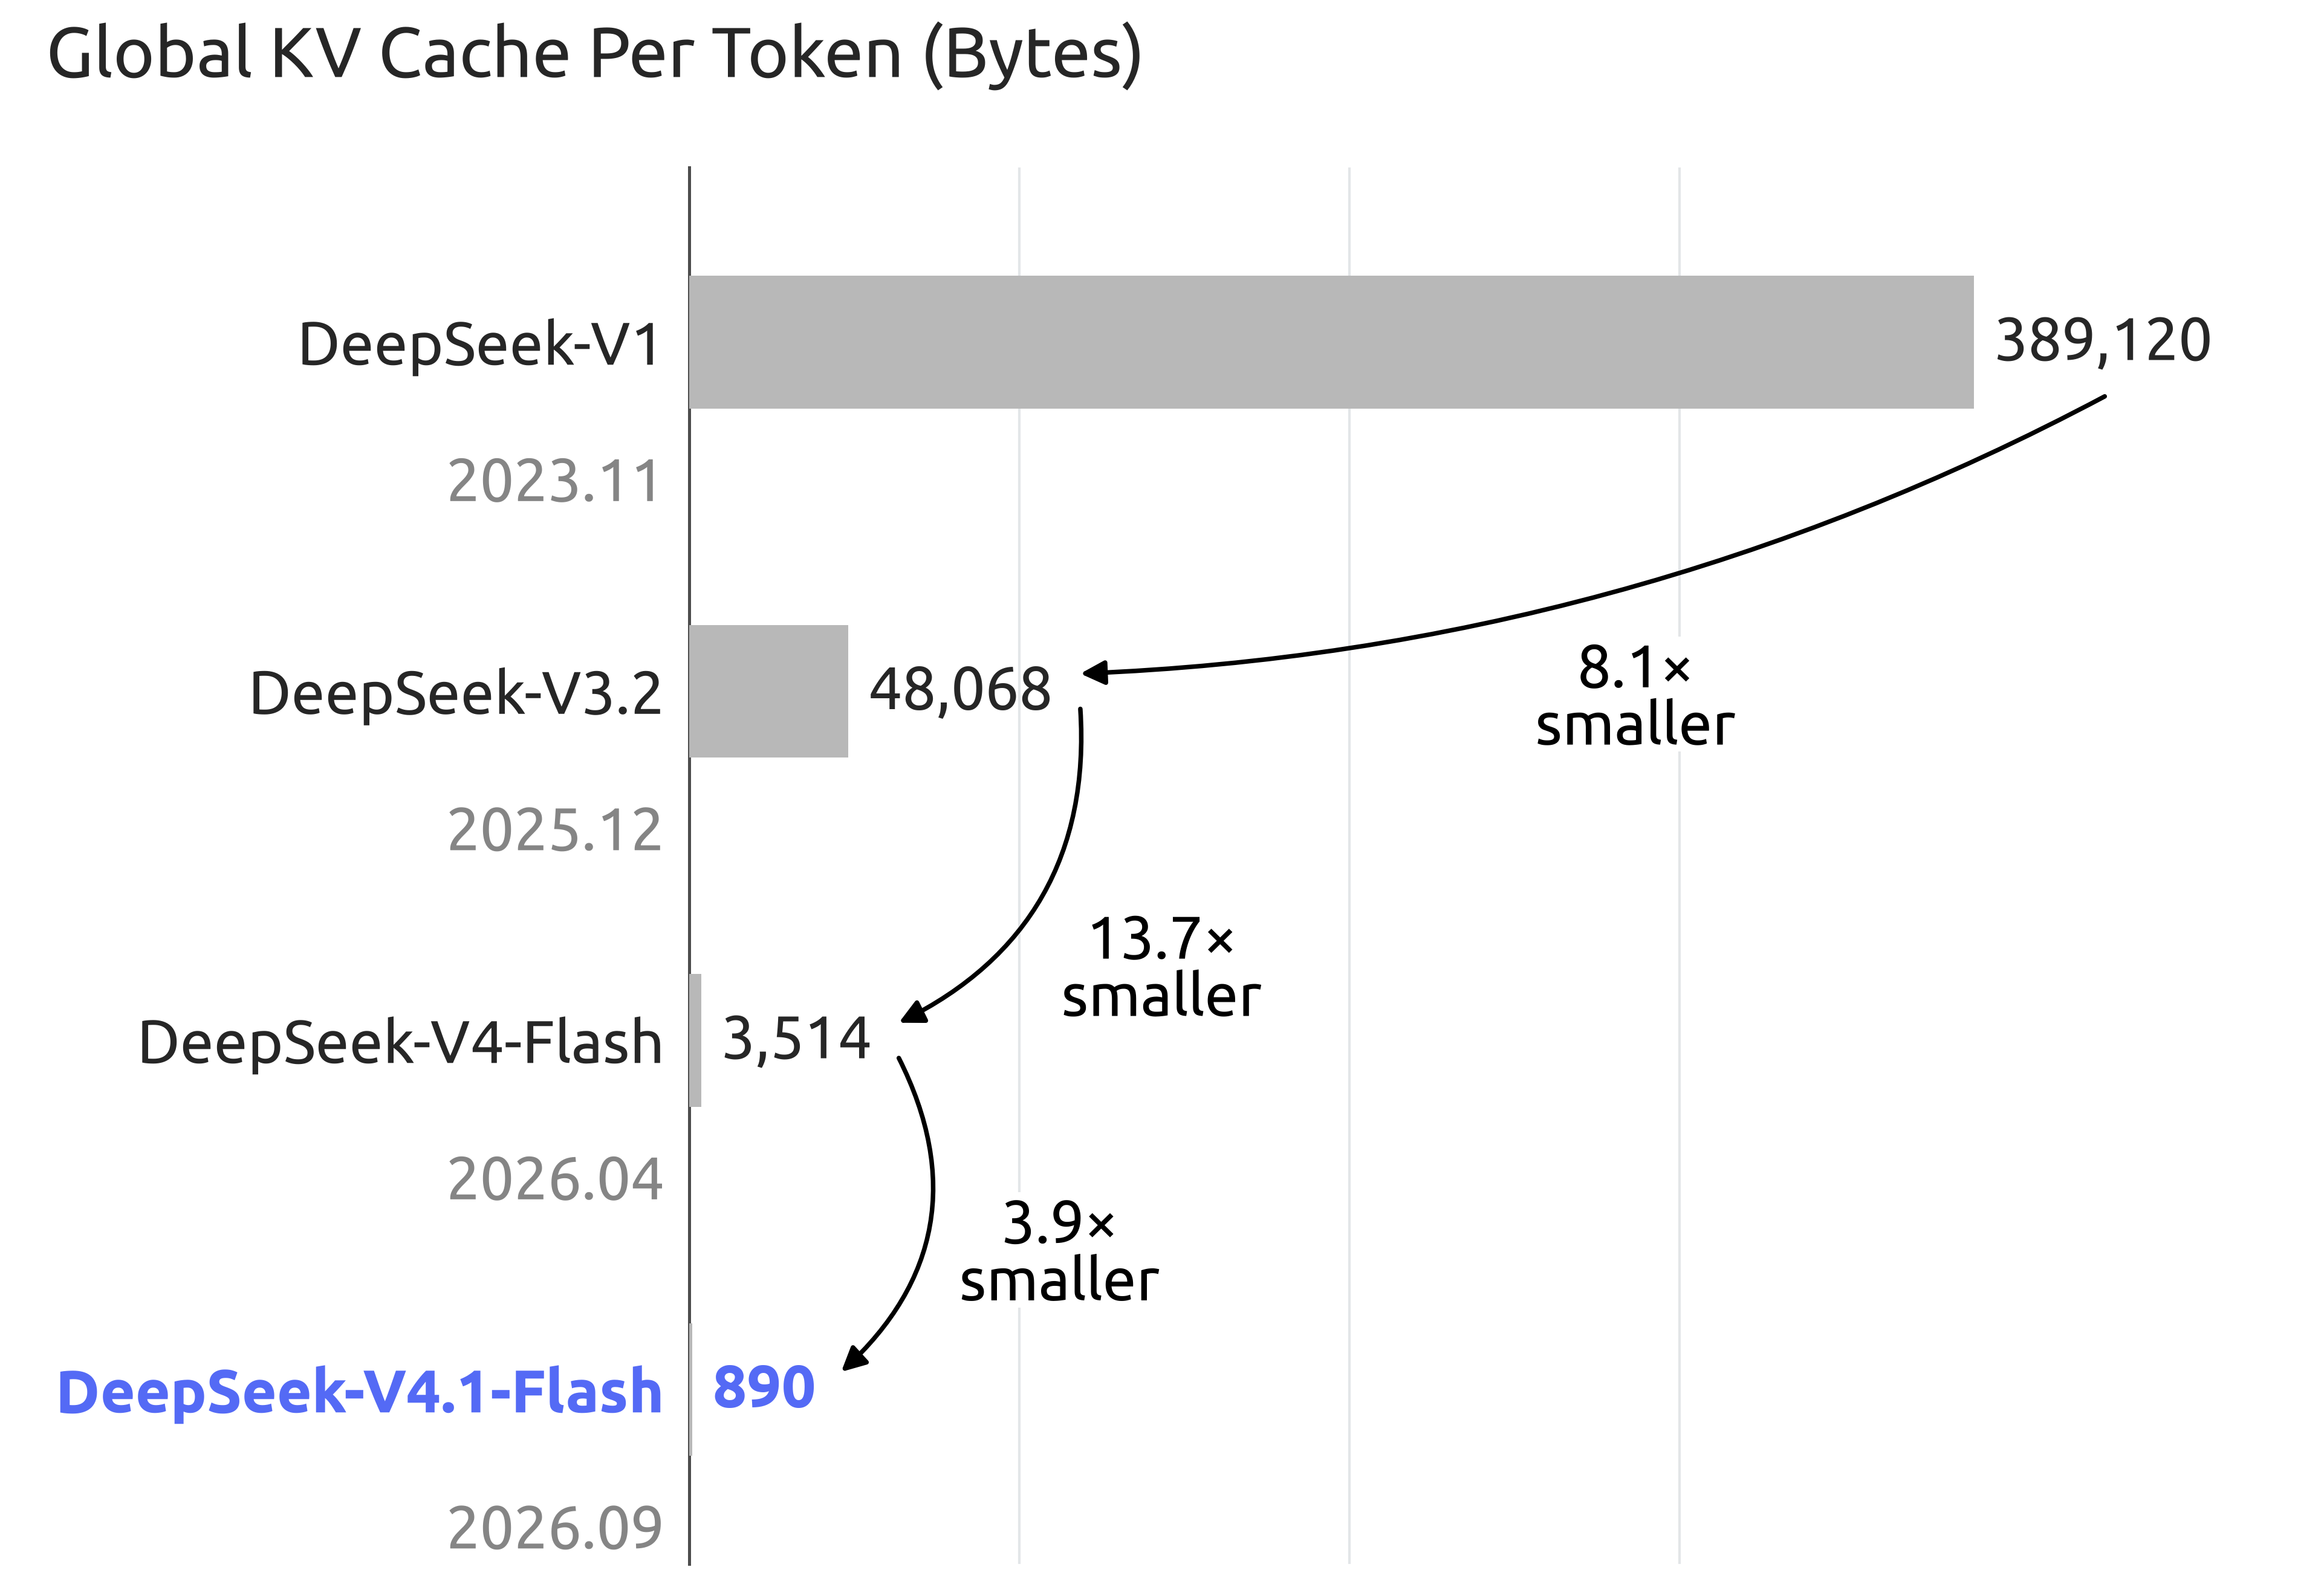
Figure 1(b) du rapport technique de DeepSeek. Chaque barre représente une génération, avec sa date de publication : DeepSeek-V1 (novembre 2023) à 389 120 octets par jeton, V3.2 (décembre 2025) à 48 068, V4-Flash (avril 2026) à 3 514, V4.1-Flash (septembre 2026) à 890. Les facteurs indiqués entre générations successives sont 8,1× puis 13,7× puis 3,9×. Source : DeepSeek-AI, 2026.
La figure ne nomme pas le modèle exact de première génération — le calcul ci-dessous l'identifie. Elle ne dit rien du cache de fenêtre glissante ni du cache persistant, qui obéissent à d'autres règles, ni de la mémoire nécessaire aux poids, qui a augmenté sur la même période.
La figure annonce 389 120 octets par jeton pour DeepSeek-V1, sans préciser
de quel modèle il s'agit. Le calcul, à partir du config.json public de
deepseek-llm-67b-base — 95 couches, 8 têtes clé-valeur, dimension de tête 128,
cache BF16 :
Le chiffre de la figure est retrouvé exactement. Cela identifie son modèle
de référence : c'est bien deepseek-llm-67b, et non un autre membre de la
première génération. Le rapport de 437,2 est conforme aux « approximativement
437× » du texte.
Le facteur contre DeepSeek-V4-Flash
La même figure donne 3 514 octets par jeton pour DeepSeek-V4-Flash, soit :
que la figure arrondit à 3,9× — un peu moins que le « environ 1/4 » du texte, mais l'écart est mineur.
Ce chiffre-là, contrairement au précédent, n'est pas reconstructible avec
certitude. La composition du cache de V4-Flash n'est pas entièrement
documentée. En reconstruisant depuis son config.json public — 43 couches,
ratios alternés 4 et 128, cache principal en FP8 avec échelle par bloc de 16,
clés d'indexeur en FP4 — on obtient 3 309 octets par jeton, soit 5,8 % en
dessous de la valeur publiée.
L'écart est faible mais réel, et deux hypothèses non vérifiables peuvent l'expliquer : le format exact des échelles du cache FP8 de V4, et la présence d'un indexeur dans les couches HCA de ratio 128, que la reconstruction suppose. Ce rapport classe donc ce facteur comme revendiqué et cohérent, contrairement aux 890 octets et au chiffre de V1, qui sont vérifiés exactement.
La contrepartie : la fenêtre glissante
Ces 890 octets ne comptent pas le cache de fenêtre glissante, que chaque couche maintient pour son compte :
en FP8. C'est constant : à un million de jetons, il représente 0,3 % du cache global. Mais en conversation à tours courts, où le contexte est modeste, c'est lui qui domine — et c'est précisément le régime où il est le plus coûteux à persister. D'où SWA Bounded Replay.
Chapitre suivant : Single-Pass mHC, Engram, DSpark